- Neviditelné škrtění se objevuje v CPU, hardwaru, síti a nástrojích a snižuje výkon bez zjevných chyb.
- V Kubernetes mohou omezení CPU a CFS omezit kontejnery a znásobit latenci, pokud jsou nesprávně nakonfigurovány.
- Tepelné škrcení a omezení rychlosti v WAF chrání hardware a služby, ale pokud jim není porozuměno, mohou způsobit zpomalení.
- Sledování specifických metrik a kontrola limitních politik je klíčem k doladění výkonu, zabezpečení a stability.
Když mluvíme o omezení výkonu nebo omezení výkonuMnoho lidí si vzpomene jen na chyby, pády nebo jasné varovné zprávy. Realita je ale mnohem jemnější: vaše aplikace, váš server nebo dokonce váš mobilní telefon se mohou zpomalovat, aniž by se v grafech nebo obvyklých senzorech dělo cokoli zdánlivě neobvyklého a aniž by vás systém přímo upozornil. Tomu se říká zpomalení systému. Neviditelné škrcení.
Tento typ chování není vždy způsoben chybou v kódu nebo špatnou architekturou, ale různými mechanismy... řízení zdrojů a ochrana proti přetížení Tyto mechanismy fungují „v zákulisí“: limity CPU v Kubernetes, tepelná ochrana v chytrých telefonech a noteboocích, omezení rychlosti v API nebo WAF, nebo dokonce audit konfigurací a nástrojů, jako je Lighthouse, které simulují pomalé sítě. Pochopení toho, jak všechny tyto typy omezení fungují, je klíčem k tomu, abyste se vyhnuli zahlcení hledáním úzkých míst tam, kde neexistují.
Co je neviditelné omezování a proč může zničit výkon, aniž by se projevilo?
Termín škrcení se obecně vztahuje na jakoukoli techniku, která záměrně snižuje rychlost zpracování systému k ochraně stability, zabezpečení nebo integrity hardwaru. Stává se „neviditelným“, když z pohledu uživatele nebo dokonce z pohledu monitorování neexistují žádné zjevné známky: nevidíte chyby, systém se nevypíná, CPU se zdá fungovat „dobře“, a přesto vše reaguje pomaleji než obvykle.
Tento jev se projevuje na několika úrovních: na úrovni infrastruktury a jádra (omezování výkonu CPU pomocí CFS a cgroups)K tomu dochází na úrovni hardwaru (tepelné škrcení v procesorech notebooků nebo chytrých telefonů), na úrovni sítě a aplikace (omezování rychlosti a řízení HTTP požadavků v API a WAF) nebo v nástrojích pro analýzu výkonu, kde se používají simulované síťové profily, které omezují šířku pásma a latenci.
Všechny tyto varianty sdílejí to, že jsou založeny na nějakém druhu omezovací zásady: CPU, teplota, provoz nebo zabezpečeníKdyž je tato hranice překročena, systém se „nezhroutí“, ale spíše se chrání snížením své rychlosti. Z pohledu vývojáře nebo administrátora je to často vnímáno jako extrémně nízký výkon, který je obtížné spojit se skutečným zdrojem problému.
Omezování výkonu CPU v Kubernetes: tichý nepřítel kontejnerů
V prostředí s KubernetesNejtypičtějším případem neviditelného škrcení je Omezení CPU způsobené limity nastavenými v kontejnerechV lokálním vývoji jde všechno hladce, ale při nasazení v produkčním clusteru trvají stejné procesy dvakrát nebo třikrát déle a nikdo nechápe proč, protože aplikace nehlásí chyby a na první pohled si s tím infrastruktura poradí.
Jádro problému spočívá v tom, jak Linux prostřednictvím cgroups a Zcela spravedlivý plánovač (CFS), interpretuje resources.limits.cpu které jsou definovány v podech. Kubernetes převádí tato omezení do dvou interních parametrů: cpu.cfs_period_us, který označuje časový interval v mikrosekundách, během kterého se měří využití CPU (obvykle 100 000 µs, tj. 100 ms), a cpu.cfs_quota_us, což udává, kolik mikrosekund CPU je kontejner oprávněn spotřebovat v každém období.
Například pokud přiřadíte kontejneru Limit 500 m (polovina jádra)Kubernetes nakonec nakonfiguruje cpu.cfs_quota_us přibližně 50 000 µs během periody 100 000 µs. V praxi to znamená, že proces může provádět intenzivní výpočty po dobu 50 ms a po vyčerpání této doby jej jádro nechá čekat, dokud nezačne další perioda. Z vaší aplikace uvidíte, že operace, kterou by bylo možné provést za 100 ms, je natažena přes několik period, což generuje latence, které se vůbec nepodobají těm, které vidíte lokálně.
Problém komplikuje dualita resources.requests.cpu obklad resources.limits.cpuI když požadavky na CPU pomáhají plánovači Kubernetes rozhodnout, na který uzel umístit pod, jsou to právě limity, které určují, kdy se spustí omezování. Pokud tyto parametry nesprávně nastavíte – například s příliš nízkými limity nebo bez zohlednění špičkových aktivit – váš kontejner stráví značnou část své životnosti „zastaven“ jádrem, i když se zvenčí může zdát, že CPU není ani na 100 %.
Tento typ omezení je zrádný, protože nemusí způsobit kritické selhání, ale něco mnohem horšího pro vnímání kvality: pomalé odezvy, dlouhé fronty a pocit, že systém je neustále trochu „zaseknutý“Monitorovací nástroj může ukazovat, že CPU není na globální úrovni uzlu saturováno, zatímco na úrovni cgroup kontejner neustále dosahuje nastaveného limitu.
Typy úloh a jak je ovlivňuje omezení CPU
Dopad škrcení není stejný pro všechna zatížení. V případě Webová API a služby citlivé na latenciJakékoli zpoždění způsobené vyčerpáním kvóty CPU má za následek výrazně horší dobu odezvy, časové limity klientů a trhaný zážitek. Nastavení příliš přísných limitů zde může být velmi nákladné.
Pro dávkové úlohyNa druhou stranu, omezování výkonu může být naprosto platným nástrojem: zabraňuje procesům na pozadí, aby zahlcovaly počítač, a dává praktickou prioritu interaktivním službám. Je přijatelné, aby analytická úloha trvala o něco déle, pokud to zajistí plynulý chod uživatelské části.
Mezi nejčastější příčiny vážných problémů s výkonem v důsledku omezení patří následující: nesprávně dimenzované limity CPUProblematické jsou také služby s nárazovým zatížením (které velmi rychle dosahují svého vrcholu) a fáze spouštění aplikací, které spotřebovávají hodně CPU v krátkém čase. To druhé je obzvláště nepříjemné: spuštění vaší služby v produkčním prostředí trvá věčnost, protože právě ve chvíli, kdy potřebuje nejvíce CPU, systém začne omezovat její výkon.
Jak detekovat a monitorovat omezení CPU pomocí Prometheusu
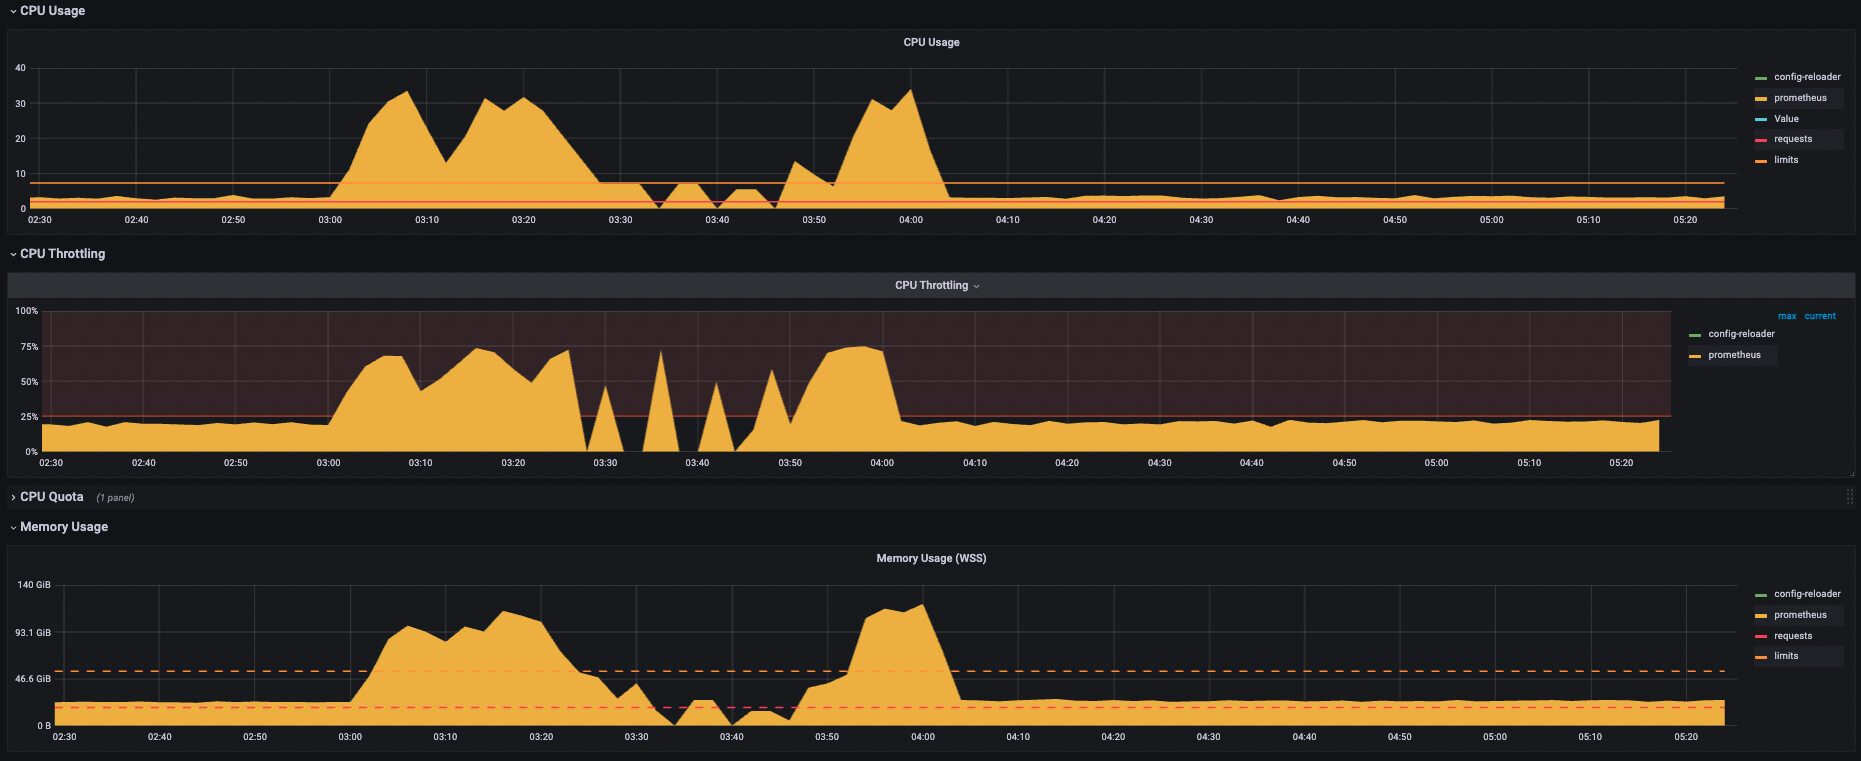
Aby tento nepřítel přestal být neviditelný, je nutné sledovat specifické metriky omezenínejen celkové využití CPU. S Prométheus A obvyklý zásobník pozorovatelnosti, na který se můžete spolehnout, je čítač jako container_cpu_cfs_throttled_seconds_total, který sčítá celkový čas v sekundách, po který byl kontejner uškrcen.
Velmi užitečným dotazem v PromQL je sečíst rychlost nárůstu tohoto čítače na pod za nedávné časové okno. Něco jako součet rychlosti omezení za posledních 5 minut Pro každý pod je vidět, kdo je aktivně omezován, i když se celkové využití CPU uzlu zdá být více než dostatečné a neposkytuje jasné vodítka.
Je také zajímavé vztáhnout celkový počet period CFS, které kontejner zažil, k tomu, kolik z těchto period zažilo omezení. Měření poměru mezi uškrcené menstruace a celkové menstruace V určitém okně (například 5 minut) můžete odhadnout procento času, po který se zátěž pokouší pracovat, ale nemůže kvůli stanovenému limitu.
Odtud je rozumné definovat upozornění, která se spustí při překročení prahové hodnoty omezení rozumné pro konkrétní pod nebo jmenný prostor. To vám umožňuje jednat proaktivně: upravovat limity, oddělovat úlohy, kontrolovat návrh aplikace nebo se rozhodnout, zda se vyplatí přidělit více CPU určitým službám oproti jiným.
Tepelné škrcení: když se hardware chrání snížením své rychlosti
Kromě kontejnerů a Kubernetes dochází k omezení také na fyzické úrovni. Procesory notebooků a moderní chytré telefony zahrnují mechanismy Tepelná ochrana, která snižuje taktovací frekvenci jakmile se blíží určitým teplotám, aby se zabránilo poškození. Je zajímavé, že tato ochrana se často aktivuje před dosažením teoretického limitu (T-junction), takže systém se zdá být v pořádku, ale funguje výrazně hůře.
Někteří uživatelé notebooků, například ti, kteří pracují se staršími modely ThinkPad, popisují situace, kdy se počítač po dosažení určité teploty základní desky – například kolem 80 °C na senzoru základní desky – začne přehřívat. viditelně pomalejší, i když monitorovací nástroje neukazují klasický stav škrceníHodiny se zdají být stabilní, systém správy napájení neukazuje zásadní změny, ale pocit tíhy je zřejmý.
V těchto případech se může jednat nejen o procesor, ale i o další interní limity stanovené výrobcem, související s teplotou základní desky, integrované grafické karty nebo dokonce napájecích komponent. Konečný výsledek je podobný: systém nenápadně „uvolní nohu z plynu“, aby se vyhnul překročení teplotního prahu, který by mohl ohrozit stabilitu nebo životnost zařízení.
U chytrých telefonů je tento jev běžně známý jako tepelné škrceníOperační systém a hardware spolupracují na snížení frekvence procesoru a grafické karty v případě nadměrné teploty – způsobené náročnými hrami, těžkými aplikacemi nebo jednoduše velmi horkým prostředím. Telefon se zahříváPokles výkonu, zasekávání her a aplikace, které dříve fungovaly plynule, začínají trpět.
Jak zabránit sklouzávání telefonu v důsledku horka
V každodenním používání je nejlepší obranou proti tepelnému škrtění na mobilních zařízeních použití selského rozumu. Jednoduché akce, jako například Nepoužívejte telefon během nabíjení Mohou výrazně snížit teplotu. Samotné nabíjení zahřívá baterii a napájecí obvod a pokud je procesor následně vytížen na hranici svých možností, tepelná rezerva velmi rychle mizí.
Je to také pohodlné Nepokládejte mobilní telefon na povrchy, které zadržují teplo.Povrchy jako matrace, deky nebo pohovky jsou běžné při hraní her nebo streamování náročného obsahu. Tyto povrchy brání odvodu tepla a problém zhoršují, zejména při dlouhém a intenzivním používání.
Další důležitou oblastí je správa softwaru. Mnoho aplikací běží na pozadí, spotřebovává CPU a RAM a tiše hromadí zdroje. Pravidelně zavírejte aplikace, které nepoužíváte. Uvolňuje kritické zdroje, které by jinak zbytečně zatěžovaly procesor., což přispívá k přehřátí terminálu a jeho dřívějšímu, než se očekávalo, omezení.
Pro hráče dává úprava kvality grafiky dokonalý smysl. Snižte rozlišení, vypněte stíny a speciální efekty nebo zvolte střední výkonnostní profily místo vysokého. snižuje zátěž CPU a GPUTo pomáhá udržovat stabilnější snímkovou frekvenci a snižuje pravděpodobnost, že telefon bude muset uprostřed hry snížit výkon.
Omezování a škrcení rychlosti v síťové vrstvě a webových aplikacích
Koncept throttlingu se neomezuje pouze na CPU nebo teplotu: ve webovém světě se používá také k označení Omezení nebo omezování rychlosti HTTP požadavků Toto se týká zásad, které omezují počet požadavků, které může klient v daném časovém období odeslat na webovou stránku nebo API. Tento limit se obvykle uplatňuje na IP adresu, na soubor cookie, na klíč API nebo na identifikátor uživatele.
Cíl těchto politik je dvojí. Na jedné straně, chránit dostupnost platformy To pomáhá předcházet zneužívání, automatizovaným procesům nebo botům, kteří odesílají příliš mnoho požadavků v krátkém období a potenciálně přetěžují infrastrukturu. Přispívá to také k bezpečnosti zmírňováním útoků hrubou silou, hádání přihlašovacích údajů a dalších taktik, kdy útočník testuje přihlašovací údaje nebo zneužívá formuláře v plné rychlosti.
V praxi mnoho CDN a WAF integruje mechanismy omezování rychlosti, které umožňují definovat pravidla, jako například „N požadavků za sekundu na klienta“ nebo „M POST požadavků za minutu na uživatele“. Po překročení prahové hodnoty jsou nové požadavky blokovány nebo se na ně reaguje chybou… HTTP kód 429 (Příliš mnoho požadavků)nebo dokonce s vlastními kódy v závislosti na zásadách platformy.
Klasickým příkladem jsou sociální sítě, které pro snížení zátěže své infrastruktury definují maximální míru využití pro každý účet, bez ohledu na to, zda k němu uživatel přistupuje z oficiální aplikace nebo z klientů třetích stran. Pokud uživatel používá několik aplikací připojených ke stejnému účtu, může dosáhnout limitu rychleji než někdo, kdo používá pouze hlavní aplikaci, a z jeho pohledu by toto omezení mohl interpretovat jako problém s výkonem, i když ve skutečnosti jde o... kontrolní a ochranná opatření.
Pokročilá konfigurace omezení rychlosti v WAF
V pokročilých řešeních WAF a CDN je limit rychlosti obvykle definován pomocí specifických příkazů v konfiguraci. Je běžné se setkat se syntaxí, kde název pravidla, maximální počet požadavků, časové období a volitelné parametry například doba trvání bloku nebo aktivace CAPTCHA.
V typickém scénáři se můžete omezit například na 20 požadavků za sekundu a IP adresaJakmile je této hodnoty dosaženo, klient je na 30 sekund zablokován a je povinen vyřešit CAPTCHA, aby prokázal, že se nejedná o bot. WAF tuto logiku zvládá a aplikační server dostává mnohem méně zneužívajících požadavků.
Výsledkem je, že uživateli nebo vývojáři, který není s pravidly obeznámen, se zdá, že web se stal vrtošivým: některé požadavky jsou zpracovány, jiné ne a někdy vše reaguje pomaleji než obvykle. Ve skutečnosti se ale děje... regulace plynulosti dopravy Pro ochranu infrastruktury: jedná se o úmyslné omezení sítě, které je pro stabilitu systému stejně důležité jako omezení CPU nebo tepelné omezení hardwaru.
Tyto typy mechanismů také pomáhají omezovat náklady v cloudových prostředích a zabraňují zneužívání zdrojů, které by mohlo způsobit prudké zvýšení spotřeby zdrojů. Během auditů a penetračních testů je běžné najít API, která by bez dostatečného omezení rychlosti mohla být masivně zneužita až do bodu... způsobit neudržitelnou ekonomickou spotřebu nebo vyřadit organizaci z provozu.
Omezování nástrojů pro audit výkonnosti: případ Lighthouse
K další, někdy přehlížené formě neviditelného omezování dochází, když se k hodnocení výkonu webových stránek používají analytické nástroje, jako je Lighthouse. Tyto nástroje integrují uživatelské profily. pomalá simulace sítě a omezení výkonu CPU reprodukovat realistické scénáře uživatelů se skromnými zařízeními nebo špatným připojením.
Pokud nejsou parametry při spuštění Lighthouse správně nastaveny, je možné, že síťové nebo emulované omezení CPU což neodpovídá měřenému. Simulace může být například ve výchozím nastavení vynucena pro mobilní zařízení s pomalým 3G připojením, zatímco cílem analýzy je výkon stolního počítače s dobrým připojením.
V těchto případech, i když skutečná aplikace není v produkčním prostředí omezována, Zprávy Lighthouse budou ukazovat mnohem horší doby načítání a metriky uživatelské zkušenosti. toho, co se v praxi pozoruje. Pro správnou interpretaci výsledků a pro to, aby se testovací prostředí nezaměnilo s realitou, je nezbytné prozkoumat možnosti, jako je emulovaný formát (mobilní nebo stolní) a zakázat omezení sítě, když to není potřeba.
Pokud konfigurační příkazy Lighthouse nereagují podle očekávání, může to být způsobeno nekompatibilitou verzí, chybně napsanými parametry příkazového řádku nebo výchozími profily, které přepisují část konfigurace. Základní myšlenka v každém případě zůstává stejná: Omezování je užitečný nástroj pro testování a ochranuPokud však není správně pochopen, může to vést k nesprávným diagnózám ohledně skutečného výkonu aplikace.
Všechny tyto scénáře – omezení CPU pomocí CFS, tepelná ochrana hardwaru, omezení rychlosti v WAF a omezení v auditních nástrojích – nakonec poukazují na stejnou myšlenku: moderní systémy se neustále spoléhají na… mechanismy sebekontroly, které záměrně snižují výkonTeprve když jsou detailně pochopeny, přestanou být „neviditelné“ a stanou se pákami, které můžete upravit ve svůj prospěch, abyste našli rozumnou rovnováhu mezi výkonem, bezpečností, stabilitou a náklady.

Redaktor specializovaný na problematiku technologií a internetu s více než desetiletými zkušenostmi v různých digitálních médiích. Pracoval jsem jako editor a tvůrce obsahu pro e-commerce, komunikaci, online marketing a reklamní společnosti. Psal jsem také na weby o ekonomice, financích a dalších odvětvích. Moje práce je zároveň mou vášní. Nyní prostřednictvím mých článků v Tecnobits, snažím se prozkoumat všechny novinky a nové možnosti, které nám svět technologií každý den nabízí, abychom zlepšili náš život.