- Maia 200 ist Microsofts KI-Inferenzbeschleuniger der zweiten Generation, hergestellt im 3-nm-Verfahren und mit über 140.000 Milliarden Transistoren.
- Der Chip bietet bis zu 10 PFLOPS in FP4, 5 PFLOPS in FP8 und 216 GB HBM3e-Speicher, wobei die Effizienz pro Euro/Dollar gegenüber Trainium und TPU priorisiert wird und er mit Nvidia konkurriert.
- Es ist in die Azure-Infrastruktur integriert, um Copilot, OpenAI-Modelle und fortgeschrittene interne Projekte zu bedienen, mit anfänglicher Bereitstellung in der Region US Central und schrittweiser Erweiterung.
- Es ist Teil einer „Silicon-to-Service“-Strategie, um die Strukturkosten zu senken, technologische Unabhängigkeit zu erlangen und Microsofts Position im KI-Silicon-Krieg zu stärken.

Microsoft hat mit einem neuen Schritt in seiner Strategie für die Infrastruktur künstlicher Intelligenz begonnen. Maia 200, sein Inferenzbeschleuniger der zweiten GenerationDer Chip soll das Angebot von Azure angesichts des Booms generativer KI stärken und ganz nebenbei die starke Abhängigkeit des Unternehmens von Nvidia und anderen externen Anbietern verringern.
Maia 200 ist weit mehr als nur eine weitere Komponente; sie präsentiert sich als Kernstück eines integrierten Modells, das von Silizium bis zu Cloud-Diensten reichtDas Ziel ist klar: groß angelegte Sprachmodelle und fortgeschrittene Schlussfolgerungssysteme mit höherer Leistung pro investiertem Euro zu betreiben und gleichzeitig die Betriebskosten in den Rechenzentren maximal zu kontrollieren.
Ein Beschleuniger, der für massive Inferenz entwickelt wurde.
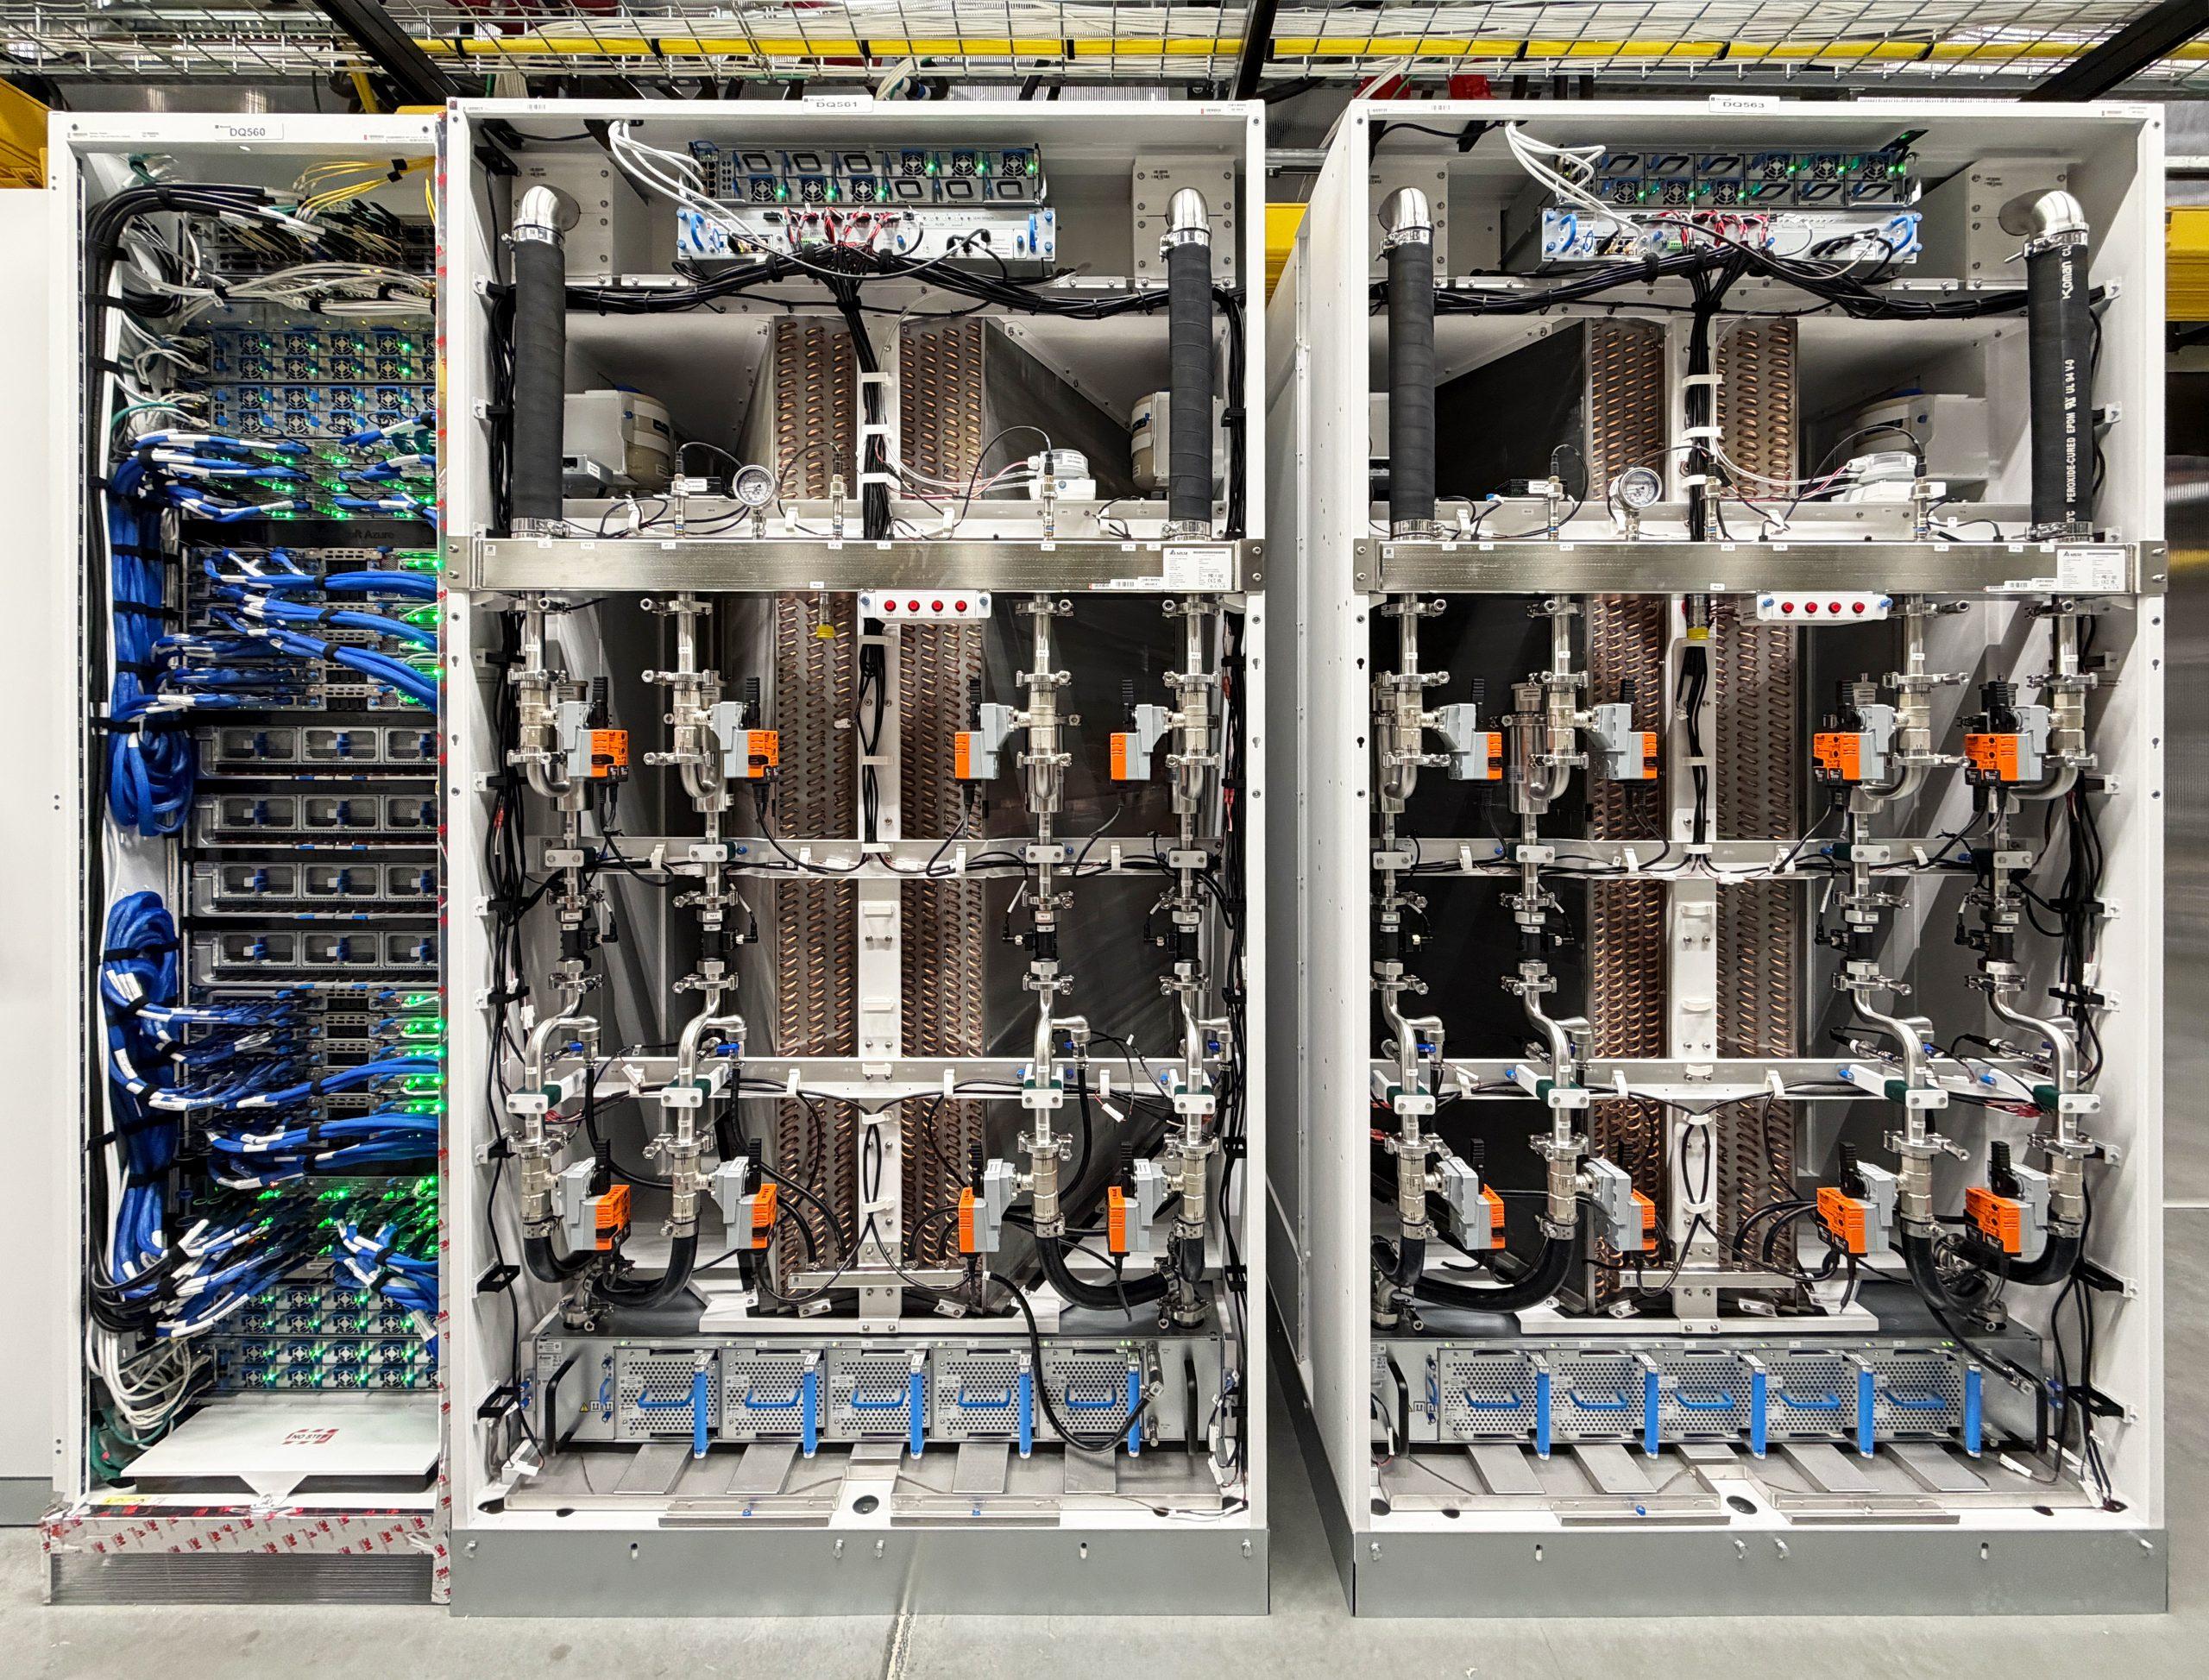
Maia 200 ist speziell für die Inferenzphase von Modellen der künstlichen IntelligenzDies bezeichnet den Moment, in dem vortrainierte Systeme Anfragen verarbeiten und Echtzeitantworten generieren. Hier konzentrieren sich täglich Millionen von Anfragen nach Diensten wie Assistenten, Unternehmens-Chatbots und KI-gestützten Produktivitätstools.
Das Unternehmen definiert Maia 200 als das effizienteste Inferenzsystem, das jemals auf Azure eingesetzt wurdeLaut ihren internen Daten bietet der Chip bis zu 30 % mehr Leistung pro Dollar (bzw. pro Euro) als die bisherige Hardware in ihrem Gerätepark – ein Schlüsselfaktor, wenn das Abfragevolumen exponentiell wächst und die Energiekosten den Margendruck weiter nach unten ziehen.
Der neue Beschleuniger ersetzt effektiv Maia 100, die erste Generation dieser BauartDiese Lösung wurde Kunden nie zur Verfügung gestellt. Mit Maia 200 geht Microsoft vom Laborexperiment zur realen Implementierung in seinen Rechenzentren über und integriert die Plattform in hochgradig sichtbare Geschäftsdienste.
In diesem Kontext passt das Bekenntnis zu proprietärer Hardware zum allgemeinen Trend großer Cloud-Anbieter, die suchen Vermeiden Sie es, sich ausschließlich auf Nvidia zu verlassen. und gleichzeitig sein Angebot von Wettbewerbern wie Google (TPU) oder Amazon Web Services (Trainium und Inferentia) abzugrenzen, und angesichts von Problemen wie GPU-Verzögerungen.
Architektur und Fertigungsprozess: 3 nm und mehr als 140.000 Milliarden Transistoren
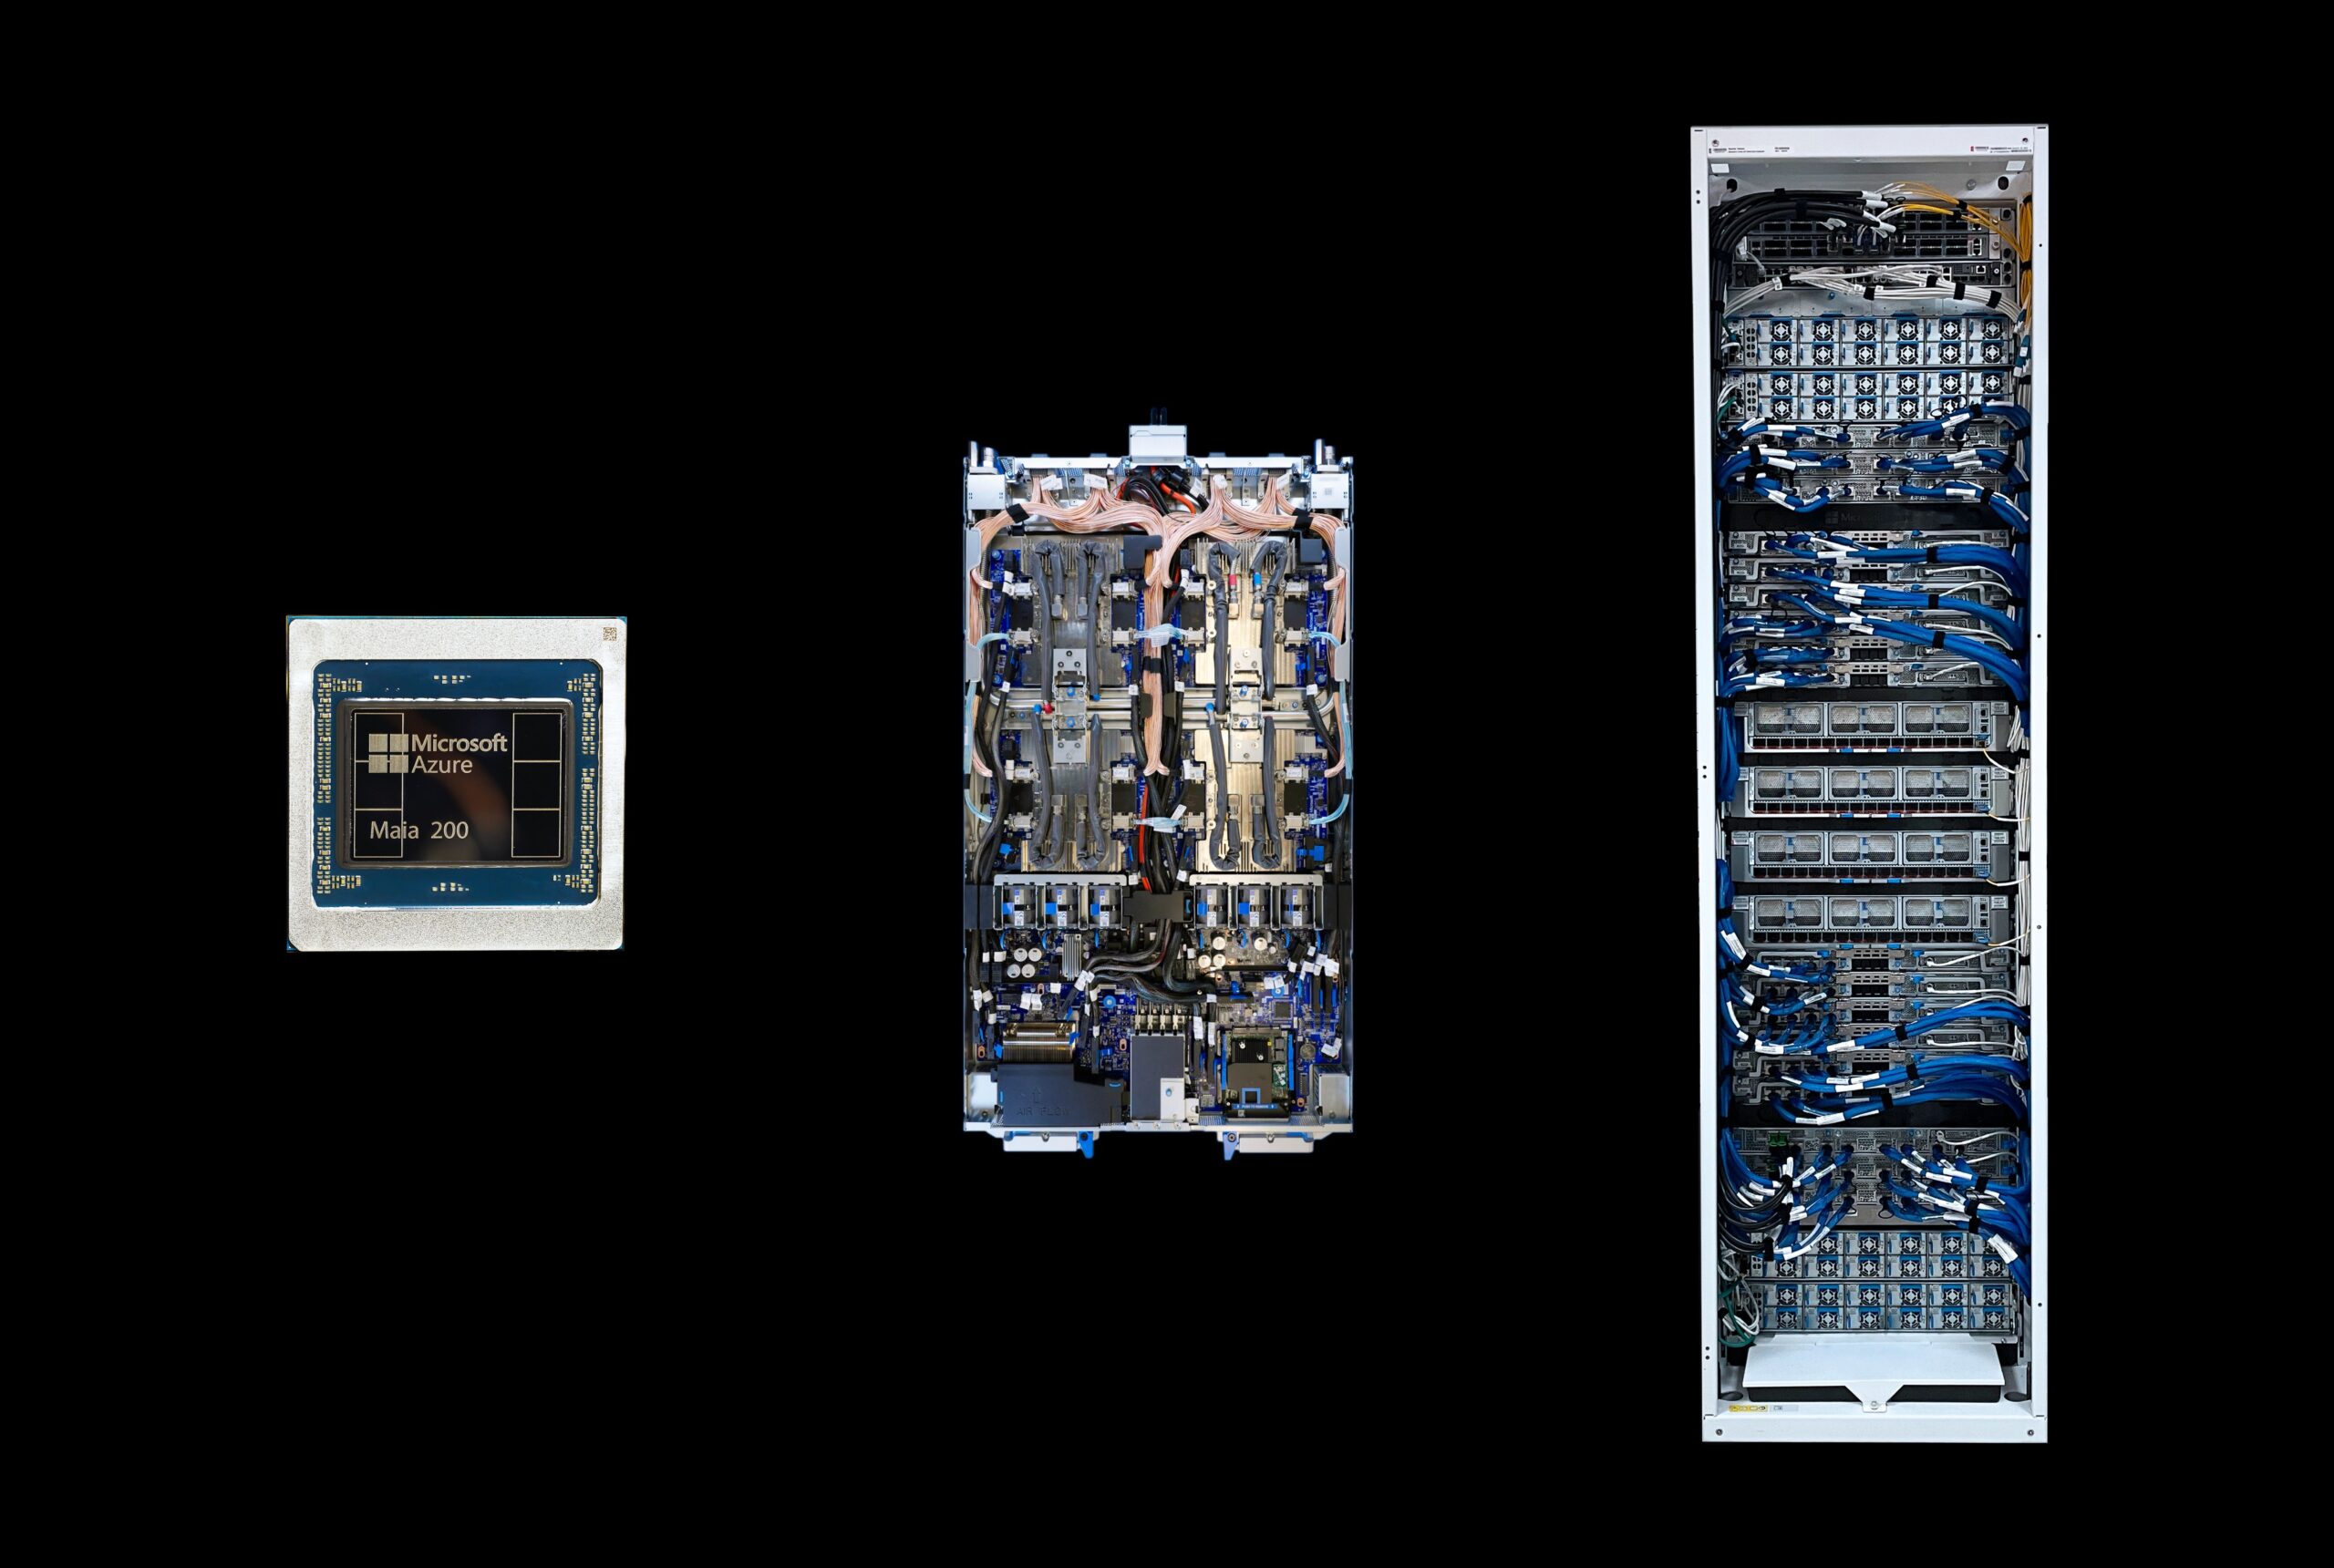
Auf technischer Ebene basiert Maia 200 auf dem Prozess der TSMC 3 Nanometer (N3P-Knoten), eine der fortschrittlichsten Technologien, die heute in Serie gefertigt werden können. Jeder Chip integriert in der Größenordnung von 140.000 Milliarden Transistoren, ein Sprung in der Komplexität, der den Umfang der aktuellen KI-Modelle und die Arbeitslasten widerspiegelt, die in den kommenden Jahren zu bewältigen sein werden.
Die interne Architektur basiert auf einer Rechnerhierarchie, deren grundlegendes Element der sogenannte Rechner ist. "Fliese"Die Kachel fungiert als autonome Einheit mit lokalen Rechen- und Speicherkapazitäten. Jede Kachel enthält zwei Hauptkomponenten: zum einen die Tile Tensor Unit (TTU), konzentrierte sich auf hochperformante Matrixmultiplikationen und Faltungsoperationen; andererseits die Tile Vector Processor (TVP), eine hochgradig programmierbare SIMD-Engine für Aufgaben, die eine größere Flexibilität erfordern.
Mehrere Kacheln sind gruppiert in Cluster mit gemeinsam genutztem SRAM-SpeicherDies führt zu einer zweiten Ebene der Datenlokalität. Diese Organisation ermöglicht eine effiziente Koordination der Ausführung über mehrere Tiles hinweg, bevor die Skalierung auf die gesamte System-on-a-Chip-Ebene erfolgt, wodurch Engpässe reduziert und die Hardwareauslastung verbessert wird.
Das Speichersubsystem, einer der Schlüssel zur KI-Leistung, wurde so konzipiert, dass Minimieren des externen Datenverkehrs und Entlasten der BandbreiteDie Grundidee ist einfach, wenn auch nicht trivial in der Umsetzung: Man platziert so viel schnellen Speicher wie möglich in der Nähe der Berechnungsstelle, damit die Modelle nicht ständig auf das Eintreffen der Daten warten müssen.
Speicher, Präzisionsformate und Leistung in PFLOPS
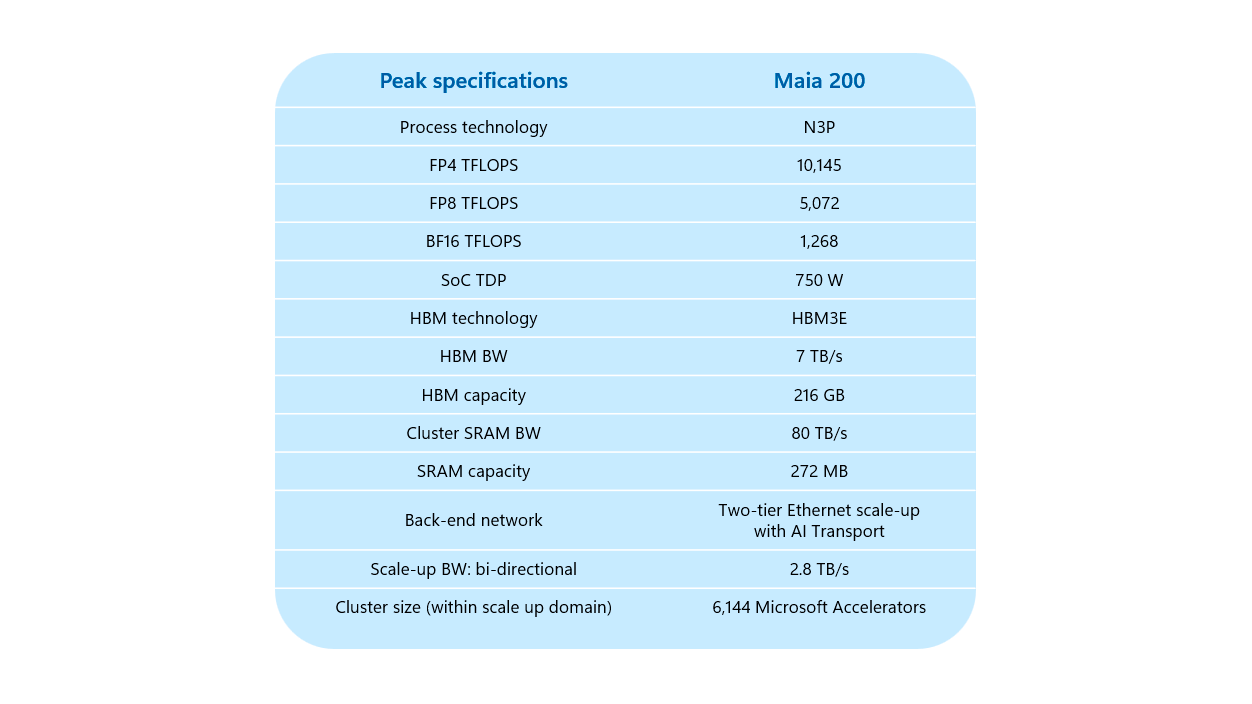
Eines der charakteristischen Merkmale der Maia 200 ist die Kombination aus integriertem und sehr schnellem externem Speicher. Der Chip selbst umfasst 272 MB SRAMverteilt auf verschiedene Ebenen (TSRAM in jeder Kachel und CSRAM in jedem Cluster). Dieses SRAM wird von Software verwaltet, was eine detaillierte Steuerung der Datenlokalität entsprechend der Arbeitslast.
Diese Blöcke sind zusätzlich zu 216 GB HBM3e-Speicher, ein nahezu rechenintensives Volumen, das insbesondere für groß angelegte Sprachmodelle relevant ist und dessen Kosten zusammen mit den Preis für GDDR6-Speicher.
Hinsichtlich der Rechenleistung gibt Microsoft an, dass der Chip optimiert ist für Formate mit niedriger Präzision wie FP4 und FP8Dies ermöglicht eine höhere Leistung bei gleichzeitiger Beibehaltung einer Ergebnisqualität, die für viele Anwendungen im Bereich generativer KI und Schlussfolgerungen geeignet ist. Maia 200 erreicht etwa 10 PFLOPS in FP4 und 5 PFLOPS in FP8, zusätzlich zu ihrer Lage in der Nähe 1,3 PFLOPS in BF16.
Die Leistung im FP4 würde laut Unternehmensangaben wie folgt aussehen: achtmal größer als die von BF16 und etwa doppelt so groß wie die von FP8 Unter sonst gleichen Bedingungen führt dies zu deutlichen Gewinnen bei der Anzahl der pro Sekunde verarbeiteten Token – ein entscheidender Faktor in Szenarien, in denen Millionen von Nutzern gleichzeitig Text-, Code- oder Multimedia-Inhalte generieren.
Mit einem TDP von etwa 750 W pro DrosselklappeDer Maia 200 ist im oberen Verbrauchsbereich der Rechenzentrumschips positioniert, kompensiert dies jedoch mit einem Leistungs-/Energieverhältnis, das Microsoft als einen seiner Hauptvorteile gegenüber konkurrierenden Alternativen darstellt.
Konnektivität, Skalierbarkeit und das KI-Transportschichtprotokoll
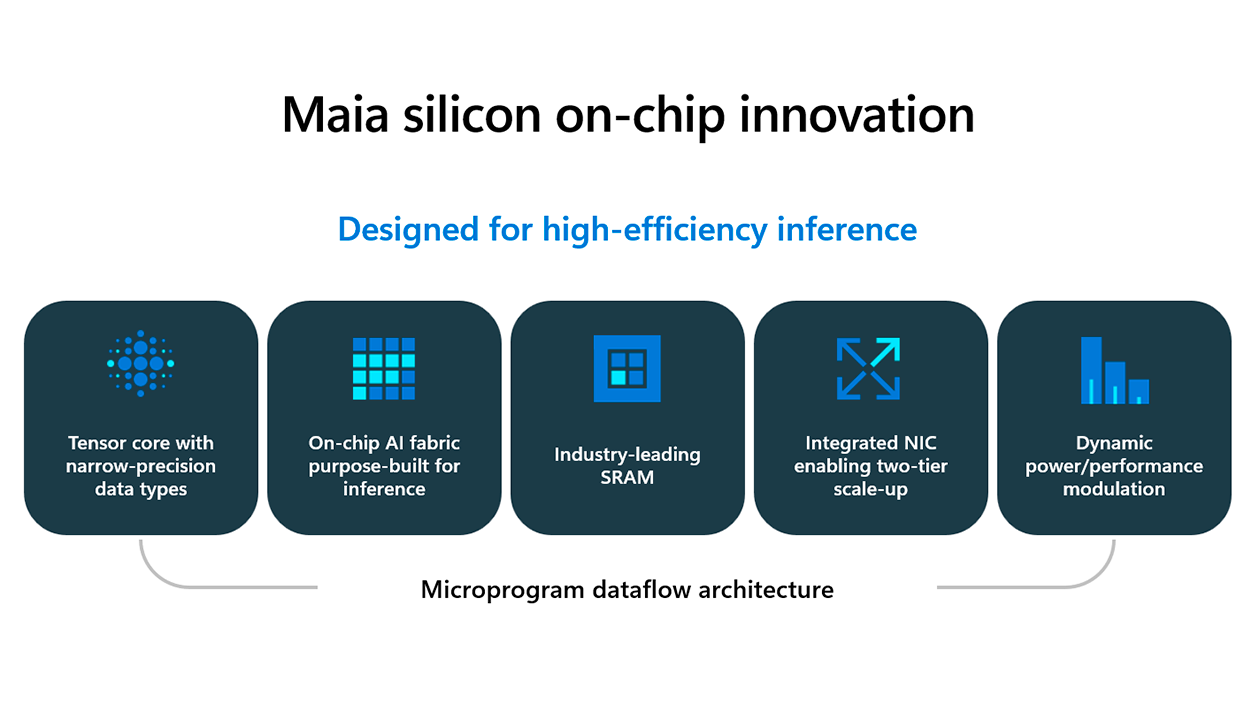
Neben der reinen Rechenleistung verfügt Maia 200 über eine fortschrittliche Netzwerkschicht, die für Folgendes unerlässlich ist: Skalierung auf Tausende von parallel arbeitenden BeschleunigernDer Chip integriert seine eigene Netzwerkkarte in das Silizium, mit einer bidirektionalen Bandbreite von ungefähr 2,8 TB/sDadurch entfällt die Notwendigkeit externer Karten für eine leistungsstarke Kommunikation.
Die Kommunikation zwischen den Knoten wird durch ein spezifisches Protokoll ermöglicht, das heißt KI-Transportschicht (ATL)ATL läuft auf einer Standard-Ethernet-Infrastruktur. ATL führt Techniken wie Packet Spraying (Verteilung von Paketen über mehrere Pfade) und Multipoint-Routing ein. Stabilität verbessern und Staus reduzieren in stark frequentierten Szenarien, wie sie typisch für generative KI sind.
Ein weiteres relevantes Element ist das sogenannte Vollständig vernetztes Quad (FCQ)Diese Topologie gruppiert vier Maia-200-Beschleuniger über direkte Verbindungen ohne externe Switches. Dieser Ansatz reduziert die Latenz bei der Tensor-Kommunikation und vereinfacht den Aufbau modularer Blöcke, die sich anschließend skalieren lassen.
Laut Microsoft ermöglicht diese Architektur eine Skalierung bis zu Cluster von 6.144 Maia 200-Beschleunigern, eine Kennzahl, die den Trainings- und Inferenzanforderungen größerer Modelle, einschließlich zukünftiger Generationen multimodaler Sprachmodelle, entspricht.
In der Praxis wird der Chip montiert auf Tabletts oder Gestelle, die Sätze mehrerer Beschleuniger aufnehmenDies erleichtert die Integration in bestehende Rechenzentren. Das Unternehmen hat das System so konzipiert, dass es sowohl mit Luftkühlung als auch mit fortschrittlicheren Flüssigkeitskühllösungen betrieben werden kann und sich somit an verschiedene Infrastrukturkonfigurationen anpassen lässt.
Integration mit Azure-, Copilot- und OpenAI-Modellen
Maia 200 kommt nicht allein auf den Markt, sondern als Teil eines Ansatzes, den Microsoft wie folgt definiert: „Vom Silizium zum Service“Die Idee ist, dass Hardware, Software, Netzwerke und Modelle gemeinsam entwickelt und optimiert werden, um die Leistung zu maximieren und die Betriebskosten zu minimieren.
Die ersten Systeme auf Basis von Maia 200 werden bereits eingesetzt in der Azure-Region USA MitteDiese ersten Cluster speisen fortschrittliche Modelle des Microsoft Superintelligence-Teams, Initiativen von Microsoft Foundry mit Fokus auf die Erstellung und Skalierung kundenspezifischer Modelle und vor allem Microsoft Copilot, die Familie der Assistenten, die in Anwendungen wie Microsoft 365 integriert sind.
Das Unternehmen zielt darauf ab, direkte Unterstützung anzubieten für Modelle der nächsten Generation, einschließlich GPT-5.2 von OpenAI., im Einklang mit der strategischen Allianz, die beide Unternehmen seit der Gründung von ChatGPT unterhalten. Die Verbesserung der Latenz und der Kosten pro Anfrage sollte sich in Folgendem niederschlagen: schnellere und nachhaltigere groß angelegte Reaktionen für diese Dienstleistungen.
Über die Vereinigten Staaten hinaus ist geplant, Maia 200 auszuweiten auf andere Azure-Regionen, einschließlich europäischer RegionenSobald das Verhalten, die Effizienz und die Stabilität des Systems im Produktionsbetrieb validiert sind, wird es für Unternehmen und Regierungsbehörden in der EU wichtig sein, zu beobachten, wann diese Beschleuniger in lokalen Rechenzentren eingesetzt werden, da Bedenken hinsichtlich der Datensouveränität und der Einhaltung gesetzlicher Bestimmungen bestehen.
Parallel dazu ist der Chip in ein Ökosystem von Entwicklungswerkzeugen integriert, das vermeiden soll, dass Programmierer ihre Gewohnheiten über Nacht ändern müssen, und so die Integration in bestehende Projekte erleichtert.
Werkzeuge für Entwickler und das Software-Ökosystem
Um sicherzustellen, dass Maia 200 nicht nur ein internes Entwicklungsprojekt bleibt, begleitet Microsoft die Markteinführung mit einer Ein spezielles SDK, das sich an Unternehmen, Universitäten und Open-Source-Projekte richtet.Ziel ist es, eine technische Community zu schaffen, die die Fähigkeiten des Chips voll ausschöpft und zur Optimierung der Arbeitslasten beiträgt.
Die Entwicklungsumgebung wahrt die Kompatibilität mit gängige Tools wie PyTorchDies ermöglicht die Portierung bestehender Modelle mit überschaubarem Aufwand. Compilerunterstützung wird ebenfalls bereitgestellt. TritonEntwickelt, um die Hardwarefunktionen voll auszuschöpfen, ohne dabei eine Sprache zu opfern, die für diejenigen, die bereits mit GPUs und Beschleunigern arbeiten, relativ zugänglich ist.
Für Teams, die eine feinere Steuerung benötigen, stellt Microsoft die entsprechende Sprache zur Verfügung. Verschachtelte Parallelsprache (NPL)Entwickelt, um die Kachel-, Cluster- und lokale Speicherhierarchie des Chips optimal zu nutzen. Dieser eher „metallische“ Ansatz zielt auf maximale Optimierung ab. Datenlokalität und Parallelisierung kritischer Routinen.
In der Praxis zielt diese Kombination von Abstraktionsebenen darauf ab, sowohl große Konzerne als auch akademische Forschungsgruppen Sie können ihre Modelle an die neue Hardware anpassen, ohne von Grund auf neu beginnen zu müssen. Das Unternehmen hat angekündigt, dass einige Early-Access-Programme bereits Universitäten und Forschungsteams ansprechen, um die Einführung zu beschleunigen.
Damit versucht Microsoft, Maia 200 nicht nur als proprietären Beschleuniger, sondern als einen umfassenden Technologie-Beschleuniger wahrzunehmen. grundlegender Baustein in einem offenen und relativ vertrauten Software-Ökosystem für die KI-Community.
Wirtschaftliche und strategische Auswirkungen und der Siliziumkrieg
Auf wirtschaftlicher Ebene ist die Entwicklung von Maia 200 Teil eines umfassenderen Kampfes um die Kontrolle der Infrastruktur, die generative KI unterstütztJede Abfrage, die über Copilot, ein auf Azure gehostetes OpenAI-Modell oder eine KI-Unternehmensanwendung läuft, verursacht Kosten, die im Wesentlichen von der verwendeten Hardware abhängen.
Mit einem eigenen Inferenzchip strebt Microsoft Folgendes an Reduzierung der Strukturkosten, Erhöhung der Vorhersagbarkeit der Ausgaben und Stärkung der Verhandlungsposition gegenüber externen LieferantenWenn sich das Versprechen einer 30% höheren Leistung pro Dollar in der Produktion konsequent bewahrheitet, könnte das Unternehmen seine Margen im Bereich KI-Dienstleistungen deutlich verbessern.
Diese Strategie besitzt auch eine geopolitische und technologische Souveränitätsdimension. Zu einer Zeit, in der Europa und andere Regionen debattieren über digitale Autonomie und Datenkontrolle.Die Integration eigener Hardware in eine globale Cloud stärkt Microsofts Position als Technologiepartner für große Unternehmen und öffentliche Verwaltungen.
Die Einführung von Maia 200 ergänzt die Schritte von Google mit seinen TPUs und von Amazon mit Trainium und Inferentia – was viele Analysten bereits als echten „Siliziumkrieg“Die Führungsrolle in diesem Wettstreit bemisst sich nicht nur an der Anzahl der PFLOPS, sondern an der Fähigkeit, langfristig eine leistungsstarke, effiziente und wirtschaftlich tragfähige KI bereitzustellen.
Aktuell dominiert Nvidia weiterhin den Markt für KI-Beschleuniger, doch die Bestrebungen der großen Cloud-Anbieter, eigene Chips zu entwickeln, deuten auf ein Szenario hin, in dem stärkere Diversifizierung und Wettbewerb, in dem jeder Akteur versuchen wird, so viel wie möglich von der Wertschöpfungskette zu kontrollieren, vom Siliziumdesign bis hin zu den von den Nutzern verwendeten Endanwendungen.
Mit Maia 200 erweitert Microsoft sein Portfolio nicht nur um einen neuen Beschleuniger, sondern stärkt auch eine grundlegende Strategie, die sich auf Kontrolle der gesamten KI-Infrastruktur und Feinabstimmung der Ökonomie der InferenzDie Kombination aus 3-nm-Design, massivem HBM3e-Speicher, integriertem Netzwerk mit hoher Kapazität und enger Integration mit Azure-, Copilot- und OpenAI-Modellen positioniert diesen Chip als Schlüsselelement im Wettlauf um generative KI, bei der die Kosten pro Abfrage und die Energieeffizienz ebenso entscheidend sein werden wie die reine Rechenleistung selbst.

Index
- 1 Ein Beschleuniger, der für massive Inferenz entwickelt wurde.
- 2 Architektur und Fertigungsprozess: 3 nm und mehr als 140.000 Milliarden Transistoren
- 3 Speicher, Präzisionsformate und Leistung in PFLOPS
- 4 Konnektivität, Skalierbarkeit und das KI-Transportschichtprotokoll
- 5 Integration mit Azure-, Copilot- und OpenAI-Modellen
- 6 Werkzeuge für Entwickler und das Software-Ökosystem
- 7 Wirtschaftliche und strategische Auswirkungen und der Siliziumkrieg

Ich bin ein Technik-Enthusiast, der seine „Geek“-Interessen zum Beruf gemacht hat. Ich habe mehr als 10 Jahre meines Lebens damit verbracht, modernste Technologie zu nutzen und aus purer Neugier an allen möglichen Programmen herumzubasteln. Mittlerweile habe ich mich auf Computertechnik und Videospiele spezialisiert. Das liegt daran, dass ich seit mehr als fünf Jahren für verschiedene Websites zum Thema Technologie und Videospiele schreibe und Artikel erstelle, die Ihnen die Informationen, die Sie benötigen, in einer für jeden verständlichen Sprache vermitteln möchten.
Bei Fragen reicht mein Wissen von allem rund um das Windows-Betriebssystem bis hin zu Android für Mobiltelefone. Und mein Engagement gilt Ihnen, ich bin immer bereit, ein paar Minuten zu investieren und Ihnen bei der Lösung aller Fragen in dieser Internetwelt zu helfen.