- Jan AI vous permet d'exécuter localement des modèles de langage GGUF tout en garantissant une confidentialité totale des données.
- Le logiciel propose plusieurs méthodes d'importation, depuis son Hub intégré jusqu'au téléchargement de fichiers locaux ou de liens Hugging Face.
- L'outil détecte automatiquement les métadonnées du modèle, ce qui facilite la configuration de l'architecture et du modèle de chat.
Si l'intelligence artificielle vous intéresse mais que vous ne souhaitez pas envoyer vos conversations et documents privés sur des serveurs externes, Jan AI offre une alternative très intéressante. Il s'agit d'un assistant de bureau gratuit et open source qui permet exécuter des modèles de langage directement sur l'ordinateur.
L'un de ses plus grands avantages est sa compatibilité avec Modèles au format GGUF utilisant llama.cppCela vous permet de télécharger des modèles quantifiés, de tirer parti du processeur et de la carte graphique de l'ordinateur, et de les utiliser même sans connexion Internet.
En pratique, Jan peut se transformer en une sorte de ChatGPT privé et personnalisable. Cependant, le niveau de confidentialité dépend des paramètres que vous choisissez. Les modèles locaux traitent les données sur l'appareiltandis que les connexions avec OpenAI, Anthropic ou d'autres fournisseurs externes envoient des requêtes à leurs serveurs.

Ce dont vous avez besoin avant d'importer un modèle GGUF
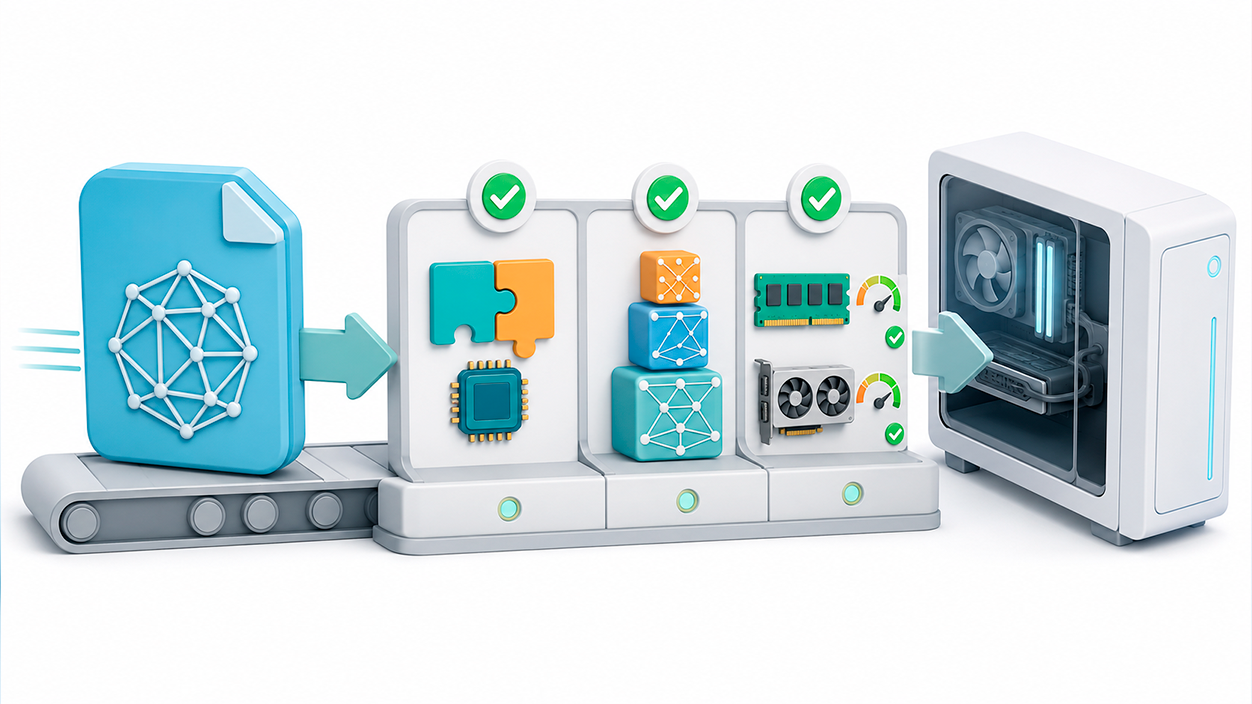
Avant de télécharger le premier modèle trouvé, il est conseillé de vérifier sa compatibilité avec llama.cpp et sa taille, afin qu'elle tienne dans la mémoire disponible. Les dépôts Hugging Face proposent souvent plusieurs quantifications d'un même modèle, comme Q4_K_M, Q5_K_M ou Q8_0.
La quantification réduit la taille des chargements de données et permet d'exécuter des modèles volumineux sur des machines moins puissantes. En règle générale, Q4_K_M offre un bon équilibre entre qualité, consommation de mémoire et vitessetandis que Q5_K_M et Q8_0 conservent une précision légèrement supérieure en échange d'un encombrement plus important et d'un besoin accru de RAM ou de VRAM.
Il est également conseillé de vérifier l'architecture du modèle. Bien que llama.cpp prenne en charge un grand nombre de familles, les modèles récemment publiés peuvent nécessiter une version plus récente du moteur. Si le fichier ne se charge pas, cela ne signifie pas forcément qu'il est corrompu. Le système dorsal installé en janvier pourrait ne pas encore reconnaître son architecture..
Téléchargez des modèles depuis le hub de Jan
La méthode la plus simple pour ajouter un modèle est d'utiliser le Le centre intégré de JanDans cette section, vous pouvez rechercher des modèles, consulter les variantes disponibles et télécharger la quantification la plus adaptée à votre ordinateur.
Une fois le téléchargement lancé, Jan affiche le modèle et le pourcentage d'avancement dans l'indicateur situé en haut de l'écran. Le processus peut être annulé et, en cas d'erreur, il suffit d'appuyer à nouveau sur le bouton de téléchargement pour réessayer.
Cette méthode est particulièrement recommandée aux débutants car Jan s'occupe de Enregistrez le fichier et préparez la configuration nécessaire.Une fois le téléchargement terminé, le modèle apparaîtra dans le sélecteur de chat et vous pourrez le charger pour commencer à l'utiliser.
Importez un modèle Hugging Face en utilisant son ID
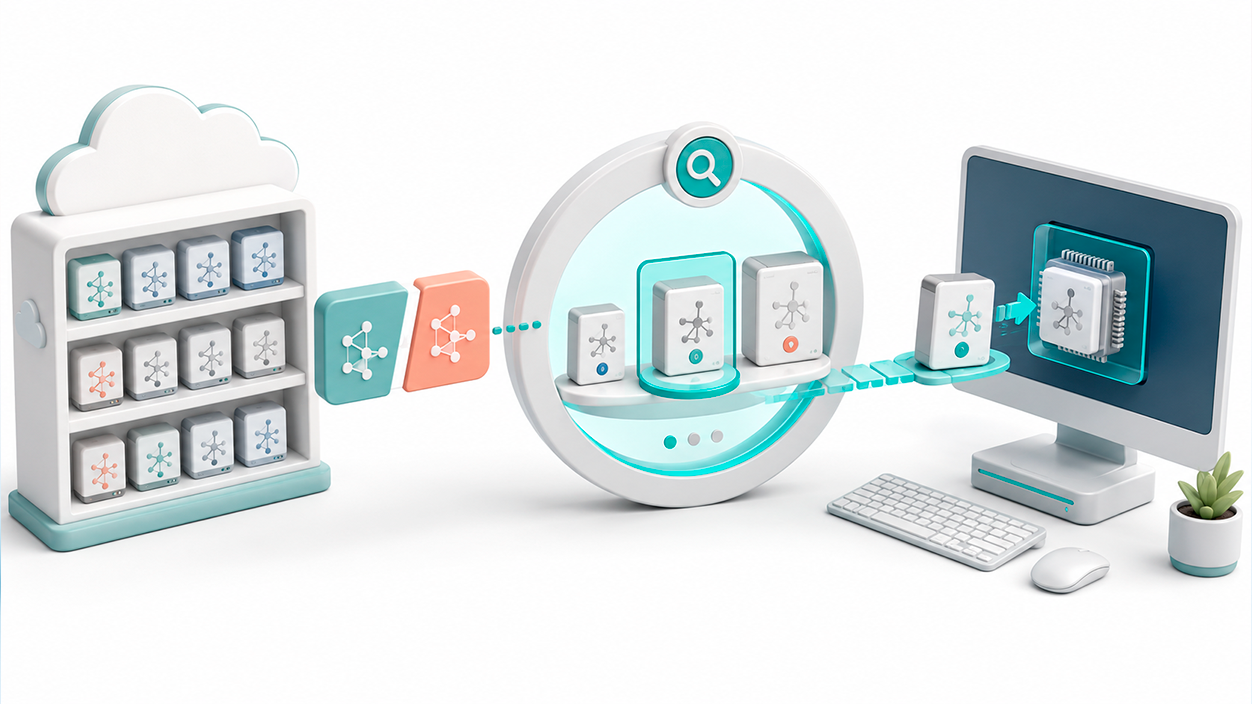
Le Hub vous permet également de localiser les modèles disponibles sur Hugging Face grâce à leur identifiant de dépôt. Pour ce faire, copiez un ID au format suivant : organizacion/nombre-del-modelo et collez-le dans la barre de recherche du Hub de Jan.
Par exemple, vous pourriez rechercher un dépôt comme bartowski/Qwen2.5-7B-Instruct-GGUFSi Jan reconnaît le dépôt, il affichera les quantifications disponibles afin que vous puissiez en sélectionner et en télécharger une.
Avant de continuer, assurez-vous que le dépôt contient des fichiers GGUF compatible avec llama.cppUn référentiel qui ne contient que des poids dans des formats tels que Safetensors ne peut pas être chargé de cette manière comme modèle local.
Certains modèles Hugging Face sont soumis à des restrictions et nécessitent l'acceptation préalable de leurs conditions d'utilisation. Dans ce cas, vous devrez vous connecter à Hugging Face, obtenir un jeton d'accès et le saisir dans le champ/programme/etc. approprié. Paramètres > Général > Autres > Jeton HuggingFaceL'emplacement exact peut varier légèrement selon la version de janvier.
Vous pouvez également ouvrir la page d'un modèle compatible sur Hugging Face, appuyer sur Utilisez ce modèle Sélectionnez ensuite Jan dans la section des applications locales. Le navigateur tentera d'ouvrir Jan pour lancer l'importation.

Comment importer un fichier GGUF enregistré sur votre ordinateur
Si vous avez déjà téléchargé le fichier à l'aide de votre navigateur ou d'un autre outil, vous n'avez pas besoin de le télécharger à nouveau depuis le Hub. En janvier, rendez-vous sur Paramètres > Fournisseurs de modèlesOuvrez le fichier de configuration llama.cpp et appuyez sur l'option Importer.
Ensuite, sélectionnez le fichier GGUF enregistré sur votre ordinateur. Jan analysera ses métadonnées afin d'identifier des informations telles que l'architecture, le tokenizer et, le cas échéant, le modèle de conversation.
Jan peut créer un lien vers le modèle à partir de son emplacement actuel au lieu de devoir en créer une autre copie complète. Cela permet de gagner de l'espace, mais implique que Vous ne devez ni déplacer, ni renommer, ni supprimer le fichier original. après l'importation. Si vous procédez ainsi, Jan risque de perdre la référence et d'interrompre le chargement du modèle.
Une fois l'application installée, ouvrez une nouvelle conversation, sélectionnez le modèle et attendez la fin du chargement. Le premier chargement peut être un peu plus long, surtout si le fichier est volumineux ou s'il sollicite beaucoup le processeur.
Importez dans Jan un modèle ajusté avec Ertas Studio
Les utilisateurs qui effectuent réglage fin des modèles de langage Ils peuvent également utiliser Jan comme environnement d'exécution. Des outils comme Ertas Studio permettent d'entraîner ou d'affiner un modèle dans le cloud et d'exporter le résultat au format GGUF.
Il ne s'agit pas d'une intégration directe entre les deux applications. Le flux de travail comprend la préparation et l'entraînement du modèle dans Ertas Studio, l'évaluation de ses résultats, l'exportation d'une version quantifiée, et Chargez le fichier GGUF plus tard en janvier en utilisant l'option d'importation locale.
Avant l'exportation, il est conseillé de tester différentes quantifications. Q4_K_M est généralement un choix judicieux pour la distribution du modèle sur des ordinateurs personnels, tandis que Q5_K_M ou Q8_0 peuvent offrir une fidélité supérieure si les ordinateurs cibles disposent d'une mémoire suffisante.
Ce système permet le développement d'assistants adaptés à une documentation, une terminologie ou des tâches spécifiques, et leur exécution ultérieure sans dépendance permanente à une API. Cependant, dans des secteurs tels que la santé ou la finance, Le travail local ne garantit pas en soi la conformité réglementaireIl est également nécessaire de contrôler la source des données, les autorisations, le stockage et l'accès au matériel.
Ajustez Jan pour que le modèle s'exécute plus rapidement.
La vitesse du modèle dépend de sa taille, de la quantification sélectionnée et du matériel disponible. L'icône des paramètres située à côté du modèle permet de modifier des paramètres tels que le contexte, la température et les couches envoyées au GPU.
L'ajustement Couches GPU Cela détermine le nombre de couches traitées par la carte graphique. Une valeur élevée améliore généralement la vitesse de manière significative, mais augmente également la consommation de VRAM. Si le modèle ne se charge pas ou si une erreur de mémoire survient, réduisez cette valeur jusqu'à trouver un réglage stable.
La longueur du contexte influe également sur la consommation. Même si un modèle prend en charge des dizaines de milliers de jetons, configurer le maximum dès le départ permet de réserver une quantité importante de mémoire pour le cache clé-valeur. Si le système manque de ressources, essayez… réduire le contexte ou utiliser un cache quantifié.
Sur les systèmes équipés d'une carte graphique NVIDIA, il est recommandé de vérifier que Jan utilise un backend CUDA compatible. Sur les autres systèmes, vous pouvez utiliser Vulkan, Metal ou le processeur, selon le matériel et le système d'exploitation. Jan AI ne détecte pas la carte graphiqueLa mise à jour des pilotes et du moteur llama.cpp est généralement l'une des premières étapes.
Comment supprimer des modèles et récupérer de l'espace disque
Les fichiers GGUF peuvent occuper plusieurs gigaoctets ; il est donc facile d’accumuler des dizaines de gigaoctets de fichiers provenant de modèles que vous n’utilisez plus. Pour en supprimer un individuellement, accédez à ses paramètres et appuyez sur l’icône de la corbeille.
Jan vous permet également d'effectuer un nettoyage en masse. Allez à Paramètres > Llama.cpp —ou MLX sur les appareils Apple compatibles—et utiliser Supprimer tout Dans la section « Modèles », avant de confirmer, l’application indique l’espace qui sera récupéré.
Cette fonctionnalité supprime les téléchargements gérés par Jan, mais Il préserve l'intégrité des modèles locaux liés manuellement.Dans ces cas-là, la référence à l'application est supprimée sans que le fichier d'origine soit effacé.
Que faire si Jan ne reconnaît pas ou ne charge pas le modèle GGUF ?
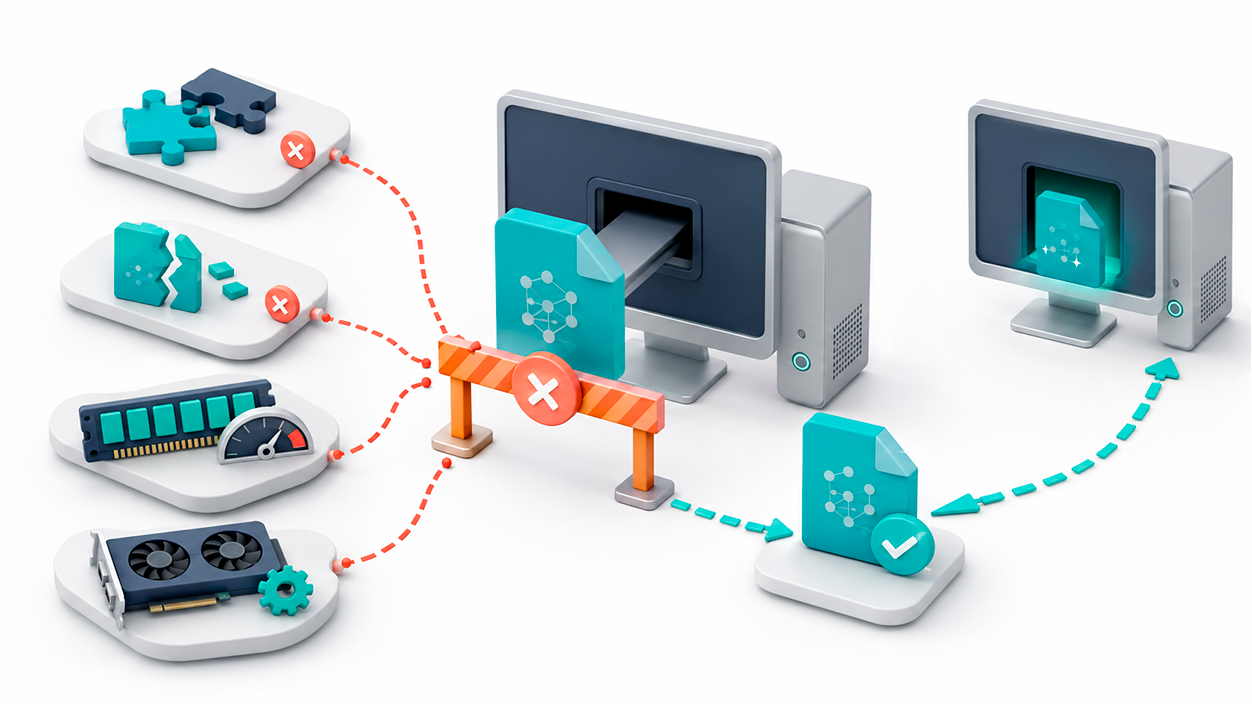
Lorsqu'un modèle reste bloqué au chargement ou que Jan affiche une erreur, le système commence par vérifier que le téléchargement du fichier est terminé et qu'il n'est pas divisé en plusieurs parties. Certains modèles volumineux sont distribués sous forme de plusieurs fichiers GGUF, qui doivent conserver leur nom et rester dans le même dossier.
Il est également possible que la version actuelle de llama.cpp ne soit pas compatible avec une architecture récemment publiée. Accédez aux paramètres du moteur, installez la dernière version disponible et activez les mises à jour automatiques si vous souhaitez recevoir les nouvelles versions.
Si le problème est lié à la mémoire, essayez les mesures suivantes :
- Réduisez le nombre de couches envoyées au GPU.
- Réduisez la longueur maximale du contexte.
- Fermez les jeux et les applications qui consomment beaucoup de RAM ou de VRAM.
- Utilisez une quantification plus petite, telle que Q4_K_M.
- Configurez Jan pour qu'il ne charge qu'un seul modèle à la fois.
- Essayez un autre serveur compatible avec votre processeur ou votre carte graphique.
Une fois le modèle importé depuis un autre dossier, vérifiez que le fichier se trouve toujours au même emplacement. S'il a été déplacé ou renommé, supprimez sa référence à Jan et importez-le à nouveau.
Jan accepte également les modèles personnalisés tels que Jan-v3-4BBasé sur Qwen3-4B-Instruct-2507, il se connecte également à OpenAI, Anthropic, OpenRouter et d'autres services compatibles. Cette combinaison vous permet d'utiliser des modèles locaux lorsque la confidentialité est essentielle et de faire appel à des fournisseurs externes lorsque vous avez besoin de plus de puissance ou de fonctionnalités spécifiques.
Importer des modèles GGUF dans Jan AI est donc un moyen simple de créer un environnement d'intelligence artificielle local sous votre contrôleChoisir une quantification appropriée, ajuster l'utilisation du GPU et maintenir le fichier llama.cpp à jour suffit généralement pour exécuter une grande variété de modèles sans dépendre constamment d'Internet.


Je suis un passionné de technologie qui a fait de ses intérêts de « geek » un métier. J'ai passé plus de 10 ans de ma vie à utiliser des technologies de pointe et à bricoler toutes sortes de programmes par pure curiosité. Aujourd'hui, je me spécialise dans l'informatique et les jeux vidéo. En effet, depuis plus de 5 ans, j'écris pour différents sites Web sur la technologie et les jeux vidéo, créant des articles qui cherchent à vous donner les informations dont vous avez besoin dans un langage compréhensible par tous.
Si vous avez des questions, mes connaissances s'étendent de tout ce qui concerne le système d'exploitation Windows ainsi qu'Android pour les téléphones mobiles. Et mon engagement est envers vous, je suis toujours prêt à consacrer quelques minutes et à vous aider à résoudre toutes les questions que vous pourriez avoir dans ce monde Internet.