- Jan AI memungkinkan Anda menjalankan model bahasa GGUF secara lokal sambil menjamin privasi data sepenuhnya.
- Perangkat lunak ini menawarkan berbagai metode impor, mulai dari Hub terintegrasinya hingga mengunggah file lokal atau tautan Hugging Face.
- Alat ini secara otomatis mendeteksi metadata model, sehingga memudahkan konfigurasi arsitektur dan templat obrolan.
Jika Anda tertarik dengan kecerdasan buatan tetapi tidak ingin mengirim percakapan dan dokumen pribadi Anda ke server eksternal, Jan AI menawarkan alternatif yang sangat menarik. Ini adalah asisten desktop gratis dan sumber terbuka yang memungkinkan menjalankan model bahasa langsung di komputer.
Salah satu keunggulan terbesarnya adalah kompatibilitasnya dengan Model format GGUF menggunakan llama.cppIni memungkinkan Anda untuk mengunduh model terkuantisasi, memanfaatkan CPU dan kartu grafis komputer, dan menggunakannya bahkan tanpa koneksi internet.
Pada praktiknya, Anda dapat mengubah Jan menjadi semacam ChatGPT pribadi dan yang dapat disesuaikan. Namun, privasi bergantung pada pengaturan yang Anda pilih. Model lokal memproses data pada perangkat.sementara koneksi dengan OpenAI, Anthropic, atau penyedia eksternal lainnya mengirimkan permintaan ke server mereka.

Hal-hal yang Anda butuhkan sebelum mengimpor model GGUF
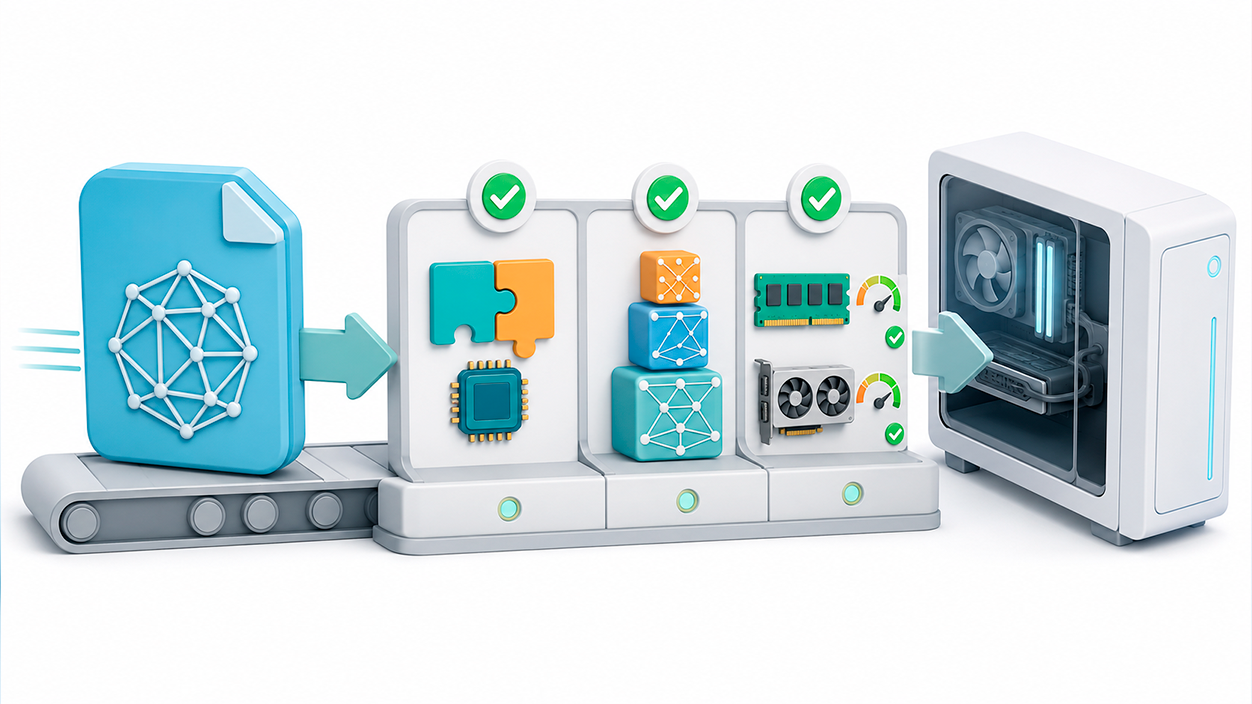
Sebelum mengunduh model pertama yang Anda temukan, ada baiknya untuk memeriksa apakah file tersebut kompatibel dengan llama.cpp dan ukurannya sesuai dengan memori yang tersedia. Repositori Hugging Face sering kali menyertakan beberapa kuantisasi dari model yang sama, seperti Q4_K_M, Q5_K_M, atau Q8_0.
Kuantisasi mengurangi ukuran data yang dimuat dan memungkinkan model besar untuk dijalankan pada mesin yang kurang bertenaga. Secara umum, Q4_K_M menawarkan keseimbangan yang baik antara kualitas, konsumsi memori, dan kecepatan.sementara Q5_K_M dan Q8_0 mempertahankan presisi yang sedikit lebih tinggi dengan imbalan membutuhkan lebih banyak ruang dan RAM atau VRAM.
Anda juga perlu memeriksa arsitektur model. Meskipun llama.cpp mendukung sejumlah besar keluarga, model yang baru diterbitkan mungkin memerlukan versi mesin yang lebih baru. Jika file tidak dimuat, bukan berarti selalu rusak. Backend yang dipasang pada bulan Januari mungkin belum mengenali arsitekturnya..
Unduh model dari Jan's Hub
Cara termudah untuk menambahkan model adalah dengan menggunakan Pusat terpadu JanDari bagian ini Anda dapat mencari model, melihat varian yang tersedia, dan mengunduh kuantisasi yang paling sesuai untuk komputer Anda.
Setelah pengunduhan dimulai, Jan akan menampilkan model dan persentase penyelesaian pada indikator di bagian atas. Proses dapat dibatalkan, dan jika terjadi kesalahan, cukup tekan tombol unduh lagi untuk mencoba.
Metode ini sangat direkomendasikan untuk pemula karena Jan akan mengurusnya. Simpan file dan siapkan konfigurasi yang diperlukan.Setelah pengunduhan selesai, templat akan muncul di pemilih obrolan dan Anda dapat memuatnya untuk mulai menggunakannya.
Impor model Wajah Berpelukan menggunakan ID-nya.
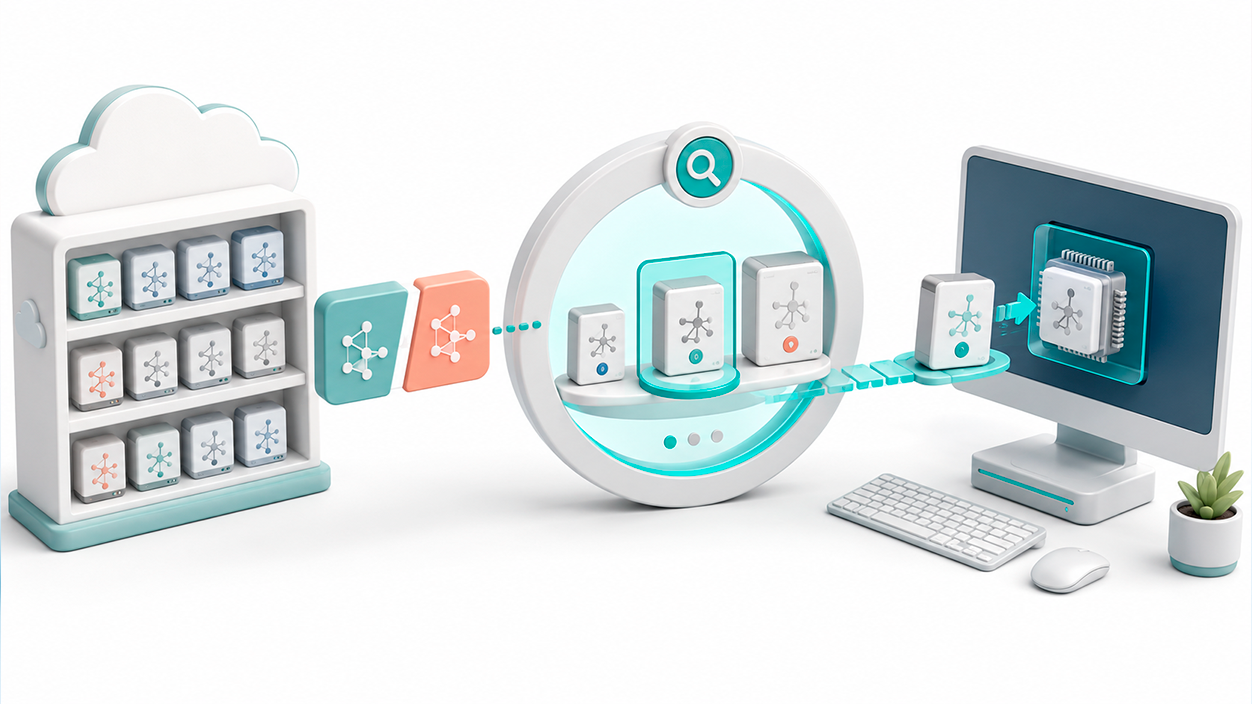
Hub ini juga memungkinkan Anda untuk menemukan model yang tersedia di Hugging Face menggunakan pengidentifikasi repositori mereka. Untuk melakukan ini, salin ID dalam format berikut: organizacion/nombre-del-modelo lalu tempelkan ke bilah pencarian Jan's Hub.
Sebagai contoh, Anda dapat mencari repositori seperti ini: bartowski/Qwen2.5-7B-Instruct-GGUFJika Jan mengenali repositori tersebut, ia akan menampilkan kuantisasi yang tersedia sehingga Anda dapat memilih dan mengunduh salah satunya.
Sebelum melanjutkan, pastikan repositori berisi file. GGUF kompatibel dengan llama.cppRepositori yang hanya menyertakan bobot dalam format seperti Safetensor tidak dapat dimuat dengan cara ini sebagai model lokal.
Beberapa model Hugging Face dibatasi dan mengharuskan Anda untuk menyetujui persyaratan penggunaannya terlebih dahulu. Dalam kasus tersebut, Anda perlu masuk ke Hugging Face, mendapatkan token akses, dan memasukkannya di [kolom/program/dll. yang sesuai]. Pengaturan > Umum > Lainnya > Token HuggingFaceLokasi tepatnya mungkin sedikit berbeda tergantung pada versi Januari.
Anda juga dapat membuka halaman model yang kompatibel di Hugging Face, ketuk Gunakan model ini lalu pilih Jan di bagian aplikasi lokal. Browser akan mencoba membuka Jan untuk memulai impor.

Cara mengimpor file GGUF yang tersimpan di komputer Anda
Jika Anda sudah mengunduh file tersebut menggunakan browser atau alat lain, Anda tidak perlu mengunduhnya lagi dari Hub. Pada bulan Januari, kunjungi Pengaturan > Penyedia ModelBuka file konfigurasi llama.cpp dan tekan opsi tersebut. Impor.
Selanjutnya, pilih file GGUF yang tersimpan di komputer Anda. Jan akan menganalisis metadata-nya untuk mengidentifikasi informasi seperti arsitektur, tokenizer, dan, jika tersedia, templat percakapan.
Jan dapat menautkan model dari lokasinya saat ini tanpa harus membuat salinan lengkap yang lain. Ini menghemat ruang, tetapi menyiratkan bahwa Anda tidak boleh memindahkan, mengganti nama, atau menghapus file asli. setelah mengimpornya. Jika Anda melakukan ini, Jan mungkin kehilangan referensi dan berhenti memuat model.
Setelah terinstal, buka obrolan baru, pilih templat, dan tunggu hingga selesai dimuat. Pemuatan pertama mungkin membutuhkan waktu sedikit lebih lama, terutama jika file berukuran besar atau sebagian besar memakan daya CPU.
Impor model yang disesuaikan dengan Ertas Studio ke Jan.
Pengguna yang melakukan penyempurnaan model bahasa Mereka juga dapat menggunakan Jan sebagai lingkungan runtime. Alat seperti Ertas Studio memungkinkan Anda untuk melatih atau menyempurnakan model di cloud dan mengekspor hasilnya dalam format GGUF.
Ini bukan integrasi langsung antara kedua aplikasi tersebut. Alur kerjanya melibatkan persiapan dan pelatihan model di Ertas Studio, mengevaluasi hasilnya, mengekspor versi terkuantisasi, dan Muat file GGUF nanti di bulan Januari. menggunakan opsi impor lokal.
Sebelum mengekspor, disarankan untuk menguji berbagai kuantisasi. Q4_K_M biasanya merupakan pilihan yang tepat untuk mendistribusikan model di antara komputer rumahan, sedangkan Q5_K_M atau Q8_0 dapat menawarkan fidelitas yang lebih tinggi jika komputer target memiliki memori yang cukup.
Sistem ini memungkinkan pengembangan wizard yang disesuaikan dengan dokumentasi, terminologi, atau tugas tertentu, dan eksekusi selanjutnya tanpa ketergantungan permanen pada API. Namun, di sektor-sektor seperti perawatan kesehatan atau keuangan, Bekerja secara lokal saja tidak dengan sendirinya menjamin kepatuhan terhadap peraturan.Selain itu, perlu juga mengontrol sumber data, izin, penyimpanan, dan akses ke peralatan.
Sesuaikan Jan agar model berjalan lebih cepat.
Kecepatan model akan bergantung pada ukurannya, kuantisasi yang dipilih, dan perangkat keras yang tersedia. Dari ikon pengaturan di sebelah model, Anda dapat memodifikasi parameter seperti konteks, suhu, dan lapisan yang dikirim ke GPU.
Penyesuaian Lapisan GPU Ini menentukan berapa banyak lapisan yang diproses oleh kartu grafis. Nilai tinggi biasanya meningkatkan kecepatan secara signifikan, tetapi juga meningkatkan konsumsi VRAM. Jika model gagal dimuat atau terjadi kesalahan memori, kurangi nilai ini hingga Anda menemukan pengaturan yang stabil.
Panjang konteks juga memengaruhi konsumsi. Bahkan jika sebuah model mendukung puluhan ribu token, mengkonfigurasi jumlah maksimum sejak awal dapat memesan sejumlah besar memori untuk cache KV. Jika sistem kehabisan sumber daya, coba... kurangi konteks atau gunakan cache terkuantisasi.
Pada sistem dengan kartu grafis NVIDIA, disarankan untuk memverifikasi bahwa Jan menggunakan backend CUDA yang kompatibel. Pada sistem lain, Anda dapat menggunakan Vulkan, Metal, atau CPU, tergantung pada perangkat keras dan sistem operasi. Jan AI tidak mendeteksi kartu grafis.Memperbarui driver dan mesin llama.cpp biasanya merupakan salah satu langkah pertama.
Cara menghapus template dan memulihkan ruang disk
File GGUF dapat memakan ruang hingga beberapa gigabyte, sehingga mudah untuk mengumpulkan puluhan gigabyte file dari model yang tidak lagi Anda gunakan. Untuk menghapus satu per satu, akses pengaturannya dan ketuk ikon tempat sampah.
Jan juga memungkinkan Anda untuk melakukan pembersihan massal. Kunjungi Pengaturan > Llama.cpp —atau MLX pada perangkat Apple yang kompatibel—dan gunakan Hapus Semua di dalam bagian model. Sebelum mengkonfirmasi, aplikasi akan menunjukkan berapa banyak ruang yang akan dikembalikan.
Fitur ini menghapus unduhan yang dikelola oleh Jan, tetapi Ini menjaga agar model lokal yang ditautkan secara manual tetap utuh.Dalam kasus ini, referensi aplikasi dihapus tanpa menghapus file aslinya.
Apa yang harus dilakukan jika Jan tidak mengenali atau memuat model GGUF?
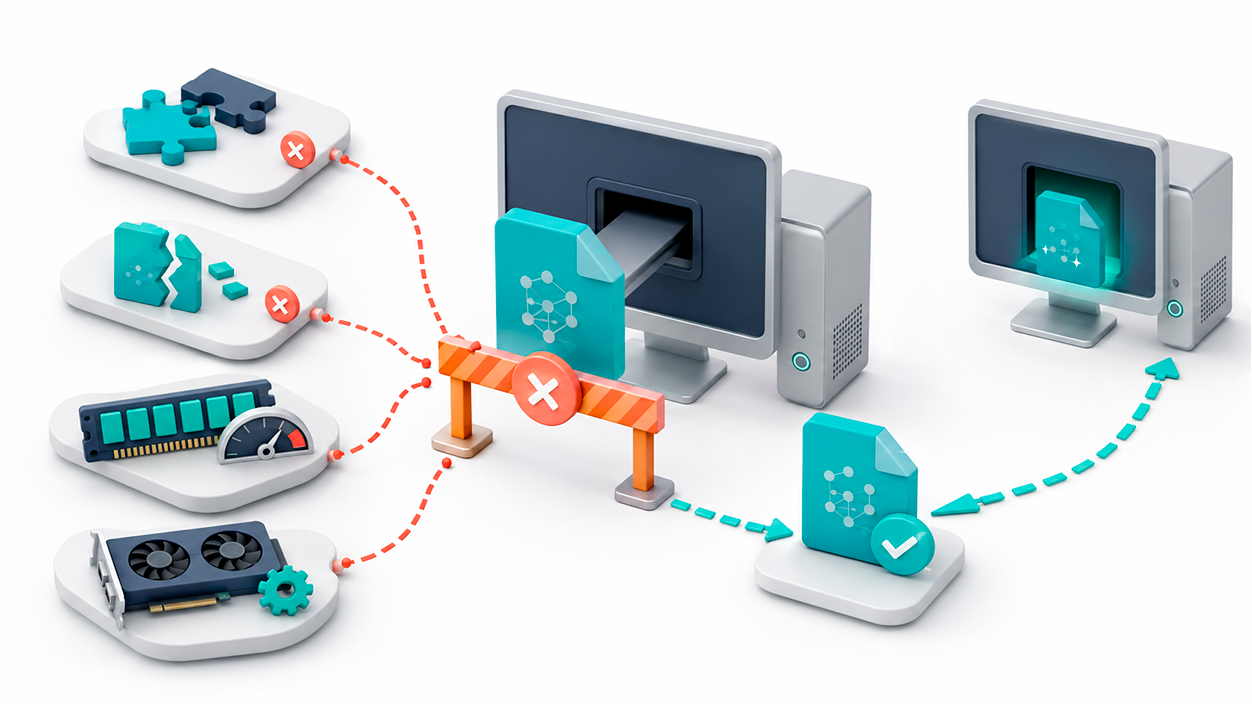
Ketika sebuah model macet saat memuat tanpa henti atau Jan menampilkan kesalahan, ia mulai dengan memeriksa apakah file telah selesai diunduh dan tidak terbagi menjadi beberapa bagian. Beberapa model besar didistribusikan sebagai beberapa file GGUF, yang harus mempertahankan nama-nama tersebut dan tetap berada dalam folder yang sama.
Ada kemungkinan juga versi llama.cpp saat ini tidak kompatibel dengan arsitektur yang baru dirilis. Buka pengaturan mesin, instal versi terbaru yang tersedia, dan aktifkan pembaruan otomatis jika Anda ingin menerima build baru.
Jika masalahnya terkait dengan memori, coba langkah-langkah berikut:
- Kurangi jumlah lapisan yang dikirim ke GPU.
- Kurangi panjang maksimum konteks.
- Tutup game dan aplikasi yang mengonsumsi banyak RAM atau VRAM.
- Gunakan kuantisasi yang lebih kecil, seperti Q4_K_M.
- Konfigurasikan Jan agar hanya memuat satu model dalam satu waktu.
- Cobalah backend lain yang kompatibel dengan prosesor atau kartu grafis Anda.
Setelah Anda mengimpor model dari folder lain, periksa juga apakah file tersebut masih berada di lokasi yang sama. Jika file tersebut dipindahkan atau diganti namanya, hapus referensinya ke Jan dan impor kembali.
Jan juga menerima model kustom seperti Jan-v3-4BBerdasarkan Qwen3-4B-Instruct-2507, ia juga terhubung ke OpenAI, Anthropic, OpenRouter, dan layanan kompatibel lainnya. Kombinasi ini memungkinkan Anda untuk menggunakan model lokal ketika Anda membutuhkan privasi dan beralih ke penyedia eksternal ketika Anda membutuhkan daya lebih atau fitur spesifik.
Oleh karena itu, mengimpor model GGUF ke Jan AI adalah cara sederhana untuk ciptakan lingkungan kecerdasan buatan lokal di bawah kendali AndaMemilih kuantisasi yang tepat, menyesuaikan penggunaan GPU, dan selalu memperbarui llama.cpp biasanya sudah cukup untuk menjalankan berbagai macam model tanpa harus terus-menerus bergantung pada internet.


Saya seorang penggila teknologi yang telah mengubah minat "geek"-nya menjadi sebuah profesi. Saya telah menghabiskan lebih dari 10 tahun hidup saya menggunakan teknologi mutakhir dan mengutak-atik semua jenis program hanya karena rasa ingin tahu. Sekarang saya memiliki spesialisasi dalam teknologi komputer dan video game. Hal ini karena selama lebih dari 5 tahun saya telah menulis untuk berbagai website tentang teknologi dan video game, membuat artikel yang berupaya memberikan informasi yang Anda butuhkan dalam bahasa yang dapat dimengerti oleh semua orang.
Jika Anda memiliki pertanyaan, pengetahuan saya berkisar dari segala sesuatu yang berhubungan dengan sistem operasi Windows serta Android untuk ponsel. Dan komitmen saya adalah kepada Anda, saya selalu bersedia meluangkan beberapa menit dan membantu Anda menyelesaikan pertanyaan apa pun yang mungkin Anda miliki di dunia internet ini.