- Il formato GGUF consente di raggruppare pesi e metadati in un unico file ottimizzato per l'inferenza locale.
- L'utilizzo di Modelfiles consente l'importazione di modelli personalizzati da Hugging Face nell'ecosistema Ollama.
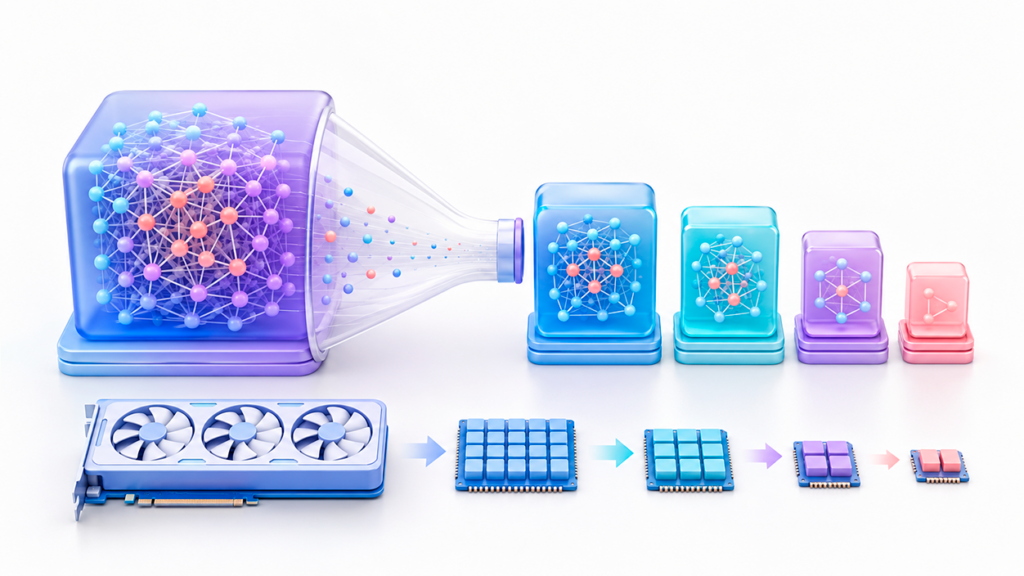
- La quantizzazione è lo strumento chiave per adattare le prestazioni del modello alla memoria VRAM disponibile.
- L'integrazione con llama.cpp accelera la disponibilità di nuove architetture di intelligenza artificiale negli ambienti locali.

¿Come caricare ed eseguire un modello GGUF utilizzando un file modello? Probabilmente ti è capitato di cercare uno specifico modello di IA nella libreria di Ollama solo per scoprire che non c'è. Oppure forse vuoi provare una particolare versione di un modello che hai visto su Hugging Face e non sai da dove cominciare. Non preoccuparti, perché anche se la documentazione ufficiale a volte sembra scritta per gli ingegneri della NASA, Costruisci il tuo modello GGUF È molto più semplice di quanto sembri, una volta che si conoscono i passaggi giusti.
In questo articolo, analizzeremo l'intero processo, dal download del file alla risposta del modello nel terminale. Vedremo come sfruttare il formato GGUF, che è fondamentalmente come un contenitore tutto in uno che include i pesi del modello e il tokenizzatore, consentendo all'IA di funzionare sul tuo computer senza sovraccaricare la RAM.
Concetti di base: cosa sono esattamente GGUF e llama.cpp?
Prima di entrare nel vivo della questione, è importante capire che Ollam non fa tutta la magia da solo; usa un motore chiamato lama.cppQuesto progetto è il cuore dell'inferenza locale e definisce il formato GGUF. Essenzialmente, GGUF consente al modello di essere CPU e GPU efficienti, evitando così la necessità di un server industriale per eseguire un'IA di buon livello.

Se guardi Hugging Face, vedrai che i modelli GGUF sono dotati di etichette come Q4_K_M o Q8_0Questa è la quantizzazione. In termini semplici, è come comprimere un file: la quantizzazione Q4 riduce le dimensioni del file e l'utilizzo della VRAM, ma mantiene una qualità straordinaria. Se hai un scheda grafica potentePuoi optare per Q8 o FP16; se hai poche risorse, Q4_K_M rappresenta il giusto compromesso.
Il metodo più rapido: importare un file GGUF esistente
Se hai già il file .gguf Sul tuo disco rigido non c'è bisogno di complicare le cose. Il processo è praticamente un "copia e incolla" intelligente. La prima cosa da fare è creare un semplice file di testo che chiameremo File modello (senza l'estensione .txt alla fine, anche se è possibile crearlo inizialmente in questo modo e poi rinominarlo).
All'interno di quel file, è sufficiente scrivere una sola riga fondamentale: FROM seguito dal percorso completo del tuo file. Per esempio: FROM C:\Usuarios\TuNombre\Downloads\modelo_genial.ggufUna volta salvato, apri il terminale o il prompt dei comandi ed esegui il comando ollama create nombre-de-tu-modelo -f ModelfileÈ fondamentale rispettare l'ordine degli argomenti affinché il sistema non segnali un errore.
Una volta completata l'elaborazione, avrai il modello integrato. Per testarlo, digita semplicemente ollama run nombre-de-tu-modelo E ora puoi iniziare a chattare con la tua IA locale. Se noti che il modello va in tilt o genera testo infinito, puoi regolare i token di arresto o la temperatura nel file del modello per renderla più coerente.
Livello avanzato: converti e quantifica i tuoi modelli
A volte, il modello che desideri non è in formato GGUF, ma in formato PyTorch o Safetensors. In tal caso, devi fare il lavoro sporco da solo usando lama.cppInnanzitutto, clona il repository llama.cpp e compilalo usando CMake e un compilatore come MinGW su Windows. Una volta ottenuti i file binari, puoi utilizzare lo script. convert_hf_to_gguf.py per trasformare il modello Hugging Face in un formato che Ollama comprende.
Dopo la conversione, otterrai un file FP16, che di solito è enorme. È qui che entra in gioco lo strumento. quantize.exeEseguendo questo comando, è possibile convertire quel file gigante in un versione quantizzata Q4_K_MQuesto riduce drasticamente l'utilizzo dello spazio su disco e il carico della GPU. Infine, si crea il file modello che punta a questo nuovo file quantizzato e lo si importa in Ollama come fatto in precedenza.
Personalizzazione approfondita del file modello
Il file modello non serve solo a dire a Ollamama dove si trova il file. È uno strumento potente per plasmare la personalità dell'IAÈ possibile aggiungere parametri tecnici come PARAMETER temperature 0.7 per controllare la creatività, o PARAMETER num_ctx 4096 per definire quanta memoria contestuale ha il modello per ricordare la conversazione.
Una delle caratteristiche più divertenti è la prompt di sistemaAttraverso la direttiva SYSTEMPuoi dire al modello di comportarsi come un esperto legale, un programmatore cinico o persino un personaggio di un videogioco. Ad esempio, se scrivi SYSTEM You are a helpful assistantIl modello si comporterà in modo standard, ma se si modifica la descrizione, Cambierai completamente il loro comportamento e il tono della risposta.
Ottimizzazione hardware e delle prestazioni
Con le ultime versioni di Ollama, l'integrazione con Vulkan e NVIDIA È migliorato molto. Su Windows, Vulkan è solitamente abilitato per impostazione predefinita, consentendo alle GPU AMD o Intel di aiutare con l'inferenza. Se hai una scheda NVIDIA, potresti notare un Miglioramento delle prestazioni fino al 20% Grazie alle ottimizzazioni CUDA.
Un trucco per sapere se tutto funziona correttamente è eseguire il comando ollama ps Mentre il modello è in esecuzione. Se nella colonna del processore vedi GPU al 100%Congratulazioni, stai davvero spingendo il tuo hardware al limite. Se vedi la scritta CPU o se c'è uno swapping continuo, probabilmente il modello è troppo grande per la tua VRAM e hai bisogno di... prova una quantizzazione più aggressiva (come Q2 o Q3).
Portare l'intelligenza artificiale sul proprio computer tramite i file GGUF offre il controllo completo su privacy e costi, consentendo di personalizzare prompt complessi ed eseguire modelli di community specializzati senza dover dipendere dal cloud. È sufficiente scaricare il file corretto, configurare un semplice file modello ed eseguire i comandi di creazione per avere un potente assistente privato operativo in pochi minuti.


Appassionato di tecnologia fin da piccolo. Amo aggiornarmi sul settore e, soprattutto, comunicarlo. Per questo da molti anni mi dedico alla comunicazione sui siti web di tecnologia e videogiochi. Puoi trovarmi a scrivere di Android, Windows, MacOS, iOS, Nintendo o qualsiasi altro argomento correlato che ti viene in mente.