- הבעיה טמונה בדרך כלל בקידוד תווים שגוי או בהיעדר טבלאות יוניקוד בגופנים המוטמעים של הקובץ.
- ישנן שיטות המבוססות על פרשנות מחדש ויזואלית של המסמך באמצעות OCR כדי לעקוף שכבות טקסט פגומות.
- רזולוציית תמונה ושימוש בגופנים לא סטנדרטיים משפיעים ישירות על מראהם של סמלים מוזרים או מרובעים.
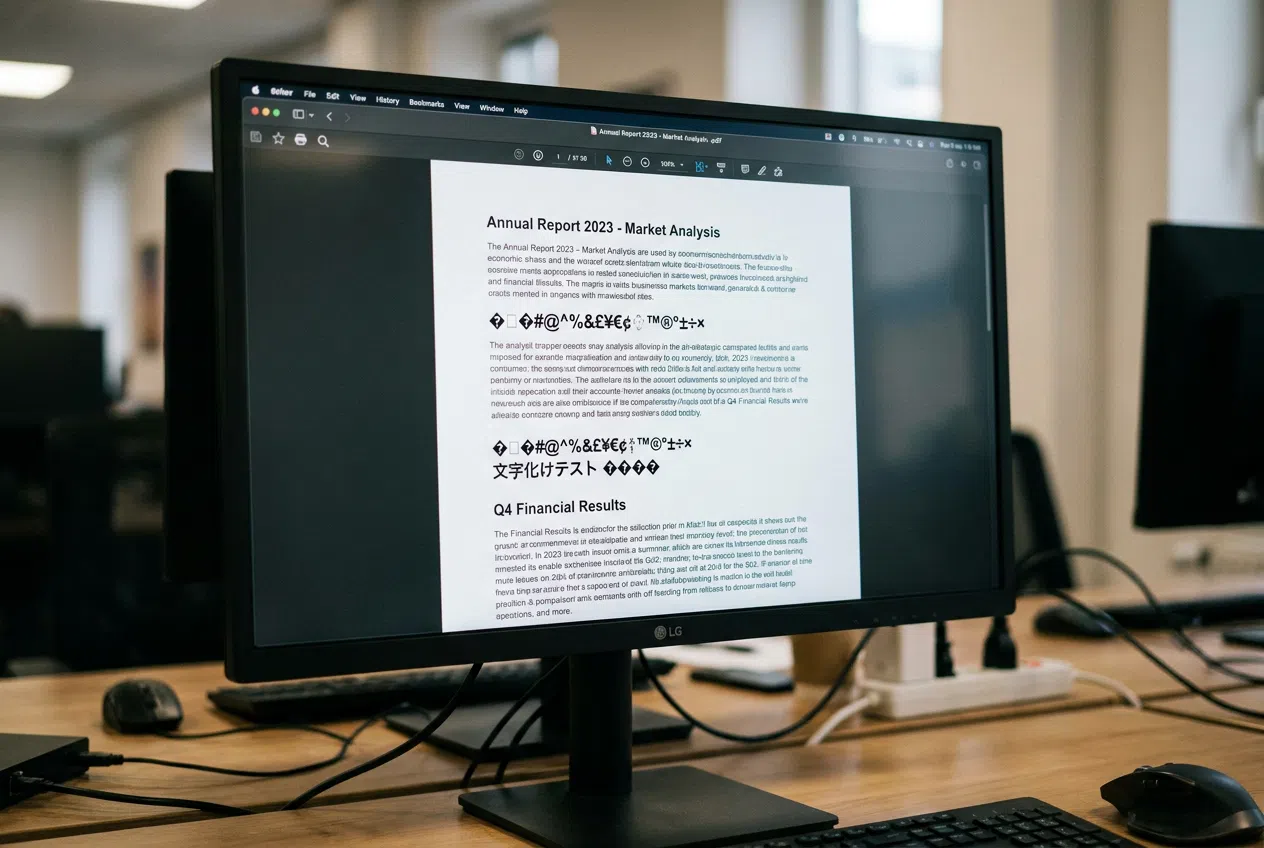
מדוע מופיעים סמלים בעת העתקת טקסט מקובץ PDF? זה כנראה קרה לכם: אתם עובדים עם מסמך PDF, אתם בוחרים פסקה שנראית בסדר, מדביקים אותה לתוך Word או Notepad, ופתאום אתם נתקלים ב... ג'יבריש של סמלים מוזריםריבועים או תווים שנראים כאילו הם מכוכב אחר. זהו מצב מתסכל שגורם לנו לחשוב שהקובץ פגום, אך המציאות היא שמדובר בכשל תקשורת טכני נפוץ למדי.
תופעה זו, המכונה לעיתים מוג'יבייקזה קורה בעיקרון משום שמה שאנחנו רואים על המסך אינו זהה לקוד שהמחשב מנסה להעתיק. זה לא שהטקסט נעלם, אלא ש... מיפוי תווים זה נכשל. למרבה המזל, יש שפע של טריקים, החל מהתאמות פשוטות ועד לשימוש בתוכנה ייעודית, כדי לשחזר את המידע הזה מבלי להקליד הכל ידנית.
למה לעזאזל מופיעים הסמלים האלה?
כדי להבין את הפתרון, ראשית עלינו להבין את הבעיה. לקובץ PDF יש שתי שכבות: השכבה החזותית (הגליפים) ושכבת הנתונים (הקידוד). כשאתה מעתיק טקסט, המערכת לא "מסתכלת" על האותיות, אלא קוראת קוד. אם הקובץ PDF משתמש ב... קידוד מותאם אישית או, אם אין לו טבלת יוניקוד סטנדרטית, הלוח לא יודע איזו אות מתאימה לקוד הזה ומציב כל סמל.
ישנן שלוש סיבות עיקריות. ראשית, ה אי התאמה בקידודכאשר תווים עם מבטאים או סימן האירו הופכים לזבל מכיוון שהקורא משתמש ב-UTF-8 אך הקובץ נוצר ב-Windows-1252. שנית, ה- קידוד מקור פגוםשבו קובץ ה-PDF נראה נהדר אבל שכבת הטקסט היא אסון מוחלט. ושלישית, ה- רזולוציה נמוכה, אשר מבלבל בין תוכנות זיהוי תווים אופטי (OCR), וגורם ל-5 להיראות כמו S או ל-0 כמו O.
טריקים מהירים ופתרונות ידניים

אם אינך רוצה להתקין תוכניות מורכבות, תוכל לנסות כמה שיטות פשוטות יותר. ב-Windows, אפשרות מעניינת אחת היא להשתמש ב- כותב מסמכים של מיקרוסופט XPSהדפסת קובץ ה-PDF כקובץ XPS יוצרת גרסה נקייה יותר שלפעמים מאפשרת להעתיק את הטקסט ללא שגיאות. מצד שני, אם הבעיה היא מעברי שורה מעצבנים בעת הדבקה לתוך Word, ניתן להשתמש בפונקציה של חפש והחלף כדי לשנות סימני פסקה לרווחים בודדים.
עבור משתמשי מק, יש טריק "קסם" ביישום התצוגה המקדימה. אם תיצאו את קובץ ה-PDF באמצעות פילטר קוורץ להקטנת גודלדחיסה לפעמים מסירה תווי זבל ומנקה את מבנה המסמך, מה שמאפשר העתקה חלקה הרבה יותר.
כלים מתקדמים ותוכנות תיקון
כאשר הבעיה חמורה, אנו זקוקים לתותחים כבדים. Adobe Acrobat Pro הוא הכלי הסטנדרטי; הוא מאפשר לנו לשנות את גופן הטקסט לגופן תואם יותר כמו Helvetica או להטמיע את הגופנים בצורה נכונה משלב ייצור הדפוס כדי למנוע החלפות שגויות.
אם הקובץ באמת פגום, ישנן תוכנות כמו EaseUS Fixo שמתמחות ב... תיקון קידוד תווים ולתקן מסמכים פגומים. עם זאת, אם אתם מחפשים משהו חינמי וחזק, PDFgear היא אלטרנטיבה נהדרת המאפשרת לכם להמיר קבצי PDF ישירות לטקסט רגיל או להשתמש בפונקציה שלה כדי OCR משולב כדי לחלץ את המידע.
כוחו של OCR: קרא את התמונה, לא את הקוד

הפתרון הכי בטוח כששום דבר אחר לא עובד הוא להתעלם משכבת הטקסט ולהתייחס לקובץ ה-PDF כאילו היה תצלום. זה מה ש... זיהוי תווים אופטי (OCR)על ידי אילוץ התוכנה לקרוא את הגליפים ויזואלית, אנו עוקפים כל שגיאת קידוד פנימית.
- כפיית OCR: באקרובט, בחרו באפשרות "תמונה עם טקסט מוסתר" כדי שהמנוע ינתח מחדש את הדף מאפס.
- המרת תמונה: טכניקה יעילה מאוד היא לייצא את הדפים לפורמט TIFF או PNG ברזולוציה גבוהה (מינימום 300 DPI) ולאחר מכן להריץ אותם באמצעות OCR. פעולה זו מסירה כל מטא-נתונים פגומים.
- שימוש בראייה של בינה מלאכותית: כלי חזון ומידול שפה (VLM) מודרניים כבר לא מנתחים אות אחר אות, אלא מבינים את הקשר סמנטי, ופותרים אי-בהירויות ש-OCR מסורתי לא יכול.
למי שמבין יותר בטכנולוגיה, אם הטקסט קצר, שלחו להם צילום מסך אל גוגל עדשה זהו פתרון מהיר מאוד וחינמי שבדרך כלל עובד נפלא מכיוון שהוא משתמש בטכנולוגיית הזיהוי החזותי של גוגל.
העתקה של קובץ PDF עם טקסט בלתי קריא היא למעשה בעיית תרגום בין הגופן המוטמע למערכת ההפעלה. בין אם על ידי קידוד מחדש של הקובץ, שימוש במדפסות וירטואליות או פריסת תוכנת OCR חזקה שמנתחת את התמונה במקום את הקוד, תמיד יש דרך לשחזר את הנתונים. המפתח הוא לזהות האם הבעיה טמונה בגופן, בקידוד התווים או פשוט ברזולוציה ירודה שמבלבלת את התוכנה. עכשיו אתם יודעים הכל על הסיבות שמופיעות סמלים בעת העתקת טקסט מקובץ PDF.

נלהב לטכנולוגיה מאז שהיה קטן. אני אוהב להיות מעודכן במגזר ומעל הכל לתקשר אותו. לכן אני מוקדש לתקשורת באתרי טכנולוגיה ומשחקי וידאו כבר שנים רבות. אתה יכול למצוא אותי כותב על אנדרואיד, Windows, MacOS, iOS, נינטנדו או כל נושא אחר שעולה על דעתך.