Firecrawl を使用して Web ページのコンテンツを抽出する方法を説明します。このツールは、同種のツールの中で最も効率的なものの 1 つであり、 アンチボットブロックを回避する さらに、その他の一般的な障害も克服できます。また、ウェブサイトから利用するか、APIを介して統合するかの2つの方法で利用できます。詳細は以下でご説明します。
Firecrawlとは何ですか?また、なぜFirecrawlを使うべきなのでしょうか?

人工知能はデータに基づいて学習するが、ウェブ上には膨大な量のデータが存在する!問題は、 ウェブサイトは、機械ではなく人間が読むことを想定して設計されている。メニュー、見出し、広告、画像、動画、JavaScriptを処理し、さらにアンチボットシステムと戦うことは、言語モデル(LLM)にとっては負担が大きすぎる。
ここは ウェブスクレイピングツール これらは、ウェブサイトから構造化された方法でデータを抽出するために非常に必要になります。特に、Firecrawl は、次のような目的で設計されています。 フィード言語モデル、RAGシステム、その他のAI環境これは、ウェブサイトの混沌とした状態を、AIが直接理解できる、整理された構造化データに変換するもので、手動でのクリーニングは不要です。
Firecrawlとは? ウェブスクレイピング それ あらゆるウェブページを、AIが容易に理解できる形式に変換します。Markdown、HTML、JSONなど、様々な形式のテキストを抽出できます。テキストを抽出するだけでなく、JavaScriptを使用してコンテンツを読み込む複雑なWebサイトも理解し、プロキシやアンチボットシステムを自動的に管理します。つまり、あらゆるものを処理できるため、Firecrawlを使用してWebページのコンテンツを抽出する方法を知っておくことは非常に役立ちます。
Firecrawlを使用してWebページのコンテンツを抽出する方法
前述したように、Firecrawl を使用して Web ページからコンテンツを抽出する方法は 2 つあります。1 つは、Web ページから直接抽出する方法です。 firecrawl.dev ウェブサイト. ログインして、リンクをプレイグラウンドに貼り付けると、プラットフォームがスクレイピングを実行します。 データはJSON形式またはMarkdown形式で配信されます。インストールやキーの設定、コードの記述は一切不要です。
しかし、ツールを大規模プロジェクトの一部として実装する必要がある場合は、最善の方法は PythonとNode.jsの公式SDKを使用して統合します。ただし、認証APIを取得する必要がある場合もありますし、できれば有料プランにアップグレードすることをお勧めします(Firecrawlは無料でも利用できますが、高度な機能には大きな制限があります)。
Firecrawlは彼らのウェブサイトから入手してください。
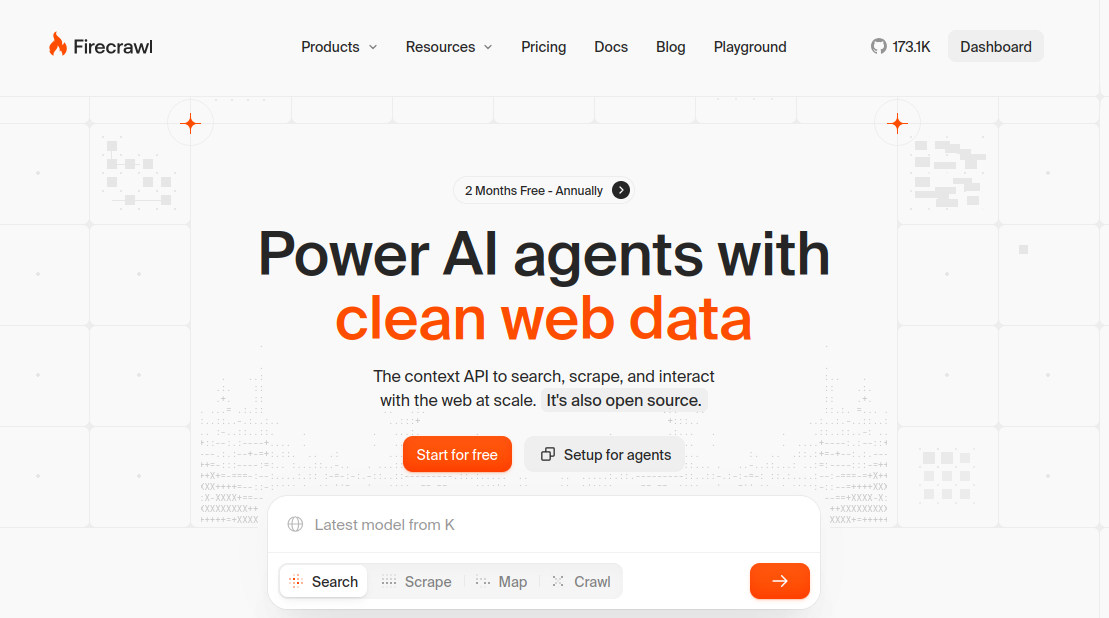
Firecrawlを使用してプレイグラウンドからウェブページのコンテンツを抽出することは、ツールをテストする最も簡単な方法です。最初にすべきことは frecrawl.dev にアクセスして無料アカウントを作成してください。無料プランでは、義務を負うことなく複数回の無料トライアルをご利用いただけます。
コントロールパネルに入ったら、次のセクションを探してください。 "遊び場" 左側のサイドバーメニューにあります。そこからいくつかのオプションを選択できます。
- スクレイピング: これは、個々のウェブページの内容を抽出するために使用されます。おそらく最も頻繁に使用するオプションでしょう。
- クロール: これにより、ウェブサイト全体をクロールできるため、ドキュメント、ブログ、またはストア全体を抽出する必要がある場合に非常に便利です。
- 地図: ウェブサイトに属するすべてのURLを検出する。
- 検索: これは、ウェブを検索し、検索結果を抽出するために使用されます。
オプションを選択したら、あとは ウェブサイトのアドレスを貼り付けてください 検索バーに抽出したい文字列を入力します。最後に、コンテンツの出力形式を選択する必要があります。
- マークダウン: これは言語モデルで最も一般的な形式です。基本的な書式設定が施された、読みやすいテキストが得られます。
- HTML: HTMLコードから不要なスクリプトとスタイルが削除されました。
- JSON: 構造化されたデータを提供するため、価格や説明などの特定の情報を抽出する必要がある場合に最適です。
- スクリーンショット: レンダリングされたページのスクリーンショットを提供してください。
- まとめ: AIが生成した主要コンテンツの要約。
出力形式を選択したら、「スクレイピング」をクリックして システムはページを処理し、同じインターフェースに結果を表示します。そこでは、コピー、ダウンロード、またはプロジェクト内で直接使用できます。Firecrawlを使用してこのようなウェブページからコンテンツを抽出するのは非常に簡単ですが、場合によっては十分ではないかもしれません。
Firecrawl SDKを使用してWebページのコンテンツを抽出します。
大規模なスクレイピングが必要な場合は、Firecrawl SDK を使用して Web ページコンテンツを抽出するのが最適な選択肢です。アプリケーション、自動化されたワークフロー、データパイプラインに統合したり、単に... 多数のURLを処理する必要がありますこのような場合、ウェブ上で処理するのはもはや現実的ではありません。すべてを準備するには、何らかのコードを記述する必要があります。
まず第一に Pythonで公式Firecrawl SDKをインストールします。 とともに python-dotenv 以下のコマンドで pip install firecrawl-py python-dotenv次に、プロジェクトのルートディレクトリに.envファイルを作成し、Firecrawlアカウントの設定で確認できるAPIキーを入力する必要があります。 FIRECRAWL_API_KEY=fc-TU_API_KEY_AQUI.
これで、Firecrawl を使用してコマンドラインから Web ページコンテンツを抽出できるようになりました。わずか数行のコードで、必要な形式のクリーンなコンテンツを取得できます。さらに、必要に応じて 複数のページから情報を抽出する、使用することができます crawl これにより、ツールはウェブサイト上のすべてのリンクを自動的に検出できるようになります。
Firecrawlを他のAIアプリケーションやサービスと統合する
当然ながら、Firecrawlは他のツールと統合することで、スクレイピング時にその潜在能力と使いやすさを最大限に活用できるツールです。例えば、 MCPサーバーを搭載しています。 その設定は、Claude、VS Code、ChatGPTなどの他のAIツールやサービスに追加できます。
さらに、ファイヤークロール 統合用の既製ノードとモジュールを提供します n8nやZapier、Makeなどのプラットフォームでも。 ツールまたはドキュメントアップローダーとしてインストールできます。 LangChain、LlamaIndex、CrewAI、Pydantic AIなどのフレームワーク内で使用できます。Firecrawlは、メインソフトウェアとしてもプラグインとしても、Webページのコンテンツを抽出するために使用できます。
つまり、Firecrawlを使えばHTMLのクリーンアップ作業から解放され、最も重要なことに集中できるのです。 AIおよび自動化プロジェクトにこのコンテンツを活用してください。このツールをご存知ない方は、ワークフローを次のレベルに引き上げたいのであれば、ぜひ使い方を覚えてください。Firecrawl を今すぐ使い始めて、Web ページからコンテンツを抽出しましょう。

幼い頃から科学技術全般、特に私たちの生活をより便利で楽しいものにしてくれる進歩に魅了されてきました。最新のニュースやトレンドを常に把握し、自分が使っているデバイスやガジェットに関する経験、意見、ヒントを共有することが大好きです。それがきっかけで、5年ほど前にウェブライターになり、主にAndroidデバイスとWindowsオペレーティングシステムを専門にしています。複雑な概念を分かりやすく説明することで、読者に理解しやすくすることを学んできました。