- Ollamaをモデルエンジンとして、Open WebUIをグラフィカルインターフェースとして組み合わせることで、プライベートな人工知能エコシステムを構築する。
- 高度な言語モデルを完全にオフラインで実行できるため、機密データの絶対的なプライバシーが保証されます。
- 個人文書とのやり取りを可能にする検索拡張生成(RAG)などの高度な機能の統合、およびMCPプロトコルの使用。
¿Open WebUIをOllamaに接続して、インターネット接続なしでローカルモデルを使用するにはどうすればよいですか? ClaudeやGeminiのようなツールが素晴らしいことはお気づきでしょうが、小さな問題があります。それは、書いた内容がすべてリモートサーバーに送信されることです。 機密性の高い顧客データ ビジネス戦略において、クラウドは少し敷居が高いと感じるかもしれません。しかし幸いなことに、最近ではコンピューターの天才でなくても、コンピューターからデータを一切送信することなく、自宅で独自の人工知能を構築できるようになりました。
OllamaとOpen WebUIの組み合わせは、まさに理想的な組み合わせです。 完全なプライバシー保護と無料 トークンごとに。片方がモデルの実行という面倒な作業を処理する一方で、もう片方はChatGPTによく似た、美しく使いやすいインターフェースを提供し、一度設定すれば、コマンドラインを一切触ることなく、チャットの管理、ドキュメントのアップロード、さらにはAIとの会話まで可能になります。
具体的に何について話しているのか?OllamaとOpen WebUIを理解する
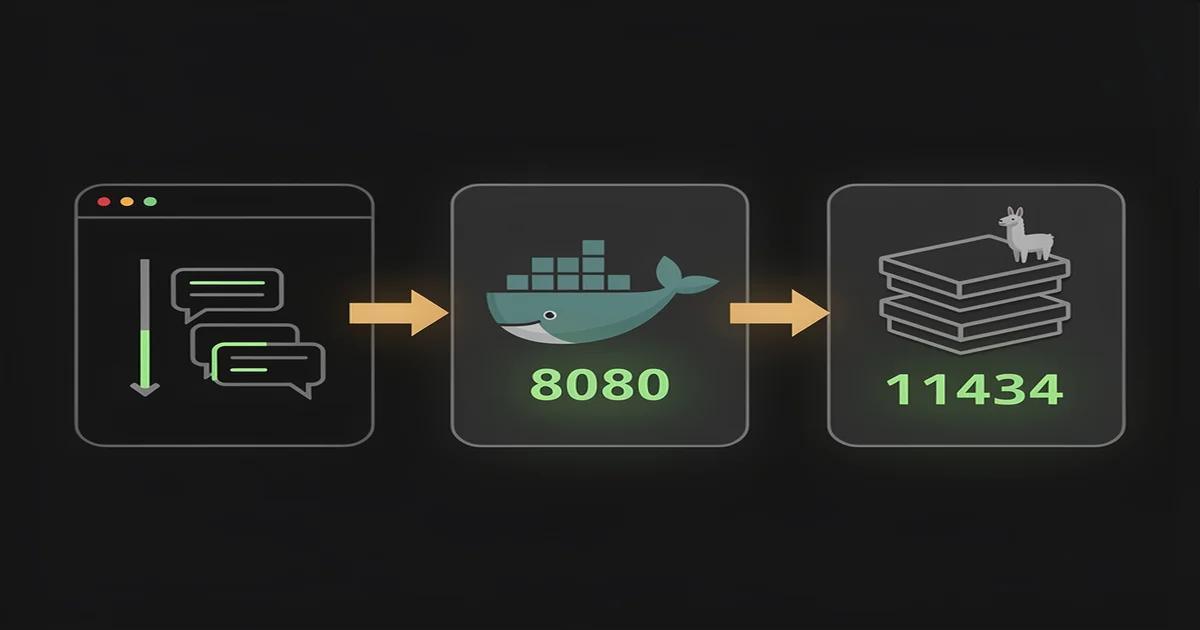
名前の混同を避けるため、明確にしておきましょう。 オラマはエンジンですこれは、モデルファイル(一般的なGGUFファイルなど)をダウンロードし、プロセッサまたはグラフィックカードを使用して実行するツールです。また、他のアプリケーションがモデルと通信できるように、ポート11434でAPIを公開する技術的な基盤でもあります。
一方で、 Open WebUIはビジュアルレイヤーですこれはオープンソースのフロントエンドで、通常はDocker経由でインストールされ、退屈な黒いターミナルを直感的なパネルに変えます。これのおかげで、 会話履歴お気に入りのプロンプトを整理したり、複数のユーザーを管理したりすることで、仕事のチーム向けにサーバーをセットアップできます。
LM StudioやJanのような他の代替手段もあり、これらは手軽な個人利用には最適です。しかし、Open WebUIは、必要なときに最も優れています。 高度な機能 例えば、ネイティブのRAG、ユーザー管理、Python経由でのプラグイン追加機能などがあり、プロフェッショナルな環境にとって最も堅牢な選択肢となっています。
ハードウェア要件と推奨モデル
ハードウェアに大金を費やす必要はありませんが、優れたGPUがあればAIの応答速度が遅くなるのを防ぐのに役立ちます。7兆または8兆のパラメータを持つ軽量モデルの場合、 16 GBのRAM 通常は、十分な体験が得られます。Macをお持ちの場合は、 Apple Silicon(M1、M2、M3、またはM4)幸運なことに、統合メモリのおかげでこれらのモデルは高速に動作します。
本気で猛スピードを求めるなら、カード 8GB以上のVRAMを搭載したNVIDIA製グラフィックカード (RTX 3060や4060など)が安全な選択肢です。最高品質を求めるなら、70B Llama 3.3のようなモデルはGPT-4の能力に非常に近いですが、必要なマシンは 64GBのRAMまたは高性能GPU 遅延によるイライラを避けるため。
モデルに関しては、Llama 3.2 は速度と知能のバランスが素晴らしいです。コーディングに特化したものを探しているなら、 DeepSeekは素晴らしい一方、MistralとQwen 2.5は、スペインのスペイン語を含む複数の言語で優れたパフォーマンスを発揮し、日常使いに非常に効率的な選択肢となっています。
インストール手順ガイド
最も速い方法はDockerを使うことです。まず、Ollamaを公式サイトからダウンロードしてインストールします。インストールが完了したら、ターミナルを開いて次のようなコマンドを実行します。 ollama pull llama3.2 のために モデルがあることを確認してください すぐに使えます。実行を忘れないでください。 ollama serve これにより、APIがアクティブになり、リッスン状態になります。
インターフェースを設定するには、次のDockerコマンドを実行してください。 docker run -d -p 3000:8080 --add-host=host.docker.internal:host-gateway -v open-webui:/app/backend/data --name open-webui ghcr.io/open-webui/open-webui:mainこのコマンドはフラグが重要なので ホスト.docker.internal これにより、Webコンテナはオペレーティングシステム上で実行されているOllamaエンジンを検出できるようになります。
あとはブラウザを開いて、 http://localhost:3000最初に登録したユーザーが自動的にシステム管理者になります。そこから接続設定に移動して、Ollamaがリンクされていることを確認できます。すべてがうまくいけば、 モデルの展開 それは魔法のように一番上のセレクターに表示されます。
RAGをマスターする:自分のドキュメントに話しかけてみよう
最も強力な機能の1つはRAG(リカバリー拡張生成)です。基本的に、これはAIが... PDF、Word、またはMarkdownファイルを分析します クラウドサービスにアップロードすることなく、これらのドキュメントを保存できます。有効にするには、プロフィールにアクセスし、ワークスペースに入り、ドキュメントをアップロードしてナレッジコレクションを作成してください。
重要な技術的詳細の 1 つは、次のような埋め込みモデルが必要になるということです。 ノミカル埋め込みテキストダウンロードするには ollama pull nomic-embed-text管理パネルで設定すれば、どのチャットでも簡単にドキュメントにアクセスできます。 # キーを入力する そして、対応するファイルまたはコレクションを選択します。
AIが混乱したり、応答が途切れたりする場合は、 フラグメントサイズを調整する (チャンク)。コンテキストウィンドウを縮小した小型モデルを使用している場合、チャンクサイズを1500トークンから800トークンに下げると、通常は問題が解決し、AIがドキュメントに基づいて質問と回答を処理するのに十分なスペースが確保されます。
高度な機能:音声、パイプライン、MCP
Open WebUIは単なるチャットではなく、拡張可能なプラットフォームです。 Whisperを使用した音声認識 AIに話しかけるには、テキスト読み上げ(TTS)機能を使って応答させます。最も実用的な方法は、入力にはローカル環境でWhisperを使用し、クリアで自然な音声出力にはOpenAI APIを使用することです。
あなたが開発者であれば、 パイプラインと関数 これらを使えば、驚くべき成果を上げることができます。Python でフィルターを作成して、モデルに到達する前に機密データをクリーンアップしたり、特定のスクリプトを実行するアクション ボタンを追加したりできます。さらに、 モデルコンテキストプロトコル(MCP) これにより、ローカルAIがGitHubやSlackなどの外部ツールに接続できるようになります。
これをチーム環境に取り入れたい場合、理想的なのは Docker Composeこれにより、OllamaとOpen WebUIを単一のYAMLファイル内で別々のサービスとして管理できるようになり、データボリュームのバックアップが容易になるとともに、Dockerの内部ネットワークがIPアドレスの複雑な処理なしにサービス名を解決できるようになります。
このシステムを構築することは、情報に対するコントロールを取り戻す最良の方法です。OllamaのパワーとOpen WebUIの汎用性を組み合わせることで、サブスクリプションや外部接続に依存しないプロフェッショナルなツールを作成し、 AIの最先端 自社ハードウェアの完全なプライバシーの中で。

幼い頃からテクノロジーに熱中。私はこの分野の最新情報を知ること、そして何よりもそれを伝えることが大好きです。だからこそ、私は長年テクノロジーとビデオゲームのウェブサイトでのコミュニケーションに専念してきました。 Android、Windows、MacOS、iOS、Nintendo、またはその他の思いついた関連トピックについて書いているのを見つけることができます。