- Geheugenvergrendeling in AI ontstaat wanneer uw context en voorkeuren vast komen te zitten in één enkele assistent, waardoor de kosten voor het overstappen naar een ander model toenemen.
- Anthropic heeft samen met Claude geheugen beschikbaar gesteld voor gratis gebruikers en een importfunctie geïntroduceerd waarmee geheugens van ChatGPT of Gemini kunnen worden overgezet.
- Het importproces is gebaseerd op het destilleren van de informatie die het bronmodel over u weet, het integreren ervan in het gestructureerde geheugen van Claude, met respect voor privacy en controle.
- Daarnaast fixeert de klassieke "geheugenvergrendeling" in besturingssystemen pagina's in het RAM-geheugen voor realtime, wat een andere technische betekenis van de term aantoont.

Als je al maanden een AI-assistent gebruikt, weet je al dat je niet zomaar willekeurige berichten typt: je bouwt geleidelijk aan een soort profiel op. gedeeld geheugen vol context, voorkeuren en projectenJouw manier van werken, je schrijfstijl, je correcties en je eigenaardigheden blijven erin bewaard, alsof de machine je elke dag een beetje beter leert kennen.
Het probleem is dat dat geheugen tegenwoordig meestal... Het zit vast in elk platform en wordt een krachtige "geheugenvergrendeling".Als u van model of aanbieder wilt veranderen, moet u helemaal opnieuw beginnen. In dit artikel Laten we eens precies uitleggen wat geheugenvergrendeling inhoudt.Waarom is het zo belangrijk op technisch, product- en zelfs politiek niveau, en hoe? Initiatieven zoals Claude's geheugenimport of voorstellen voor open standaarden proberen het tij te keren..
Wat is "geheugenvergrendeling" bij AI-assistenten?
In de context van moderne AI-assistenten verwijst "geheugenvergrendeling" naar het feit dat Alle gegevens die je met een model hebt gegenereerd, blijven in die service opgeslagen.Zonder een eenvoudige, native en gestandaardiseerde manier om het naar een ander apparaat over te zetten. We hebben het niet alleen over chatgeschiedenis, maar over iets veel waardevollers: context op de lange termijn.
Na verloop van tijd leert een assistent zoals ChatGPT, Gemini of Claude Hoe wilt u beantwoord worden, welke taal gebruikt u, en aan welke projecten werkt u momenteel?Welke technische frameworks gebruik je, welke taken heb je ingesteld en welke taken moet het systeem altijd uitvoeren? Dat is het werkelijke 'kapitaal' dat je opbouwt.
De meeste platformen ontwerpen hun producten echter op zo'n manier dat Er bestaat geen eenvoudige standaard voor het overzetten van dat geheugen naar een ander concurrerend model.Hoewel je gesprekken kunt opslaan of exporteren, is de interne geheugenstructuur (de gedestilleerde voorkeuren die het systeem heeft afgeleid) meestal niet interoperabel. Het praktische gevolg: als je een jaar hebt besteed aan het trainen van één assistent, denk je wel twee keer na voordat je een andere probeert, omdat je weet dat je dat 'wederzijds begrip' zult verliezen.
Dit effect is geen toeval. Voor veel bedrijven geldt dat... Geheugenvergrendeling fungeert als een barrière die gebruikers afschrikt, zelfs wanneer er potentieel betere alternatieven beschikbaar zijn.De prestaties van de modellen worden steeds gelijkwaardiger, waardoor het concurrentievoordeel nu draait om wie je zo veel mogelijk binnen hun ecosysteem kan houden.
Waarom jouw context goud waard is (en waarom je die overal mee naartoe kunt nemen)
Achter elke chatsessie schuilt veel meer dan een simpele uitwisseling van vragen en antwoorden: Je investeert tijd in het verfijnen van instructies, het debuggen van workflows en het aanleren van AI hoe jij werkt.Dit werk is niet eenvoudig en neemt in veel gevallen maanden in beslag.
Wanneer je een goede systeemprompt schrijft, een programmeerworkflow ontwerpt of de manier waarop het model je projecten documenteert verfijnt, ben je in feite aan het bouwen. een unieke “contextlaag”, gekoppeld aan u en uw organisatieDie laag is een soort uitgebreid geheugen: het bevat je geschiedenis, je manier van denken, je technologie-stack en je manier van communiceren.
Het grote probleem is dat de industrie in het algemeen, Behandel die laag alsof het wegwerpbaar is.Als je besluit een ander model te proberen, bieden ze zelden een gemakkelijke manier om die herinnering over te dragen. Meestal moet je alles opnieuw uitleggen: wie je bent, wat je doet, je stijlkenmerken, hoe je aangesproken wilt worden, aan welke projecten je werkt.
Vandaar de groeiende vraag dat gebruikers zouden moeten beschikken over... “draagbaar inheems geheugen”Een standaard en eenvoudig mechanisme om persoonlijke gegevens tussen verschillende tools over te zetten, net zoals we een pdf versturen of een document van de ene editor naar de andere overzetten. Het idee is dat jouw context van jou is, niet van het platform.
Voorstellen vanuit de gemeenschap: op weg naar een open geheugenstandaard.
Naast de acties van grote bedrijven beginnen er ook stemmen op te klinken binnen de gemeenschap die eisen stellen. een open standaard voor geheugenportabiliteitHet uitgangspunt is duidelijk: als alle aanbieders een gemeenschappelijk formaat hanteren voor het beschrijven van de langetermijncontext van de gebruiker, zou het wijzigen van modellen net zo eenvoudig zijn als het uploaden van een bestand.
Sommige mensen en teams zijn al bezig met de organisatie om Onderteken formele petities gericht aan de toonaangevende AI-laboratoria.Ze vragen precies hierom: dat het recht van gebruikers om hun geheugen te bewaren en te verplaatsen wordt erkend. Minimaal eisen ze een "herlaadfunctie" in de interfaces, waarmee gebruikers hun volledige context in één keer opnieuw kunnen verzenden, zonder deze telkens handmatig te hoeven reconstrueren.
In deze context zijn er hulpmiddelen ontstaan die de kloof overbruggen, zoals bepaalde oplossingen die fungeren als "geheugensmederijen", waarmee je Een deel van de context uit het ene model halen en voorbereiden voor een ander model.De makers erkennen zelf dat hun uiteindelijke doel niet is om een patch te verkopen, maar om ervoor te zorgen dat deze functies standaard in de software worden opgenomen en niet als betaalde add-on verkrijgbaar zijn. Het idee is dat draagbaarheid een basisrecht zou moeten zijn, geen niche-add-on.
De antropische beweging: herinnering voor iedereen en import van ChatGPT en Gemini
Ondertussen hebben de belangrijkste spelers in de sector ingezien dat "Geheugenvergrendeling" is een tweesnijdend zwaard.Het helpt om gebruikers te behouden, maar het kan ook een geweldige kans zijn om Het trekt mensen aan die het zat zijn om afhankelijk te zijn van één enkele leverancier.En hier komt Anthropic met Claude in beeld.
Anthropic heeft besloten om Claudes geheugen open te stellen voor alle gebruikers, inclusief de gratis laag, en Start een specifieke functie om geheugen te importeren vanuit ChatGPT, Gemini en andere assistenten.Het interessante is niet alleen dat ze gratis geheugen beschikbaar stellen aan gebruikers, maar ook dat ze openlijk de oorlog verklaren aan de kosten van het overstappen tussen platforms.
Iedereen die maandenlang met een assistent heeft samengewerkt, weet hoe pijnlijk het is om helemaal opnieuw te beginnen: Je moet de zakelijke context, de toon, de projectdetails en de voorkeuren voor de opmaak herhalen....de tools die je dagelijks gebruikt... Die "luiheid om te migreren" is precies de afhankelijkheid die veel bedrijven onbewust hebben gecreëerd.
Met deze nieuwe functie biedt Anthropic iets heel eenvoudigs: Vul die kloof die gebruikers van andere modellen scheidt gratis op.In plaats van je neer te leggen bij het verlies van alles, kun je de kern van je geheugen met een relatief eenvoudig proces van het ene model naar Claude overzetten. Volgens gespecialiseerde media werd de functie al enige tijd geleden getest, maar is nu op grote schaal en met verbeterde mogelijkheden beschikbaar.
Deze stap komt op een moment dat De toonaangevende modellen (GPT-4, Gemini, Claude 3.5 Sonnet, enz.) komen qua prestaties zeer dicht in de buurt. Voor algemene taken. Naarmate het technische niveau uniformer wordt, verschuift de strijd van wie de meeste parameters heeft naar wie de meeste frictie voor gebruikers wegneemt, met name voor gebruikers die elders al context hebben opgebouwd.
Hoe Claude's aangepaste geheugen in de praktijk werkt
Claude integreert een aangepast geheugen waarmee hij relevante details over elke gebruiker gedurende een bepaalde tijd onthouden.Zo hoef je niet steeds hetzelfde te herhalen. Dit geheugen wordt gevuld door zowel normale interacties als de nieuwe importfunctie.
Het importproces is zo ontworpen dat het zo soepel mogelijk verloopt: het typische proces bestaat uit: Exporteer of extraheer uw voorkeuren en context vanuit de andere assistent en plak deze in een specifieke Claude-interface.Vervolgens analyseert het systeem de tekst, identificeert de belangrijkste gegevens en integreert deze in zijn eigen gestructureerde geheugenrepresentatie.
Tot de dingen die Claude zich nog kan herinneren behoren de volgende: Uw communicatiestijl, de toon die u in uw antwoord wenst, professionele en zakelijke informatie., lopende projecten, voorkeursformaten voor opleveringen, of relevante technische informatie over uw toolstack.
Bovendien is deze herinnering Het wordt niet bevroren in de tijd.Naarmate je Claude gebruikt, wordt het programma automatisch bijgewerkt en verfijnd op basis van nieuwe gegevens, wijzigingen in prioriteiten of aanpassingen die je maakt. Importeren is dus slechts het begin; de relatie ontwikkelt zich met het gebruik.
In de betaalde abonnementen voor gevorderde gebruikers en teams (Pro en Team) wordt deze geheugencapaciteit een duidelijk operationeel voordeel voor startups, technische teams en organisaties die een groot deel van hun dagelijkse werk op AI baserenHet stelt je in staat een soort "permanent profiel" op te bouwen, waardoor de assistent steeds meer gaat lijken op een medewerker die al betrokken is bij jouw onderwerpen.
Voordelen voor startups en technische teams
Voor oprichters, CTO's en productteams die constant met AI-modellen werken, heeft aangepast geheugen een directe impact op de dagelijkse werkzaamheden: Het vermindert wrijving, verbetert de consistentie en bevordert interne samenwerking..
Enerzijds hoef je niet langer in elk gesprek de zakelijke context, je productarchitectuur of de doelstellingen van elke sprint te herhalen. Claude kan om veel van die gegevens als vanzelfsprekend te beschouwen en ze te gebruiken vanaf het eerste antwoord.Dit betekent dat er minder tijd verloren gaat aan het contextualiseren en er meer tijd overblijft voor het ontvangen van bruikbare suggesties.
Aan de andere kant, wanneer de assistent onthoudt dat uw startup bijvoorbeeld gebruikmaakt van... Next.js, een bepaalde documentatiestijl en dat je de voorkeur geeft aan beknopte, actiegerichte antwoorden.De mate van aanpassing aan uw behoeften is veel groter. Het begint niet elke keer helemaal opnieuw, maar vanuit een reeds verfijnd profiel.
Bovendien is in de teamplannen het volgende opgenomen: Een deel van dat contextuele geheugen kan door meerdere leden worden gedeeld.Dit voorkomt dat elke medewerker de assistent helemaal opnieuw moet "trainen" en helpt om de toon en het detailniveau binnen de verschillende afdelingen (product, marketing, verkoop, ondersteuning) op elkaar af te stemmen.
Gebruikssituaties waarin het importeren van geheugen een verschil maakt.
Er zijn diverse scenario's waarin geheugenimport, zoals voorgesteld door Anthropic, voordelen kan bieden. onmiddellijke en zeer zichtbare voordelen in de dagelijkse werkzaamheden van een bedrijf of professional.
Migratie van schrijf- en communicatieprocessen
Als je tot nu toe een andere tool voor contentcreatie hebt gebruikt (voor berichten, nieuwsbrieven, communicatie met investeerders, interne documentatie), heb je waarschijnlijk al tijd besteed aan het aanpassen ervan. toon, structuur, lengte, typische voorbeelden, merkreferentiesenz. Door het geheugen naar Claude te importeren, kunt u vrijwel verdergaan waar u gebleven was, in een vergelijkbare stijl, maar met de voordelen van het nieuwe model.
Continuïteit in data-analyse en rapportage
Degenen die AI gebruiken om statistieken te interpreteren, gebruikersfeedback te analyseren of periodieke samenvattingen op te stellen, trainen vaak de assistent. Welke KPI's zijn belangrijk, welke cijfers zijn ruis, hoe structureer je rapporten? en welk weergaveformaat ze prefereren. Met geheugenimport kan Claude die criteria direct verwerken en wekenlange aanpassingen voorkomen.
Productontwikkeling en computerondersteund programmeren
In ontwikkelomgevingen is het gebruikelijk dat de assistent dingen "leert" zoals De technologie-stack van het bedrijf, codeerconventies, architectuurpatronen, voorkeursbibliotheken of reeds genomen ontwerpbeslissingen. Het overzetten van die informatie naar een ander model maakt het verschil tussen een "junior" aan de andere kant en iemand die al goed thuis is in je project.
Technische en privacygegevens ter nagedachtenis aan Claude
Een van de logische vragen bij het bespreken van geheugenportabiliteit is wat er met de gegevens gebeurt zodra ze in het nieuwe systeem staan. Anthropic heeft hierover duidelijke richtlijnen gepubliceerd. Hoe wordt aangepast geheugen opgeslagen en beheerd in Claude?Deze zijn met name relevant voor startups die met gevoelige informatie werken.
Het geheugen wordt op een bepaalde manier bewaard. versleuteld en door de gebruiker te beherenU kunt de gegevens die de assistent over u heeft opgeslagen op elk gewenst moment bekijken, bewerken of verwijderen. Zo kunt u controleren wat er is opgeslagen en het detailniveau aanpassen als u zich ergens ongemakkelijk bij voelt, en in geval van openbare incidenten (bijvoorbeeld, hacker gebruikte ClaudeHet is raadzaam om aandacht te besteden aan retentiebeleid.
In omgevingen met meerdere gebruikers stelt het bedrijf dat Geheugen wordt niet gedeeld tussen verschillende organisaties binnen teamplannen.Met andere woorden: elke organisatie behoudt een eigen domein, waardoor ongewenste vermenging van contexten tussen klanten wordt voorkomen.
Een relevant punt is dat Anthropic een expliciet beleid hanteert van Gebruik het aangepaste geheugen van gebruikers niet om uw basismodellen opnieuw te trainen.Dit, in combinatie met de optie voor selectieve verwijdering, verkleint het risico dat gevoelige informatie reacties buiten uw eigen omgeving beïnvloedt.
Hoe werkt de functie "Geheugen importeren" precies?
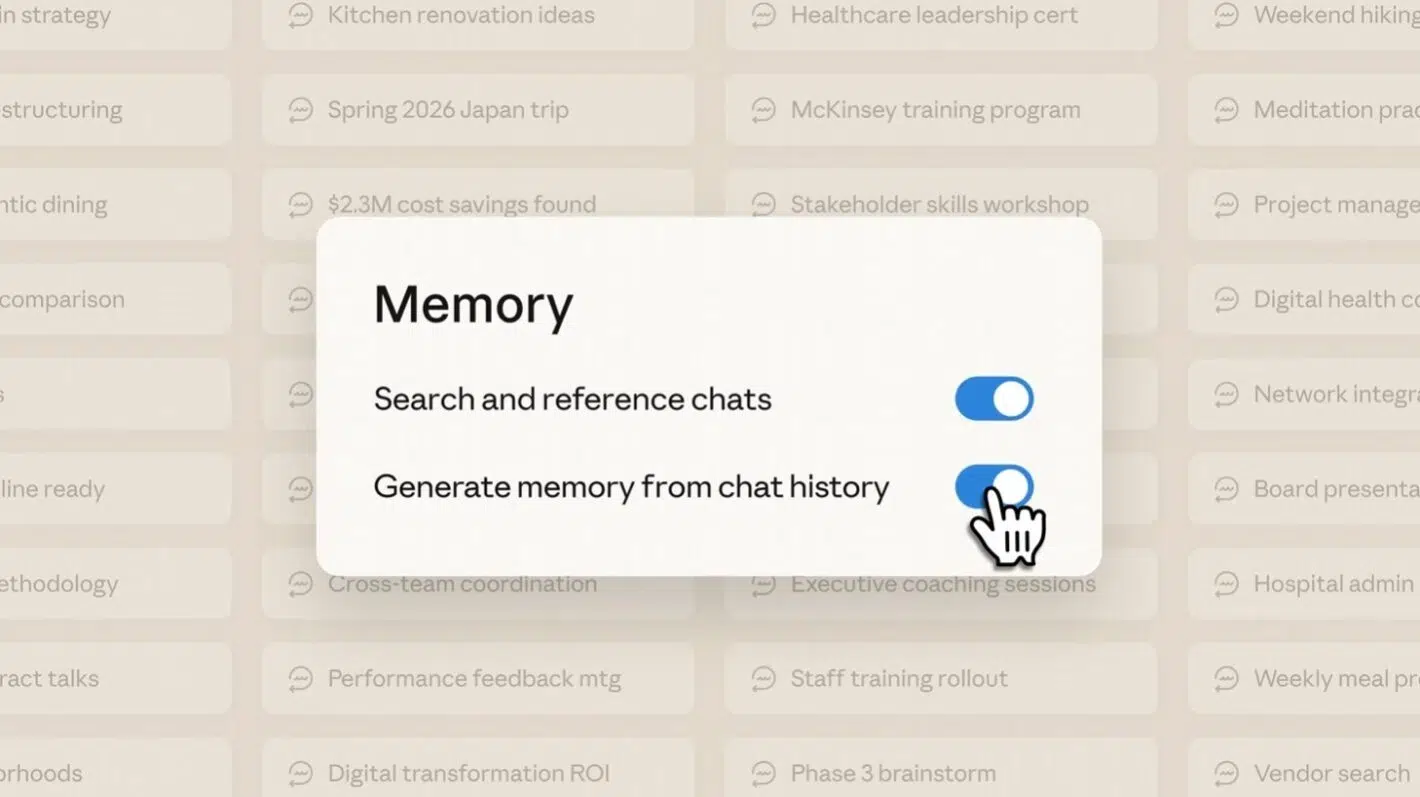
De geheugenimportfunctie is gebaseerd op een nogal ingenieuze idee: Gebruik een standaard prompt om het bronmodel op een gestructureerde manier alles te laten weergeven wat het over u heeft geleerd.Er is geen officiële API voor geheugenexport nodig; het gedrag van het model zelf wordt benut.
Het proces bestaat, grofweg, uit twee stappen. In de eerste stap kopieert u een door Anthropic opgestelde tekst en plakt u deze in uw huidige spraakassistent (bijvoorbeeld ChatGPT). Die tekst geeft de assistent een zeer gedetailleerde opdracht: breng alle "herinneringen" die over jou zijn opgeslagen aan het licht.Van instructies voor stijl, toon en opmaak tot persoonlijke gegevens (naam, locatie, beroep, gezin, interesses), terugkerende projecten en doelen, tools, talen en frameworks die u gebruikt.
Dat bericht vereist ook het originele model Lever de informatie aan in een duidelijk kopieerbaar blok, met een consistente opmaak per record. (datum, indien beschikbaar, plus de inhoud van het geheugen) en dat er niets wordt weggelaten of dat de informatie overmatig wordt gegroepeerd. Het idee is om een zo compleet mogelijke lijst te krijgen van alles wat het systeem denkt over u te weten.
In de tweede stap neem je dat tekstblok en plak je het in de geheugenconfiguratiepagina van Claude. Van daaruit zal het systeem Het verwerkt de informatie, standaardiseert deze en integreert deze in zijn eigen interne systeem.Het voert geen letterlijke dump uit, maar vertaalt de gegevens naar een gestructureerd geheugenformaat.
Anthropic waarschuwt dat geïmporteerd geheugen Het wordt niet meteen geactiveerd, maar het kan tot 24 uur duren voordat het volledig is geïntegreerd.De reden hiervoor is dat Claude zijn herinneringen dagelijks bijwerkt via een synthesemechanisme, in plaats van elk stukje informatie in realtime op te slaan. Een ander belangrijk detail is dat de import niet overschrijft wat Claude al over je weet, maar in plaats daarvan probeert beide bronnen op een intelligente manier samen te voegen.
Het is belangrijk te benadrukken dat dit proces onafhankelijk is van elke API of officiële integratie met andere aanbieders. OpenAI biedt bijvoorbeeld geen eigen interface voor het exporteren van geheugen.Anthropic omzeilt dit door standaardinstructies te gebruiken die elke gebruiker kan kopiëren en plakken. Het is een manier om platformbarrières letterlijk te omzeilen zonder de voorwaarden te schenden.
Vergelijking met andere benaderingen: chats versus gedistilleerd geheugen
Naast het voorstel van Anthropic zijn andere aanbieders begonnen met het onderzoeken van importfuncties die zich voornamelijk richten op Lever complete gespreksgeschiedenissen aanEen voorbeeld hiervan is het testen van bepaalde functies van "AI-chats importeren" in modellen zoals Gemini.
Het belangrijkste verschil is dat De onbewerkte gegevens bevatten alles: specifieke vragen, snelle tests, irrelevante gesprekken. En er is veel ruis die niet per se nuttig is om als stabiel geheugen te bewaren. Als je de context van het model voedt met al dat ongefilterde materiaal, zou je de prestaties ervan wel eens kunnen verslechteren in plaats van verbeteren.
Het voorstel van Anthropic richt zich op iets anders: een "geconcentreerde" herinnering in de vorm van een gestructureerde samenvatting van wat het model van je heeft geleerd.Het haalt niet elk gesprek woord voor woord terug, maar wel de essentiële elementen die nuttig zijn om toekomstige reacties te personaliseren. Dit maakt het importproces overzichtelijker, privacyvriendelijker en minder vatbaar voor rommel in de context van het model.
De strategische impact: de afhankelijkheid van OpenAI doorbreken en de markt veranderen.
Dit alles gebeurt niet in een vacuüm. De actie van Anthropic wordt algemeen geïnterpreteerd als een directe aanval op de concurrentievoordelen die OpenAI rond ChatGPT heeft opgebouwd.vooral in het massamarktsegment.
Historisch gezien heeft OpenAI zichzelf gepositioneerd als het meest zichtbare gezicht van consumenten-AIHet bedrijf bereikt miljoenen gebruikers in recordtijd, heeft een constante mediapresence en een alomtegenwoordige CEO op tours en conferenties. De kracht ligt zowel in de technische kwaliteit van de modellen als in de beproefde werkwijzen: de mensen zijn er al, met hun geschiedenis en workflows.
Anthropic heeft zich daarentegen gepresenteerd als een meer discrete speler die zich richt op zakelijke klanten met zeer hoge eisen op het gebied van beveiliging en controle.Banken, advocatenkantoren, onderzoeksinstellingen. Hun verhaal is gericht op betrouwbaarheid en veiligheid, niet zozeer op overbevolking.
De laatste tijd is het publieke discours echter veranderd. Politieke beslissingen en overeenkomsten met overheidsinstanties hebben hiertoe geleid. Kritiek op OpenAI en sympathie voor Anthropic in bepaalde gebruikerssegmenten. In die omgeving fungeert de geheugenimportfunctie als een "chirurgische ingreep": net wanneer velen overwegen over te stappen, wordt hen een ontsnappingsroute geboden die de overstapkosten minimaliseert.
Het gevolg is dat OpenAI niet langer zo sterk kan vertrouwen op de “Mensen blijven omdat ze er al aan gewend zijn.”Als het vasthouden aan herinneringen geen lange reis meer is, maar een proces in twee stappen, verschuift het werkelijke gewicht naar de kwaliteit van elk model in elke iteratie. Emotionele en contextuele binding verliest aan kracht als verdediging van marktaandeel.
Geheugenvergrendeling in besturingssystemen en realtime: de andere betekenis van de term
Het moet worden verduidelijkt dat "geheugenvergrendeling" ook een klassieke technische betekenis in besturingssystemen en realtime programmeringDit heeft niet zozeer te maken met AI-assistenten, maar eerder met hoe het geheugen wordt beheerd in cruciale processen.
In systemen zoals SunOS en afgeleiden hebben realtime-applicaties het volgende nodig: om ervoor te zorgen dat bepaalde geheugenpagina's in het RAM-geheugen blijven.om te voorkomen dat het besturingssysteem ze naar de schijf wegschrijft (paging of swapping) en voor diagnostische doeleinden, zoals de memory.dmp-bestandAls het geheugen dat nodig is voor een taak met lage latentie naar de schijf wordt verplaatst, neemt de toegangstijd toe en vervalt elke garantie op een deterministische respons.
Hiervoor zijn er bibliotheekaanroepen zoals mlock(3C), munlock(3C) of mlockall(3C)Hiermee kunnen processen met supergebruikersrechten specifieke segmenten van hun adresruimte in het fysieke geheugen vergrendelen. Door deze pagina's te vergrendelen, verhoogt het systeem een vergrendelingsteller; zolang deze teller groter is dan nul, wordt de pagina uitgesloten van normale paging.
Hetzelfde geheugenblok kan zijn geblokkeerd door meerdere processen of meerdere keren via verschillende toewijzingenIn de praktijk houdt het systeem een teller bij voor elke pagina die vergrendelingen verzamelt. Wanneer alle vergrendelingen worden opgeheven (bijvoorbeeld door de functie munlock aan te roepen), wordt de teller gereset naar nul en komt de pagina weer in aanmerking om naar de schijf te worden verplaatst.
Als een proces de toewijzing verwijdert waarmee het een pagina had geblokkeerd (bijvoorbeeld door een toegewezen bestand te sluiten of in te korten), Het systeem ontgrendelt dat segment impliciet.Op dezelfde manier geldt dat als een pagina wordt verwijderd omdat het onderliggende bestand verdwijnt, deze niet langer in het geheugen is opgeslagen.
Het is belangrijk om op te merken dat deze blokken Ze worden niet overgeërfd na een fork(2)Als een proces met vergrendeld geheugen een subproces aanmaakt, moet dat subproces zijn eigen vergrendelingsaanroepen uitvoeren om residentie te garanderen. Anders zal het last krijgen van copy-on-write paginafouten of andere problemen die kenmerkend zijn voor dubbele processen.
Besturingssystemen leggen doorgaans een Wereldwijde limiet voor het aantal pagina's dat tegelijkertijd geblokkeerd kan worden.Deze limiet wordt bij het opstarten berekend, meestal als een fractie van het totale aantal beschikbare paginakaders, met een marge (bijvoorbeeld 10%) om overbelasting van het systeem te voorkomen. Het overschrijden van deze limiet leidt vaak tot fouten bij blokkerende aanroepen.
Er bestaat zelfs de figuur van de zogenaamde “plakkerige sloten”Pagina's waarvan de blokkeringsteller de maximale waarde bereikt (bijvoorbeeld 65535 of 0xFFFF) worden als permanent geblokkeerd beschouwd. Ze kunnen niet op normale wijze worden vrijgelaten.De enige praktische manier om ze terug te krijgen is door het systeem opnieuw op te starten, wat het belang onderstreept van het zorgvuldig gebruiken van deze mechanismen.
Samenvattend verwijst "geheugenvergrendeling" op systeemniveau naar het volgende: Zorg voor voldoende geheugenresidentie om aan realtimevereisten te voldoen en de latentie te minimaliseren.In de context van AI-producten hebben we het echter over iets anders: de gebruiker zit vast aan een platform vanwege opgebouwde persoonlijke herinneringen. Dit zijn twee totaal verschillende werelden die door dezelfde metafoor worden verenigd: iets vastleggen in het geheugen, waardoor het erg moeilijk wordt om het te verplaatsen.
Een paradigmaverschuiving in hoe we AI-geheugen begrijpen.
Al deze ophef rondom het fenomeen 'geheugenblokkering' dwingt tot een heroverweging. Wat is geheugen in AI-systemen, wie is de eigenaar ervan en hoe moet het tussen verschillende tools worden overgedragen?Wat we ooit beschouwden als simpele chats, wordt nu gezien als een opgebouwd bezit dat afhankelijkheid creëert en tegelijkertijd een enorme kans biedt als het draagbaar wordt gemaakt.
Voorstellen voor draagbaar native geheugen, oproepen tot open standaarden, overbruggingstools en initiatieven zoals Claude's geheugenimport wijzen allemaal in dezelfde richting: Beschouw je geschiedenis met AI niet langer als afval, maar als een waardevolle troef.Naarmate meer gebruikers controle over dat bezit eisen, wordt het voor aanbieders steeds moeilijker om vast te houden aan vendor lock-in als hun primaire strategie.


Ik ben een technologieliefhebber die van zijn 'nerd'-interesses zijn beroep heeft gemaakt. Ik heb meer dan 10 jaar van mijn leven doorgebracht met het gebruik van de allernieuwste technologie en het sleutelen aan allerlei programma's uit pure nieuwsgierigheid. Nu heb ik mij gespecialiseerd in computertechnologie en videogames. Dit komt omdat ik al meer dan vijf jaar voor verschillende websites over technologie en videogames schrijf en artikelen heb gemaakt die proberen u de informatie te geven die u nodig heeft in een taal die voor iedereen begrijpelijk is.
Als je vragen hebt, mijn kennis strekt zich uit van alles wat te maken heeft met het Windows-besturingssysteem tot Android voor mobiele telefoons. En mijn toewijding is aan jou, ik ben altijd bereid om een paar minuten te besteden en je te helpen bij het oplossen van eventuele vragen die je hebt in deze internetwereld.