- Het VRAM-geheugen van de grafische kaart is bepalend voor de snelheid en het vermogen om grote modellen te draaien.
- Het RAM-geheugen van het systeem fungeert als een cruciale back-up wanneer het model de capaciteit van de GPU overschrijdt, waardoor systeemcrashes worden voorkomen.
- Er zijn drie niveaus van hardware, afhankelijk van het gebruik: van basisapparatuur voor tekstverwerking tot professionele werkstations voor omvangrijke modellen en visuele generatie.
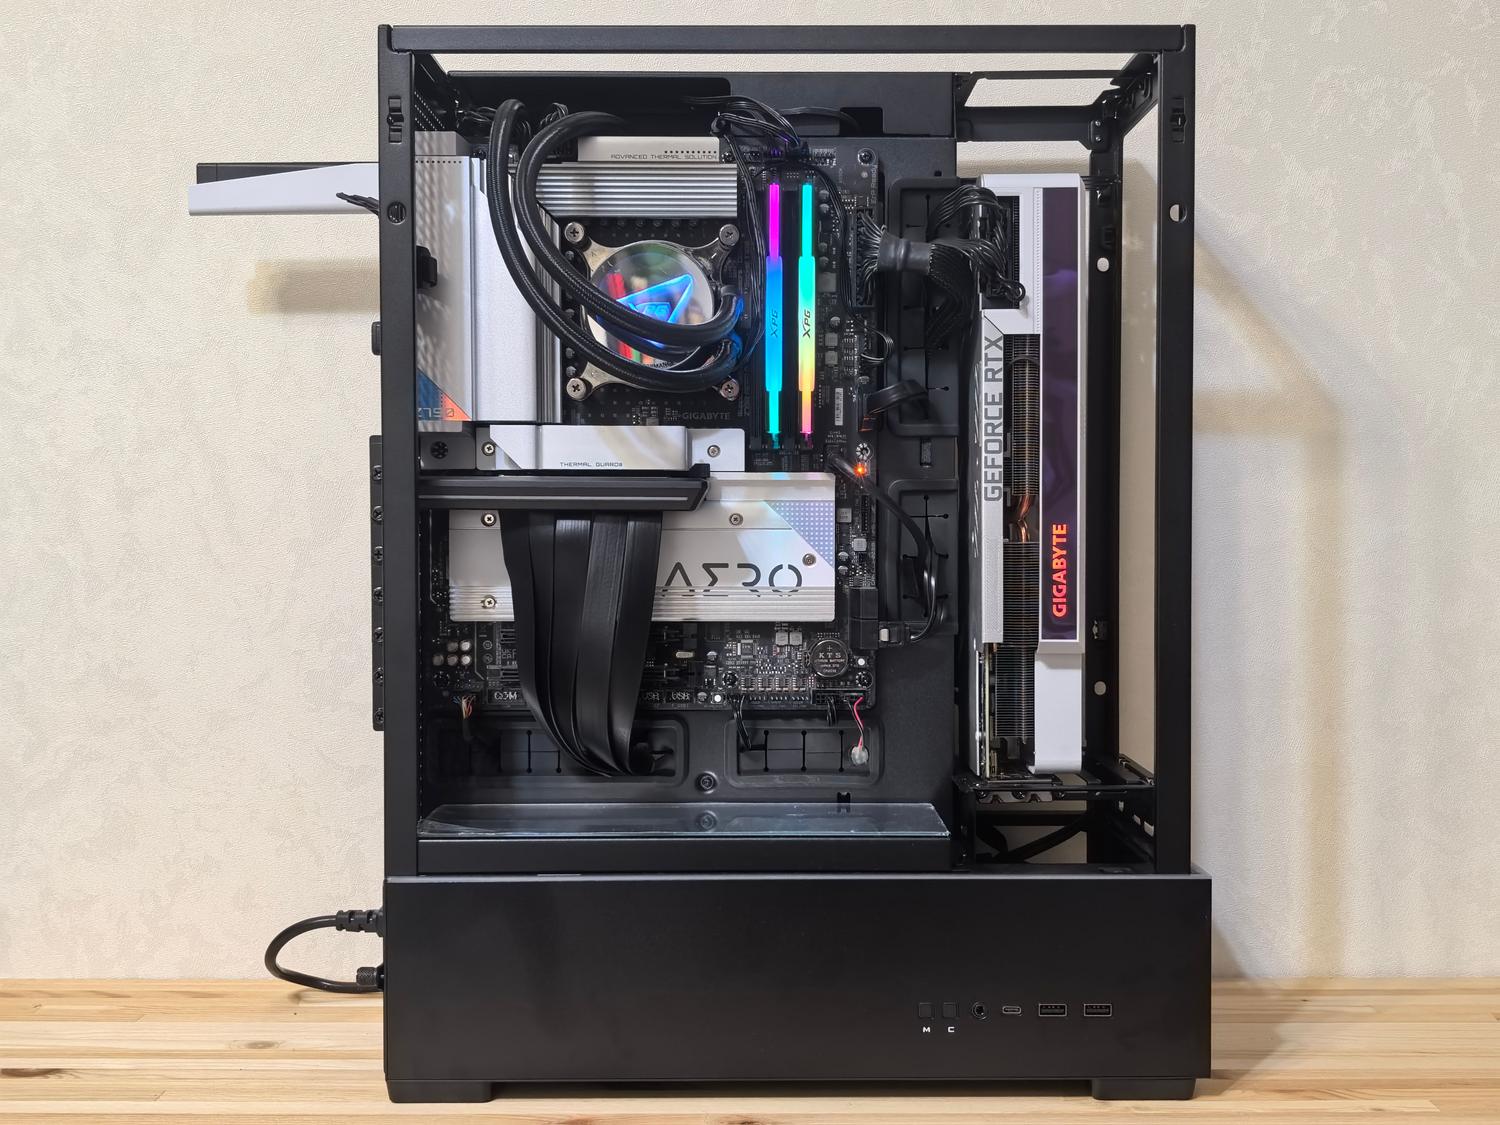
Je hebt vast wel gemerkt dat kunstmatige intelligentie niet langer alleen voor de gigantische servers van OpenAI of Google is weggelegd. Dankzij open modellen kun je nu je eigen digitale brein bouwen in je woonkamer. Door een LLM lokaal uit te voeren, kun je... Alle verwerking vindt plaats op uw hardware....zonder dat er ook maar één woord van uw prompts naar een externe server wordt verzonden. Dit is niet zomaar een bevlieging van computerprogrammeurs, maar een perfect haalbare optie voor iedereen die op zoek is naar... Absolute privacy, totale controle En vergeet maandelijkse abonnementen maar.
Maar hier begint het probleem: wat moet je in vredesnaam kopen? Het is niet hetzelfde als een pc bouwen om Fortnite te spelen. In AI-games gelden andere regels, en Het geheugen is allesbepalend.Als je de verkeerde componenten kiest, kan het zijn dat je een machine krijgt die er een eeuwigheid over doet om te reageren of die gewoon uitvalt omdat het model niet in het geheugen past. Laten we het eens nader bekijken om te voorkomen dat je geld verspilt. welke onderdelen zijn nu echt cruciaal en hoe je je apparatuur configureert op basis van wat je ermee wilt doen.
Waarom zou je AI lokaal uitvoeren?
De hamvraag is: waarom zou je dit doen als je ChatGPT met één klik tot je beschikking hebt? Het antwoord komt neer op drie belangrijke punten: privacy, kosten en controleVoor een advocaat die vertrouwelijke contracten behandelt of een ontwikkelaar met bedrijfseigen code, is het verzenden van gegevens naar een externe API een onaanvaardbaar juridisch risico. Door AI lokaal uit te voeren, De gegevens verlaten nooit de perimeter. van uw computer, waardoor elk risico op lekken wordt geëlimineerd.
Wat het budget betreft, hoewel de initiële investering in hardware aanzienlijk is, de kosten per token zijn nulJe hoeft je geen zorgen te maken over torenhoge rekeningen voor intensief gebruik; je betaalt alleen voor de elektriciteit die je apparatuur verbruikt. Bovendien heb je de vrijheid om te experimenteren. gekwantiseerde modellen en aangepaste versies die cloudproviders je niet laten aanraken, die zelfs zonder internetverbinding werken.
De hardware: waar de strijd wordt beslist
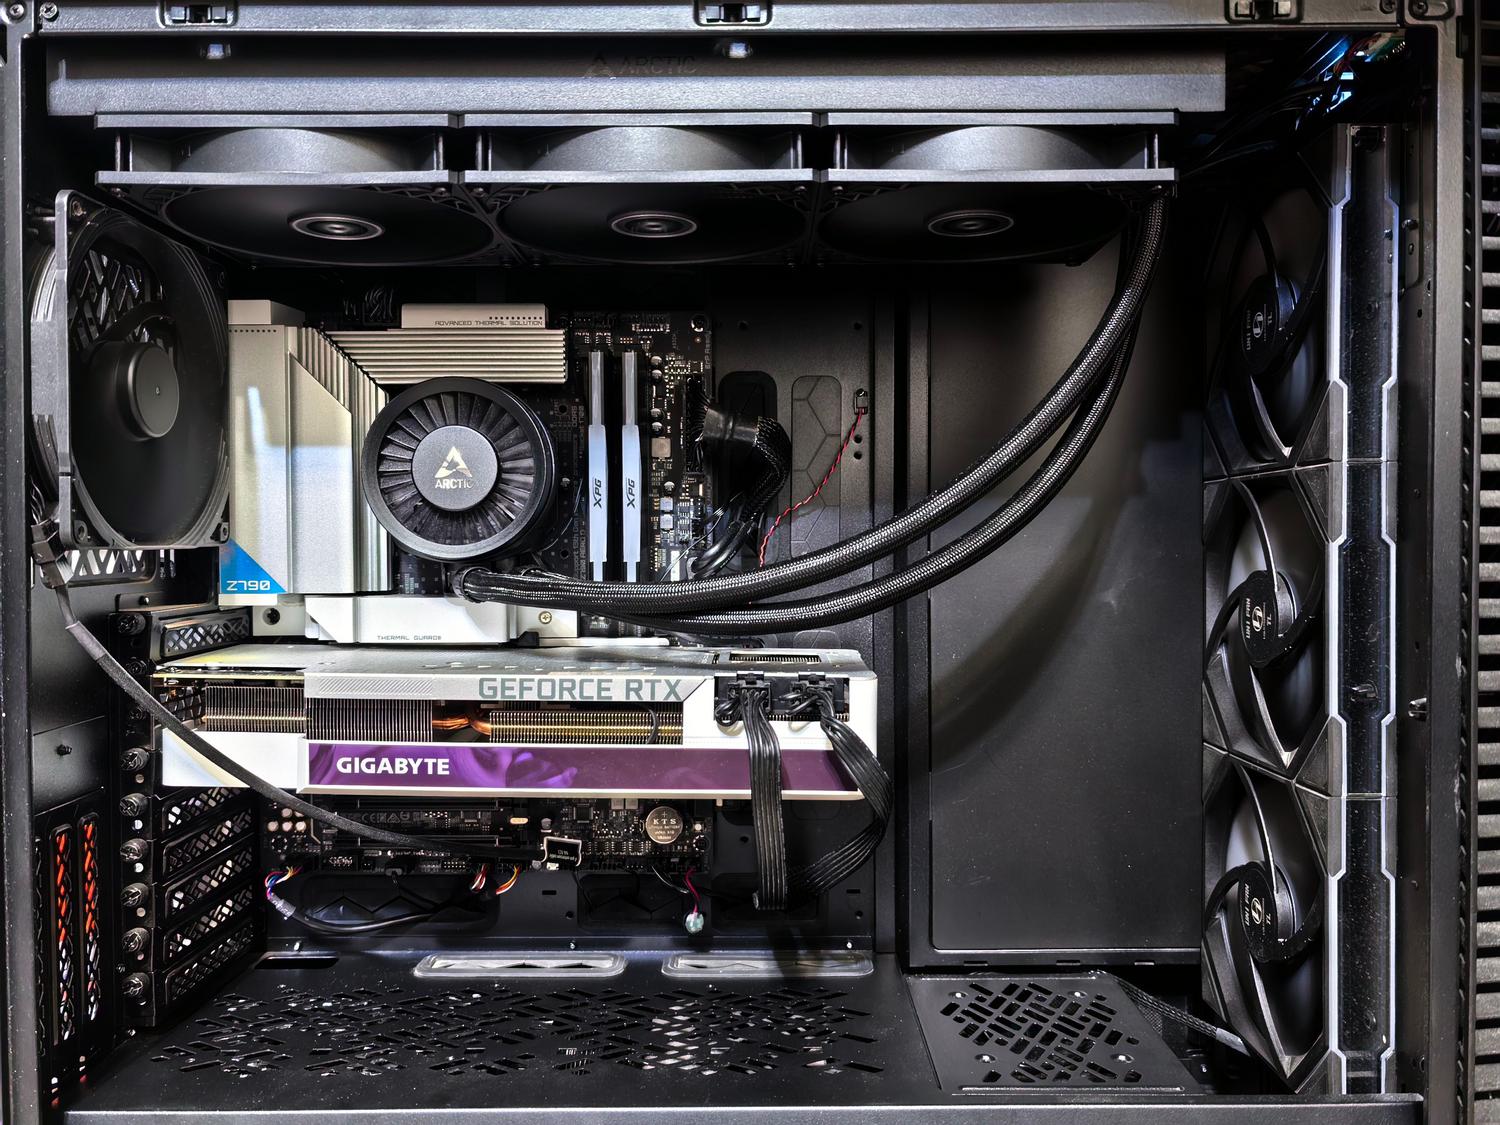
Als er één ding is dat je voor altijd in je geheugen moet prenten, dan is het dit: Het VRAM van de GPU vormt de bottleneck.VRAM is het ultrasnelle geheugen van de grafische kaart waarin het model is opgeslagen. Als het volledige model erin past, zal de generatiesnelheid vloeiend zijn (meer dan 50 tokens per seconde). Als het er niet in past, voert het systeem een vertraging uit. gedeeltelijke offload naar systeem-RAMEn dat is waar de prestaties drastisch afnemen, omdat de PCIe-bus veel trager is.
Het belang van de GPU en VRAM
Voor de meeste gebruikers, NVIDIA is de veiligste optie. Dit komt door het CUDA-ecosysteem, dat de standaard is in vrijwel alle AI-bibliotheken zoals PyTorch. Afhankelijk van de modelgrootte (gemeten in parameters, zoals 7B of 70B) heb je verschillende mogelijkheden nodig:
- Basisniveau (modellen 7B-8B): Je hebt minimaal 8-12 GB VRAM nodig. Een RTX 3060 met 12 GB of een RTX 5060 zijn uitstekende instapmodellen.
- Gemiddeld niveau (modellen 13B-34B): Hier hebben we het over 16-24 GB VRAM. Met een RTX 4090 of 5090 kun je deze modellen soepel en met veel meer rekenkracht draaien.
- Professioneel niveau (modellen 70B+): We betreden nu het domein van 48 GB VRAM of meer. Dit vereist multi-GPU-configuraties (meerdere kaarten die het geheugen uitbreiden) of professionele kaarten uit de RTX PRO-serie.
RAM, SSD en de nieuwe NPU
Hoewel de GPU de ster van de show is, mag de rest geen last zijn. 32 GB RAM is de minimale standaard. Om problemen te voorkomen. Als u van plan bent grote modellen te gebruiken die niet op de grafische kaart passen, is upgraden naar 64 GB of 128 GB de slimste keuze. Wat opslag betreft, een NVMe Gen 4 of 5 SSD Het is noodzakelijk; het laden van een 30 GB-model vanaf een mechanische schijf is een ware kwelling die minuten in plaats van seconden kan duren.
Ze zijn ook verschenen Copilot+ pc met NPU (Neurale verwerkingseenheden). Deze chips zijn geweldig voor lichte achtergrondtaken, zoals het vervagen van de achtergrond tijdens een videogesprek of het gebruik van eenvoudige Windows-assistenten zonder de batterij leeg te trekken, maar Ze vervangen de GPU niet. wanneer je grote afbeeldingen wilt genereren of een complexe LLM wilt uitvoeren.
Configuraties afhankelijk van het beoogde gebruik
Niet iedereen heeft een supercomputer nodig. Afhankelijk van of je alleen tekst, afbeeldingen of een compleet lab nodig hebt, variëren de vereisten:
1. Alleen tekst (lokale LLM's)
Als je doel is om te chatten, teksten samen te vatten of te programmeren, kun je je wat flexibeler opstellen. Mac met Apple Silicon (M3/M4) Het is een fantastische optie dankzij het uniforme geheugen, waarbij de GPU direct gebruikmaakt van het systeem-RAM. Op Windows, met een RTX met 12 GB en 32 GB RAM Modellen met 7-8 GB zijn meer dan voldoende. Als je iets krachtigers maar goedkoper wilt, zijn mini-pc's met Ryzen-processors en uitbreidbaar RAM-geheugen een interessant alternatief voor het opzetten van een thuisserver.
2. Tekst- en beeldgeneratie (stabiele diffusie, FLUX)
Hier verandert de situatie. Visuele weergave verbruikt veel VRAM. Om fouten te voorkomen... "Uit het geheugen"Gebruik minimaal 16 GB VRAM. De workflow met tools zoals ComfyUI vereist dat model- en afbeeldingsgewichten snel worden verwerkt. RTX 4080 of 5080 Het is de ideale oplossing voor wie professionele kwaliteit wil, maar niet de prijs van een auto wil betalen.
3. Professioneel gebruik en AI-agenten
Voor wie interactieve agenten bouwt of modellen verfijnt, is stabiliteit essentieel. Je hebt nodig vloeistofgekoelde werkstations en voedingen van 1000W of meer, aangezien de GPU urenlang op 100% belasting zal draaien. Op dit niveau is het aan te raden te kijken naar desktop-supercomputers met een enorm, uniform geheugen (zoals die gebaseerd op GB10-chips) waarmee modellen met maximaal 200 miljard parameters kunnen worden verwerkt.
Essentiële hulpmiddelen om te beginnen
De hardware in huis hebben is maar de helft van het werk. Om het werkend te krijgen zonder al te veel gedoe met de terminal, zijn er een aantal zeer geavanceerde applicaties beschikbaar. Ollama is de ideale motorHet is lichtgewicht, snel en creëert een lokale server die andere apps kunnen gebruiken. Als je de voorkeur geeft aan iets visueels, LM Studio is het kroonjuweel.waardoor je HuggingFace-sjablonen kunt downloaden en met een paar klikken kunt configureren.
Om alles in je dagelijkse workflow te integreren, zijn er clients zoals Levante of Cherry StudioHiermee kunt u binnen dezelfde chat schakelen tussen een lokaal model (voor privégegevens) en een cloudgebaseerd model (voor zeer complexe redeneringen). Zo profiteert u van het beste van twee werelden: Cloudkracht en beveiliging op locatie.
De juiste apparatuur kiezen hangt volledig af van of je prioriteit geeft aan de draagbaarheid van een laptop met een NPU, de veelzijdigheid van een NVIDIA-desktop of de efficiëntie van een Mac. De sleutel is om niet te bezuinigen op de VRAM- en RAM-capaciteit van de grafische kaartDit zijn de enige componenten die bepalen of uw AI een soepele assistent is of een last die uw hele systeem vertraagt. Nu weet u welke pc u nodig hebt om AI-modellen lokaal op Windows uit te voeren. (Vereistenoverzicht)

Gepassioneerd door technologie sinds hij klein was. Ik houd ervan om op de hoogte te zijn van de sector en vooral om deze te communiceren. Daarom houd ik mij al jaren bezig met communicatie op technologie- en videogamewebsites. Je kunt mij vinden als ik schrijf over Android, Windows, MacOS, iOS, Nintendo of elk ander gerelateerd onderwerp dat in je opkomt.