- Integracja lokalnych modeli językowych z wykorzystaniem Ollama i platformy orkiestracji Dify.
- Wdrożenie systemów RAG umożliwiających przetwarzanie prywatnych dokumentów bez konieczności korzystania z chmury.
- Optymalizacja zasobów sprzętowych i konfiguracja sieci w kontenerach Docker.
- Tworzenie zaawansowanych przepływów pracy z logiką warunkową i wyspecjalizowanymi agentami.
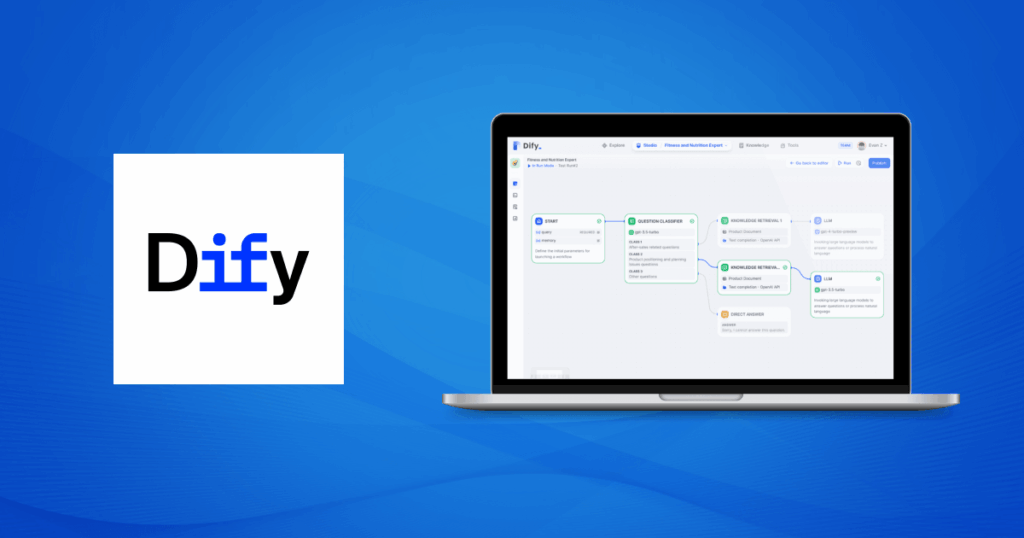
To kuszące Zbuduj własny ekosystem sztucznej inteligencjiIstnieje jednak obawa, że Twoje dane mogą zostać wysłane na nieznane serwery. Jednym ze sposobów uniknięcia tego jest Połącz Dify z OllamąPołączenie to działa: Dify to niezwykle elastyczna platforma do tworzenia aplikacji LLM, a Ollama jest standardem w uruchamianiu modeli lokalnych.
Nie musisz być guru programowania, aby to osiągnąć, ponieważ Dify oferuje wizualny interfejs, który pozwala projektować złożone przepływy pracy bez konieczności pisania ani jednej linijki kodu. Jeśli jednak lubisz majsterkować przy oprogramowaniu, odkryjesz, że jego możliwości… eksport do Pythona To prawdziwa perełka, która pozwoli Ci przenieść swoje projekty na wyższy poziom.
Czym właściwie są Dify i Ollama?
Aby rozpocząć łączenie Dify z Ollamą od podstaw, ważne jest, aby wiedzieć, czym jest każdy z nich. Rozróżnić Jest to narzędzie do Oprogramowanie LLMOps o otwartym kodzie źródłowym Pełni funkcję centrum dowodzenia. Pozwala integrować różne modele, zarządzać bazami wiedzy i tworzyć agenty, które faktycznie działają. Co najważniejsze, nie ogranicza Cię do jednego modelu; możesz łączyć usługi chmurowe z modelami lokalnymi w razie potrzeby.
Z drugiej strony, Ollama To jest część, która jest odpowiedzialna za podnieś modele (takich jak Llama 3, Gemma czy DeepSeek) bezpośrednio na Twoim komputerze lub serwerze. Uruchamiając wnioskowanie lokalnie, unikasz płacenia miesięcznych opłat za każdy wygenerowany token i zapewniasz bezpieczeństwo poufnych informacji Twojej firmy. pozostań w swojej sieci.
Podstawowe kroki do połączenia Dify z Ollamą
Pierwszym krokiem jest przygotowanie aplikacji Lama. Należy pobrać ją z oficjalnej strony internetowej i uruchomić wybrany model w terminalu. Na przykład, jeśli chcesz wypróbować najnowszą wersję Lamy, wystarczy uruchomić polecenie: ollama run llama3.2Ważne jest, aby serwer Ollama nasłuchiwał na wszystkich interfejsach; w tym celu należy skonfigurować zmienną środowiskową OLLAMA_HOST=0.0.0.0szczególnie jeśli zamierzasz używać Dockera.
W przypadku Dify najłatwiej jest użyć Docker Desktop. Wystarczy sklonować oficjalne repozytorium GitHub i przejść do folderu. docker, skopiuj przykładowy plik .env.example Jak .env i wykonaj docker-compose up -dPo uruchomieniu kontenerów będziesz mieć dostęp do panelu administracyjnego za pośrednictwem przeglądarki pod adresem localhost.
Konfiguracja połączenia: sztuczka z adresem URL bazowym
W tym miejscu wiele osób napotyka problem, próbując połączyć Dify z Ollamą. Ponieważ Dify działa w kontenerze Dockera, nie widzi bezpośrednio „localhost” Twojej maszyny. Aby obejść ten problem, w sekcji dostawców modeli Dify musisz dodać Ollamę i użyć adresu http://host.docker.internal:11434Most ten umożliwia komunikację interfejsu API Dify z silnikiem Ollama zainstalowanym w systemie Windows, Mac lub Linux.
Dodając model pamiętaj o podaniu dokładna nazwa z modelu pobranego w Ollama (na przykład, llama3), dostosuj rozmiar kontekstu i limit tokena zgodnie z możliwościami swojego sprzętu, aby zapobiec awarii systemu lub jego wolnej reakcji.
Wdrażanie RAG: Twoja własna baza wiedzy
Jedną z najpotężniejszych funkcji Dify jest Recall Augmented Generation (RAG). Pozwala ona sztucznej inteligencji nie tylko reagować na to, co już wie, ale także korzystać z innych źródeł. konkretne dokumenty które dostarczasz. Możesz przesłać instrukcje w formacie HTML lub PDF, a Dify zajmie się ich podziałem na łatwe do opanowania fragmenty zwane kawałki.
Te elementy są przekształcane w wektory przy użyciu modelu osadzanie (które mogą również pochodzić z Ollama) i są przechowywane w bazie danych, takiej jak Weaviate. Gdy zadajesz pytanie, system przeszukuje Twoje dokumenty w poszukiwaniu najistotniejszych informacji i przekazuje je do LLM w celu sporządzenia odpowiedzi. Oparte na prawdziwych wydarzeniach i nie w halucynacjach.
Od prostego chatbota do zaawansowanego przepływu pracy
Jeśli tradycyjny czat Ci nie odpowiada, Dify pozwala Ci go utworzyć przepływy pracy z logiką wizualną. Wyobraź sobie system, który najpierw klasyfikuje pytanie użytkownika: jeśli jest to pytanie techniczne, wysyła je do eksperta ds. kodowania; jeśli jest to pytanie administracyjne, przekierowuje je do bazy wiedzy firmy. Wszystko to odbywa się za pośrednictwem węzły decyzyjne (IF/ELSE) i specjalistyczne węzły LLM.
To podejście jest o wiele bardziej precyzyjne, ponieważ można napisać konkretne monity dla każdego etapu procesu. Możesz skonfigurować model tak, aby był zwięzły, zawierał przykłady kodu lub umożliwiał ograniczanie, jeśli odpowiedź nie znajduje się w dokumentacji, osiągając w ten sposób profesjonalne doświadczenie użytkownika.
Rozwiązywanie typowych problemów i optymalizacja
Mogą wystąpić pewne problemy podczas próby połączenia Dify z Ollamą. Jeśli pojawi się błąd „odmowa połączenia”, sprawdź, czy zapora sieciowa nie blokuje portu. 11434 i że Ollama jest rzeczywiście aktywna. Jeśli chodzi o wydajność, jeśli zauważysz, że sztuczna inteligencja porusza się w ślimaczym tempie, przejdź do konfiguracji Dockera i przypisz więcej pamięci RAM i procesora (przynajmniej 8 GB, jeśli to możliwe).
Kolejnym kluczowym punktem są sterowniki GPU. Aby Ollama mogła latać, potrzebuje dostępu do karty graficznej. Jeśli używasz NVIDIA, upewnij się, że masz… zaktualizowane sterowniki A jeśli wszystko uruchamiasz w Dockerze, skonfiguruj nvidia-container-runtime w pliku daemon.json tak aby kontenery mogły wykorzystać potencjał sprzętu.
Świetny pomysł, żeby połączyć Dify z Ollamą! Integracja tych narzędzi pozwala zbudować solidny system AI, w którym prywatność danych To priorytet, a koszty operacyjne są minimalizowane. Dzięki opanowaniu połączenia między orkiestracją Dify a lokalnym zasilaniem Ollama, zyskujesz infrastrukturę zdolną do skalowania od prostego asystenta na pulpicie do złożonego systemu zarządzania wiedzą dla każdego środowiska profesjonalnego.

Redaktor specjalizujący się w zagadnieniach technologii i Internetu z ponad dziesięcioletnim doświadczeniem w różnych mediach cyfrowych. Pracowałem jako redaktor i twórca treści dla firm z branży e-commerce, komunikacji, marketingu online i reklamy. Pisałem także na portalach poświęconych ekonomii, finansom i innym branżom. Moja praca jest także moją pasją. Teraz, poprzez moje artykuły w Tecnobits, staram się odkrywać wszystkie nowości i nowe możliwości, jakie świat technologii oferuje nam każdego dnia, aby poprawić nasze życie.