- As vozes sintéticas revelam padrões anômalos na prosódia, no timbre, nas pausas e na emoção.
- Detectores automáticos e marcas d'água ajudam, mas não são prova definitiva.
- A combinação de contexto, protocolos de verificação e biometria de voz aumenta a segurança.
- A voz é um dado biométrico protegido e seu uso é regulamentado pelo GDPR e pela Lei de Inteligência Artificial da UE.

Vivemos em uma época em que qualquer um pode clonar uma voz com apenas alguns segundos de áudioDesde ligações fraudulentas se passando por membros da família até áudios virais de políticos ou celebridades, distinguir se uma voz é autêntica ou gerada por inteligência artificial tornou-se uma habilidade básica de sobrevivência digital.
Embora os modelos de síntese de fala estejam melhorando a um ritmo impressionante, ainda existem desafios. Sinais acústicos, visuais e contextuais que denunciam um deepfake de áudio.Além disso, ferramentas de detecção, marcas d'água digitais e protocolos específicos estão começando a surgir para empresas e administrações que desejam se proteger contra esse tipo de fraude.
O que é um deepfake de voz e como ele é gerado?
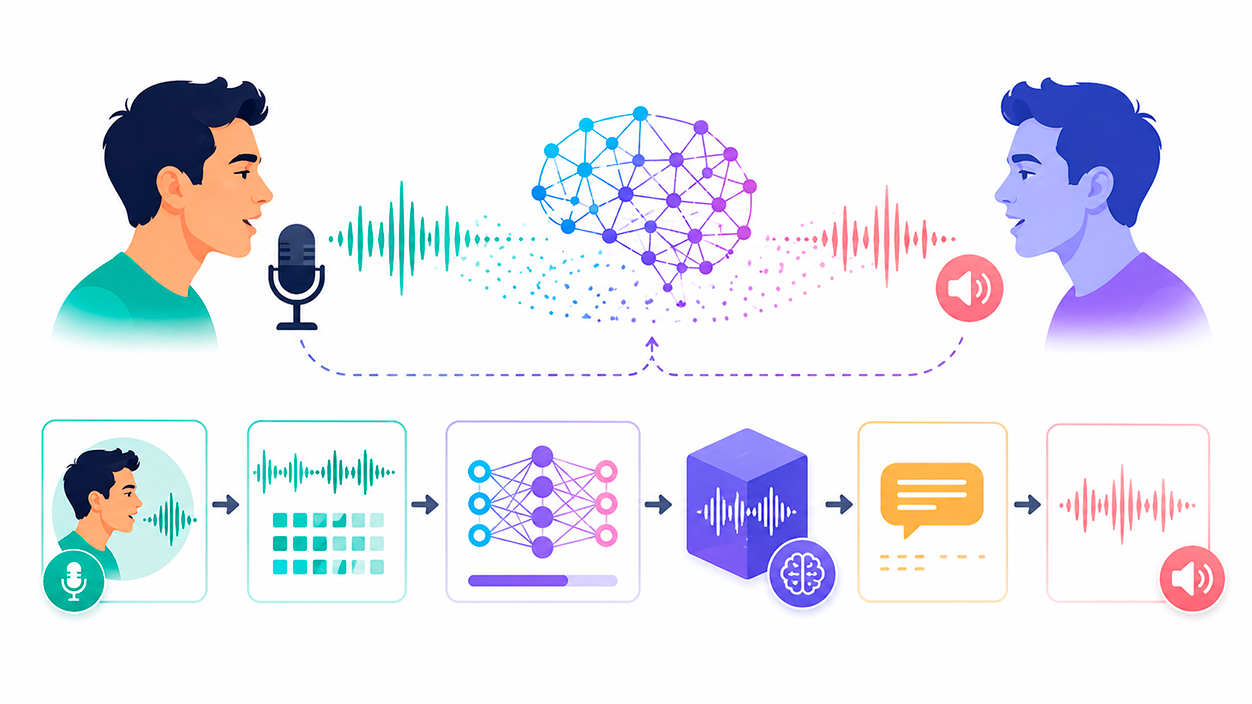
Uma deepfake de voz é, essencialmente, um modelo de IA treinado para imitar a voz de uma pessoa específicaUtilizando gravações reais desse locutor, a máquina aprende seus padrões de tom, timbre, sotaque, velocidade e cadência, e então consegue ler qualquer texto como se fosse a própria pessoa.
Para alcançar esse objetivo, são utilizados sistemas. Texto para fala (TTS) impulsionadas por redes neurais profundasDurante anos, foram utilizadas abordagens concatenativas (junção de trechos de áudio pré-gravados) ou abordagens paramétricas (modelos estatísticos da fala). Hoje, é comum usar arquiteturas baseadas em aprendizado profundo, como WaveNet ou Tacotron, que geram som praticamente do zero.
Na prática, basta que alguns minutos de voz clara e de boa qualidade para treinar um clone bastante convincente. Modelos líderes como o VALLE-E da Microsoft demonstraram imitações razoáveis com apenas três segundos de tempo de amostragem, minimizando a barreira de entrada para atacantes.
O fluxo de trabalho típico para criar um deepfake de voz geralmente segue estes passos: uma gravação real é feita, dividida em fragmentos muito pequenos, uma rede neural é alimentada com essas amostras para aprender as características da voz e, quando o modelo está treinado, ele recebe um novo texto para gerar. Um arquivo de áudio sintético que imita o falante original..
Essas tecnologias não apenas copiam a fala; muitas são capazes de recriá-la. respiração, microssons da boca e nuances expressivas básicasIsso faz com que o resultado soe cada vez menos robótico e mais difícil de detectar apenas pelo ouvido.
Cinco sinais para distinguir uma voz real de uma voz de IA em tempo real
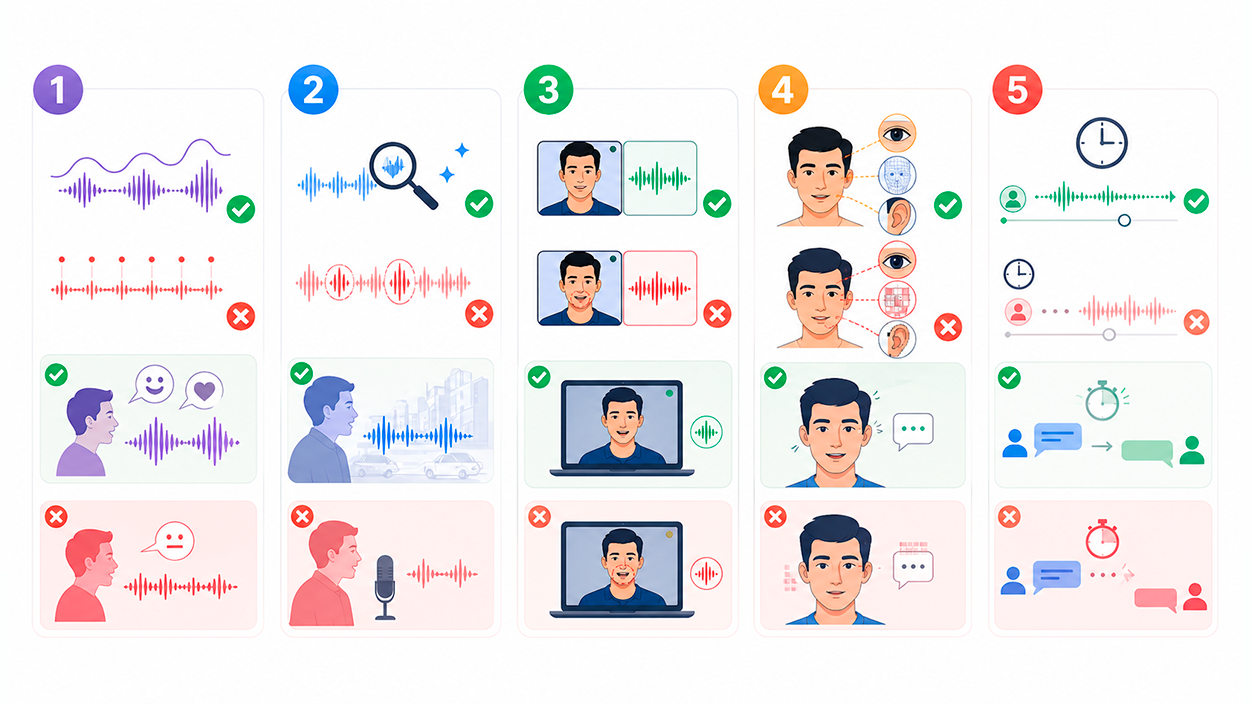
Quando você recebe uma ligação estranha, uma mensagem de voz suspeita ou está em uma videochamada que não parece muito confiável, é uma boa ideia prestar atenção a alguns sinais. Eles não são infalíveis, mas juntos podem ser bastante úteis. para perceber se você está ouvindo uma pessoa real ou um modelo sintético..
Prosódia e entonação que “não combinam”
A voz humana raramente é completamente plana. Alteramos o tom de acordo com a emoção, alongamos algumas sílabas, encurtamos outras e nos interrompemos. Em muitas gravações de áudio geradas por IA, um Melodia vocal excessivamente monótona ou com saltos abruptos. que não se encaixam no contexto. As pausas também são uma pista: se forem muito regulares ou ocorrerem em lugares estranhos na frase, isso indica falta de concisão.
Com uma conexão de rede ruim, você pode notar interrupções ou silêncios, mas assim que o sinal retornar, o A entonação básica soa humana e emotiva.Com a IA, por outro lado, percebe-se uma cadência mais mecânica, como se o discurso estivesse demasiado "bem estruturado".
Artefatos sonoros: brilho metálico e caudas estranhas.
Outro sinal de alerta claro é o artefatos espectraisAlgumas vozes sintetizadas apresentam um timbre ligeiramente metálico em certas palavras, sibilância (aqueles sons de "s" e "sh" excessivamente brilhantes) ou prolongamentos sonoros que desaparecem de forma não natural. Às vezes, o áudio soa "limpo demais" para o ambiente em que supostamente foi gravado.
Em uma gravação real, é normal que... ruído de fundo e qualidade oscilamA distância até o microfone muda, a pessoa se move, o ruído da rua entra. Em muitas gravações de áudio feitas por IA, essas falhas são surpreendentemente consistentes ou inexistentes.
Discrepância entre a voz e os lábios em chamadas de vídeo
Se você também tiver uma imagem além da sua voz, precisa observá-la com muita atenção. sincronização de som labialVídeos deepfake e chamadas de vídeo manipuladas podem apresentar um pequeno atraso constante ou microanomalias, como lábios que estranhamente "flutuam" sobre os dentes ou movimentos da boca que não correspondem ao que é ouvido.
Uma rede ruim também causa perda de sincronização, mas Os movimentos faciais reais permanecem orgânicos.com microgestos convincentes. Em modelos sintéticos, pequenas discrepâncias são sistematicamente repetidas ou possuem uma qualidade plástica que denuncia uma renderização.
Microgestos e detalhes visuais estranhos
Além da boca, existem outros sinais visuais: piscar muito pouco ou em intervalos regulares, olhar fixo, sombras que não se alteram com o ritmo da cabeça, Iluminação excessivamente uniforme e cabelo ou orelhas com pixels estranhos.São típicos de vídeos gerados ou editados por IA.
Em um problema de conexão normal, o que você geralmente vê é um macropixelização grosseira, congelamento completo da imagem ou saltos abruptos.Não se trata daqueles pequenos defeitos de textura ou bordas estranhas em áreas muito específicas do rosto.
Latência que não parece ser da rede.
A pista final é o tempo que a outra parte leva para responder. Muitos sistemas sintéticos funcionam em blocos: recebem sua frase, processam-na e, em seguida, geram uma resposta completa. Isso pode produzir pausas suspeitamente regulares antes de cada resposta, mesmo que a conexão esteja boa.
Em contraste, conexões ruins geram latências altamente irregularesAvisos sobre "conexão instável" e quedas imprevisíveis são preocupações comuns. Se o atraso for consistentemente semelhante ou aumentar repentinamente de quase zero para vários segundos sem nenhuma explicação técnica aparente, vale a pena suspeitar.
Sinais presentes no próprio áudio: pausas, emoção e timbre.
Mesmo sem ver o rosto do orador, uma análise cuidadosa do áudio pode fornecer muitas informações. É aqui que tanto a audição quanto... observação sistemática de padrões de fala.
A voz humana possui um conjunto de características pessoais (tom, timbre, ritmo, sotaque) que Eles variam muito conforme o contexto.Não falamos da mesma forma em uma reunião como falamos em um bar com amigos. As vozes sintéticas, por outro lado, tendem a manter essas características de forma muito consistente, resultando em uma sensação de monotonia ou falta de vida.
Um truque útil é transcrever o áudio, mesmo que apenas de forma aproximada. Vê-lo escrito facilita muito a identificação das diferenças. Frases excessivamente perfeitas, ausência total de palavras de preenchimento, correções ou hesitações.Em uma mensagem de voz informal, é raro alguém falar como se estivesse lendo um texto meticulosamente preparado.
Ferramentas de detecção e marcas d'água: para que servem e para que não servem.
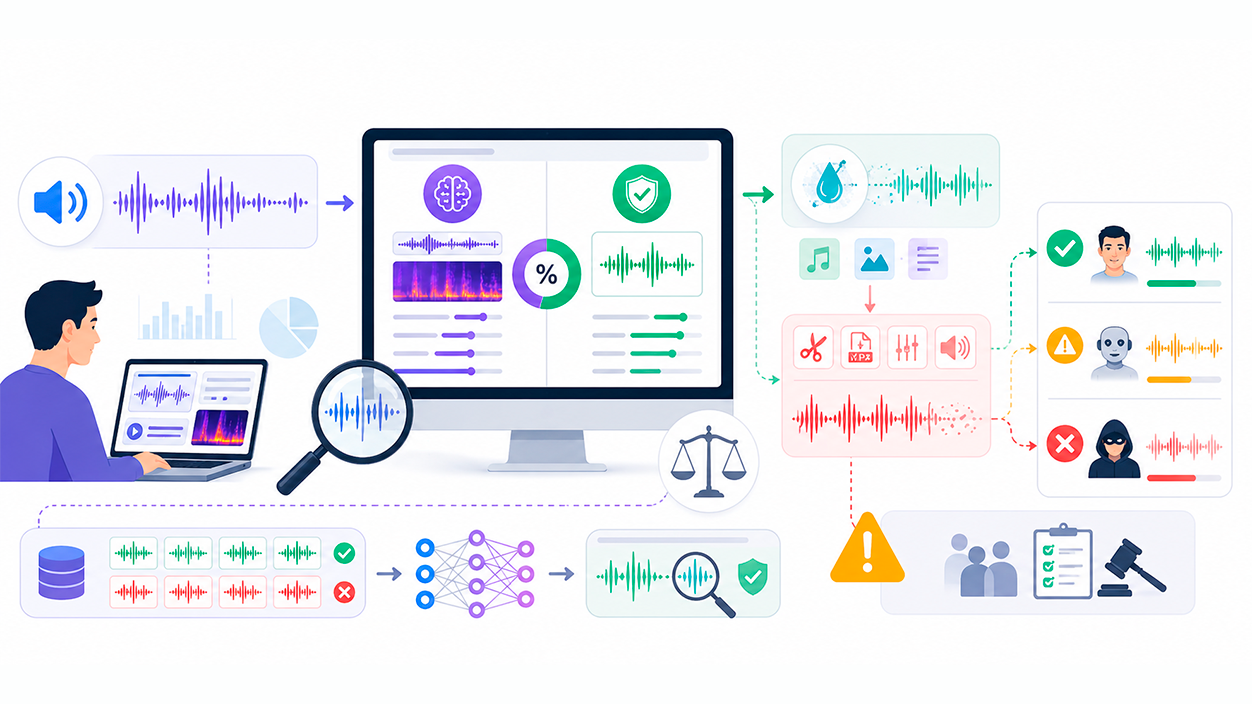
Além da audição e do contexto, eles começam a proliferar. detectores automáticos de voz sintética e sistemas de marcação de fonteSão muito úteis, mas é importante ter clareza sobre suas limitações para não depender delas cegamente.
As abordagens de detecção atuais são amplamente divididas em duas famílias: modelos de classificação forense (que analisam o áudio em busca de padrões de IA) e marcas d'água digitais que são inseridos no conteúdo gerado para permitir sua identificação posterior.
Modelos de detecção forense
Esses sistemas trabalham com grandes conjuntos de dados de vozes reais e sintéticas. Eles analisam características acústicas como artefatos espectrais, prosódia anômala ou padrões de ruído de fundo e aprender a distinguir entre as duas categorias. Iniciativas como os desafios ASVspoof fornecem linhas de base (cenários de acesso lógico, físico e deepfake) para treinar e comparar esses detectores.
Redações e veículos de comunicação já utilizam ferramentas específicas, como as soluções da VerificAudio ou plataformas comerciais de biometria de voz, que combinam uma Camada de análise sintética com verificação contextual (quem está falando, de onde e em que circunstâncias). Sua precisão real geralmente é confidencial e, em áudios altamente comprimidos ou ruidosos, o risco de falsos positivos aumenta.
Muitas plataformas que geram áudio com IA também oferecem suas próprias soluções. classificador internoÉ o caso de serviços que detectam se um vídeo foi criado usando um modelo específico deles. Eles são bastante confiáveis em relação ao próprio conteúdo, mas Elas não se generalizam bem para vozes sintetizadas de outros mecanismos. (por exemplo, se o áudio vier do Google, Meta ou de outra empresa).
Marcas d'água em conteúdo gerado
Outra abordagem importante é adicionar, a partir da fonte, um sinal imperceptível que identifique que o áudio se originou de um modelo de IA. Propostas como Meta AudioSeal Eles inserem um marcador capaz de indicar até mesmo quais fragmentos específicos foram alterados, enquanto Google SynthID Propõe um sistema de rotulagem multimodal que abrange desde imagens até áudio e texto.
O problema é que essas marcas não são indestrutíveis: Compressão agressiva (como em MP3), alterações de tom, eco artificial ou manipulação maliciosa. Elas podem enfraquecer o sinal e gerar falsos negativos. Além disso, só funcionam se o gerador optar por integrá-las; se um atacante usar um modelo sem marca d'água, esse áudio será indetectável por esse método.
Em todo caso, os especialistas concordam: o resultado de um detector — seja uma probabilidade de "x% de IA" ou uma marca d'água encontrada — Nunca deve ser usado como prova definitiva.Trata-se de uma pista inicial que precisa ser complementada por análise humana, contexto e, quando apropriado, perícia forense.
Biometria de voz e desafios como o ASVspoof: a batalha técnica
Em áreas mais especializadas, a comunidade científica e a indústria trabalham com desafios e bases de dados concebidas para testar sistemas de verificação de vozUm exemplo fundamental é o desafio ASVspoof, que se concentra precisamente em ataques de falsificação de voz.
A edição de 2021 apresentou três tarefas: acesso lógico (áudio injetado digitalmente, com efeitos de compressão e transmissão), acesso físico (ataques de reprodução em ambientes do mundo real) e fala deepfake (Detecção de conversões de voz e TTS a partir de áudio comprimido). O objetivo era medir até que ponto as soluções atuais resistem a cenários realistas, envolvendo telefones, codecs e ambientes físicos.
Os resultados mostraram que, ao aplicar técnicas avançadas de aprendizado profundo Após a detecção, a robustez melhora significativamente. Também foi verificado que o intervalos não verbais no áudio (silêncios, respiração, ruídos de fundo) Eles desempenham um papel importante na identificação de vozes falsas, especialmente em cenários de acesso lógico e deepfake.
Empresas especializadas em biometria de voz utilizam esses dados para aprimorar seus modelos. Muitas combinam diversas arquiteturas (redes neurais convolucionais, modelos de aprendizado profundo, classificadores em cascata) para que o A decisão final sobre se uma voz é real ou falsa não deve depender de um único algoritmo.Isso reduz a probabilidade de erro e abrange melhor a diversidade de possíveis ataques.
A biometria de voz, quando usada corretamente, permite não apenas a verificação de identidades, mas também detectar artefatos típicos de deepfakes por meio de análises espectrais detalhadas, algoritmos para detectar padrões impossíveis na voz humana e comparações com modelos gravados anteriormente.
Métodos práticos para usuários: da escuta à análise de contexto.
Além da pesquisa e das grandes plataformas, qualquer pessoa pode aplicar uma série de Hábitos simples para evitar cair em golpes de áudio falso.A chave é combinar três camadas: fonte, conteúdo e forma.
A primeira pergunta a fazer é: De onde veio esse áudio? Se a mensagem estiver circulando apenas em redes sociais, grupos de mensagens ou fóruns sem uma fonte clara, há motivos para suspeitar. É uma boa ideia pesquisar o texto principal da mensagem online e verificar se veículos de mídia confiáveis, organizações oficiais ou a pessoa supostamente envolvida se manifestaram sobre o assunto.
Também é aconselhável verificar se o áudio já foi desmentido por alguém. organizações de verificação de fatos ou por meio de plataformas especializadas em verificação de fatos. Frequentemente, as gravações de áudio fazem parte de uma narrativa de desinformação mais ampla, juntamente com outros conteúdos semelhantes que já foram desmentidos.
Em seguida, você precisa analisar o conteúdo: a mensagem apela para a urgência, o medo ou a pressão para agir rapidamente? Ela pede que você... dados sensíveis, transferências de dinheiro ou ações incomunsEsses tipos de táticas são típicos de golpes, independentemente de envolverem ou não inteligência artificial.
Por fim, é importante observar o formato da voz: monotonia, Falta de emoção, pausas estranhas, pronúncias esquisitas ou um tom excessivamente polido.Se, além disso, o ruído de fundo não corresponder ao que se espera ouvir (um "chamado da rua" em completo silêncio), a suspeita aumenta significativamente.
Como os golpes e a desinformação utilizam essa tecnologia
A clonagem de voz tornou-se uma Uma ferramenta muito tentadora para criminosos e campanhas de desinformação.Você não precisa ser um especialista: com aplicativos online e alguns minutos de áudio gravado ilegalmente, é possível criar ligações ou mensagens extremamente convincentes.
Um dos cenários mais preocupantes é o de fingir ser membro da família ou gerenteSe alguém souber do seu relacionamento com outra pessoa e conseguir gravar a voz dela — por exemplo, através de redes sociais, entrevistas ou simples mensagens de áudio — essa pessoa pode gerar um deepfake que soe suficientemente real para lhe pedir dinheiro, senhas ou decisões urgentes.
Também houve casos de áudios virais de políticos, celebridades ou figuras públicas Esses vídeos supostamente contêm insultos, declarações escandalosas ou anúncios de medidas chocantes. Embora alguns criadores indiquem explicitamente que se tratam de edições geradas por IA (por exemplo, fãs recriando músicas impossíveis de seus artistas favoritos), em outros casos, são distribuídos fora de contexto, com a clara intenção de manipulação.
O aprimoramento contínuo das ferramentas significa que não estamos mais falando apenas de vozes que "soam um pouco parecidas". Hoje é possível gerar Gravações com emoções simuladas, mudanças de ritmo convincentes e qualidade próxima à de estúdio.o que complica ainda mais a detecção apenas pelo ouvido.
É por isso que muitos especialistas enfatizam a importância de treinamento em cibersegurança e pensamento críticoReduzir a quantidade de informações pessoais e profissionais que expomos nas redes sociais, não compartilhar arquivos de áudio longos e claros publicamente, a menos que seja necessário, e, acima de tudo, desenvolver reflexos para evitar agir impulsivamente em resposta a mensagens ou chamadas suspeitas.
Boas práticas para proteger sua voz e evitar cair em golpes.
A melhor defesa combina ceticismo, medidas técnicas básicas e uma gestão sensata da sua presença vocal. Não se trata de viver em paranoia, mas sim de... dificultar a vida de qualquer pessoa que queira se passar por você..
Proteja o consentimento e a privacidade das suas gravações de áudio.
Evite compartilhar gravações de voz longas e de alta qualidade sem um propósito claro. Em ambientes profissionais, isso é razoável. É necessário consentimento explícito para gravar e analisar dados biométricos da voz.especialmente se forem usadas para autenticação.
Se você usa assistentes de voz em casa ou no escritório, é uma boa ideia revisar as configurações e desativá-los o máximo possível. armazenamento contínuo de áudio e a opção de "aprimorar o serviço com minhas gravações".Quanto menos dados forem acumulados, menos material potencial haverá para treinar um clone.
Limite e "sujeite" sua presença vocal pública.
Se você precisa publicar vídeos, podcasts ou entrevistas para o trabalho ou como hobby, pode reduzir o risco técnico diminuindo a a taxa de bits dos arquivos ou adicionando música de fundo.Não se trata de uma barreira absoluta, mas complica o treinamento direto de modelos a partir dessas amostras.
Nas comunicações do dia a dia, reflita se você realmente precisa enviar mensagens de voz longas e claras. Às vezes, uma mensagem de texto ou uma chamada curta são suficientes, reduzindo assim a quantidade de mensagens desnecessárias. Material perfeito para clonar sua voz. Percorrendo aplicativos e servidores.
Use autenticação multifator e “frases anti-deepfake”.
Se instruções sensíveis são frequentemente transmitidas por telefone em sua empresa ou família (transferências, alterações de senha, autorizações), é altamente recomendável implementar um sistema de segurança. código de segurança ou frase dinâmicaNão precisa ser algo super complexo: pode ser uma palavra-chave que muda periodicamente ou perguntas contextuais como "Qual é a palavra de terça-feira?", que só os envolvidos sabem.
O importante é que essa verificação seja revisada por uma pessoa ou por um sistema secundário independente da própria vozAssim, mesmo que alguém conseguisse clonar a entonação, ainda precisaria saber a deixa atual naquele momento para completar o engano.
Tecnologias de cancelamento e ruído branco
Existem dispositivos e programas projetados para interferir com microfones próximos usando ultrassom ou ruído de banda largaPodem ser úteis em contextos muito sensíveis para impedir gravações não autorizadas, mas têm limitações claras: geralmente são caras, têm um alcance limitado e, em alguns lugares, seu uso pode levantar questões legais.
Protocolos recomendados para empresas e administrações
Organizações que lidam com informações críticas ou fluxos de caixa significativos precisam ir além e estabelecer Procedimentos claros para verificação de vozes em chamadas confidenciais.Um script simples pode evitar muitos problemas.
O primeiro passo é certificar-se de quem está falando. Isso significa sempre começar com um verificação contextual e humanaIdealmente, isso deve ser feito usando uma palavra de segurança previamente acordada. Essa resposta deve ser revisada por um supervisor ou, no mínimo, por um sistema secundário que não dependa exclusivamente do áudio da chamada.
Se as dúvidas persistirem, o mais prudente é "quebrar o roteiro": interrompa naturalmente — por exemplo, afirmando problemas de qualidade de chamada— e retorne a chamada de um número oficial que esteja registrado nos sistemas internos (CRM, arquivo pessoal, agenda de contatos verificada). Nunca retorne a chamada para o número que está recebendo ligações.
Esse tipo de verificação fora de banda é muito eficaz porque Isso obriga o golpista a controlar também o outro canal.Se a pessoa real atender o telefonema esperado e o contexto coincidir, a probabilidade de a chamada ser autêntica aumenta drasticamente.
Quando nem isso consegue validar a autenticidade, é hora de deixar um rastro e levar o processo adiante. É útil. Encerre a conversa com uma frase educada.Registre a hora, a origem aparente e quaisquer sinais incomuns detectados ("entonação monótona ao digitar a senha", "latência constante antes de responder") e encaminhe o caso para a equipe de segurança cibernética ou para o departamento jurídico.
Esses protocolos só funcionam se a equipe for treinada: as pessoas precisam ser treinadas para detectar Alterações emocionais estranhas, pressão injustificada e manobras para evitar o retorno.que são táticas comuns em golpes que utilizam vozes reais ou geradas por computador.
Quadro jurídico básico na Europa: o que significa para a sua voz?
No contexto europeu, a voz não é apenas mais um som: o Regulamento Geral sobre a Proteção de Dados (RGPD) considera que A voz são dados pessoaisE se for usado para identificar uma pessoa de forma única, torna-se um dados biométricos especialmente protegidos.
Isso significa que qualquer sistema que armazene ou processe sua voz para fins de identificação precisa de ajuda. uma base legal sólida (geralmente consentimento explícito)O objetivo é muito claro: coletar apenas os dados essenciais e definir períodos de retenção e exclusão. Capturar áudio em massa "por precaução" não é aceitável.
Além disso, a nova Lei de IA da UE (Lei de IA) classifica a Identificação biométrica de voz como área de alto risco Em muitos casos, isso obriga aqueles que desenvolvem e operam esses sistemas a implementar gerenciamento de riscos, avaliações de impacto sobre direitos fundamentais e supervisão humana eficaz de decisões importantes.
A mesma regra proíbe expressamente Usos da IA que manipulam o comportamento, exploram vulnerabilidades ou simulam emergências. para fins de coerção econômica ou extração de dados, mesmo que a mensagem não seja gerada pela clonagem de uma voz específica, mas sim por síntese genérica.
Em paralelo, estão em curso pesquisas para proteger os cidadãos em outro nível: explorando como introduzir distorções imperceptíveis para nós, mas que confundem os algoritmos. Eles estão tentando extrair a impressão digital vocal para treinar modelos de clonagem. A ideia é "envenenar" os conjuntos de dados sem interromper a comunicação humana.
Num cenário em que áudio, vídeo e texto podem ser gerados ou alterados por IA, Aprenda a desconfiar de vozes que parecem perfeitas demais, sempre verifique quando dinheiro ou dados estiverem envolvidos e confie em ferramentas de detecção como pistas, não como oráculos. Isso se tornou mais uma camada de higiene digital. Combinar habilidades de escuta, contexto, tecnologia e protocolos pode fazer toda a diferença entre cair em um deepfake de voz bem feito ou detectá-lo a tempo.


Sou um entusiasta da tecnologia que transformou seus interesses “geek” em profissão. Passei mais de 10 anos da minha vida usando tecnologia de ponta e mexendo em todos os tipos de programas por pura curiosidade. Agora me especializei em informática e videogames. Isto porque há mais de 5 anos escrevo para diversos sites sobre tecnologia e videojogos, criando artigos que procuram dar-lhe a informação que necessita numa linguagem compreensível para todos.
Se você tiver alguma dúvida, meu conhecimento vai desde tudo relacionado ao sistema operacional Windows até Android para celulares. E meu compromisso é com você, estou sempre disposto a dedicar alguns minutos e te ajudar a resolver qualquer dúvida que você possa ter nesse mundo da internet.