- Správa VRAM a použitie vhodnej kvantizácie sú faktory, ktoré najviac ovplyvňujú rýchlosť generovania.
- Konfigurácia premenných prostredia, ako je čas zotrvania modelu a funkcia Flash Attention, eliminuje kritické oneskorenia.
- Používanie špecializovaného hardvéru, ako sú grafické karty NVIDIA alebo Apple Silicon, je nevyhnutné na predchádzanie úzkym miestam CPU.
- Presné nastavenie veľkosti kontextu zabraňuje systému využívať pamäť RAM alebo diskovú pamäť, čím sa predchádza drasticky zvýšeným časom odozvy.

Nastavenie vlastného AI servera doma je vzrušujúci zážitok, ale nič nie je viac odrádzajúce ako inštalácia výkonného modelu a uvedomenie si, že Prvý token trvá večnosť Môže sa to zdať, alebo môže byť rýchlosť zápisu nižšia ako u korytnačky. Ak máte pocit, že váš hardvér dokáže viac, ale Ollama sa stále nespúšťa, nezúfajte; s najväčšou pravdepodobnosťou je vo vašej konfigurácii úzke hrdlo, ktoré nevidíte.
Výkon lokálnych LLM závisí kriticky od toho, ako sú dáta spravované medzi diskom, RAM a VRAM grafickej karty. Keď sa v tomto toku niečo pokazí, umelá inteligencia začne... prepínanie do systémovej pamäteA práve tu rýchlosť prudko klesá. V tomto článku si rozoberieme všetky techniky, od rýchlych päťminútových úprav až po pokročilé optimalizácie, vďaka ktorým bude váš lokálny model lietať.

Diagnóza: Kde je problém?
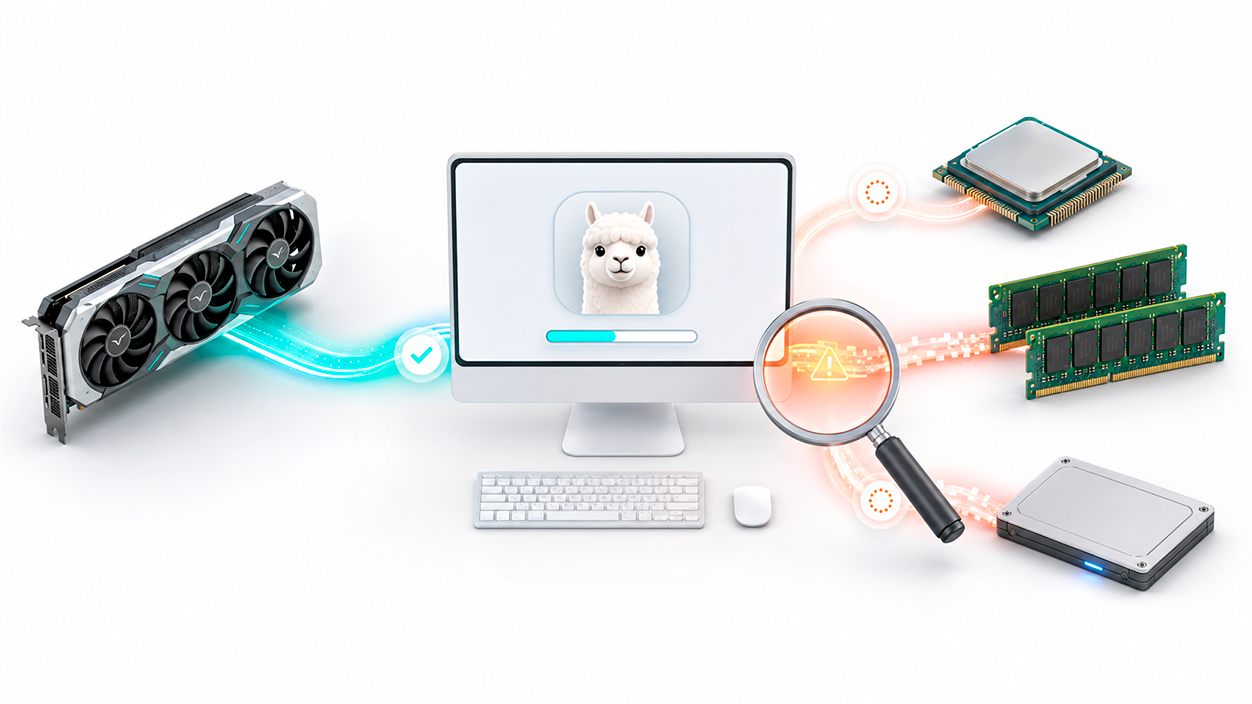
Predtým, ako sa čohokoľvek dotknete, je dôležité presne vedieť, čo sa deje. Ak si všimnete, že prvá reakcia trvá 20 sekúnd, ale potom prebieha hladko, problém je v načítať model z diskuAk je naopak generovanie slov konštantné a veľmi pomalé (1 – 3 tokeny za sekundu), je veľmi pravdepodobné, že Ollama nedetekuje vašu grafickú kartu (GPU) a všetku inferenciu vykonáva pomocou CPU.
Ďalším typickým príznakom je, že menšie modely fungujú perfektne, ale keď vyskúšate väčší, systém sa stane nepoužiteľným. To naznačuje, že VRAM vašej karty je nedostatočná a model pretekol do bežnej RAM. Ak to chcete skontrolovať v reálnom čase, môžete použiť príkaz watch -n 0.5 nvidia-smi v Linuxe alebo nástroje ako GPU-Z vo Windowse, čím sa zabezpečí, že využitie GPU je počas generovania takmer 100 %.

Rýchle triky na odstránenie počiatočného oneskorenia
Jedným z najčastejších problémov je, že Ollama po niekoľkých minútach nečinnosti uvoľní model z pamäte. Na vyriešenie tohto problému môžeme použiť premennú prostredia. OLLAMA_KEEP_ALIVE=-1čo núti program udržiavať model načítaný na neurčitoVďaka tomu sa úplne eliminuje čakacia doba na prvú konzultáciu, vďaka čomu je zážitok oveľa plynulejší a prirodzenejší.
Ak máte grafickú kartu NVIDIA radu 30xx alebo 40xx, je nevyhnutné ju aktivovať Blesková pozornosť 2 pomocou premennej OLLAMA_FLASH_ATTENTION=1Táto technológia optimalizuje matematické výpočty mechanizmu pozornosti, čo môže viesť k zlepšeniu celkovej rýchlosti až o 40 % a je obzvlášť účinná pri práci s... veľmi rozsiahle textové kontexty.
Umenie výberu správnej kvantizácie
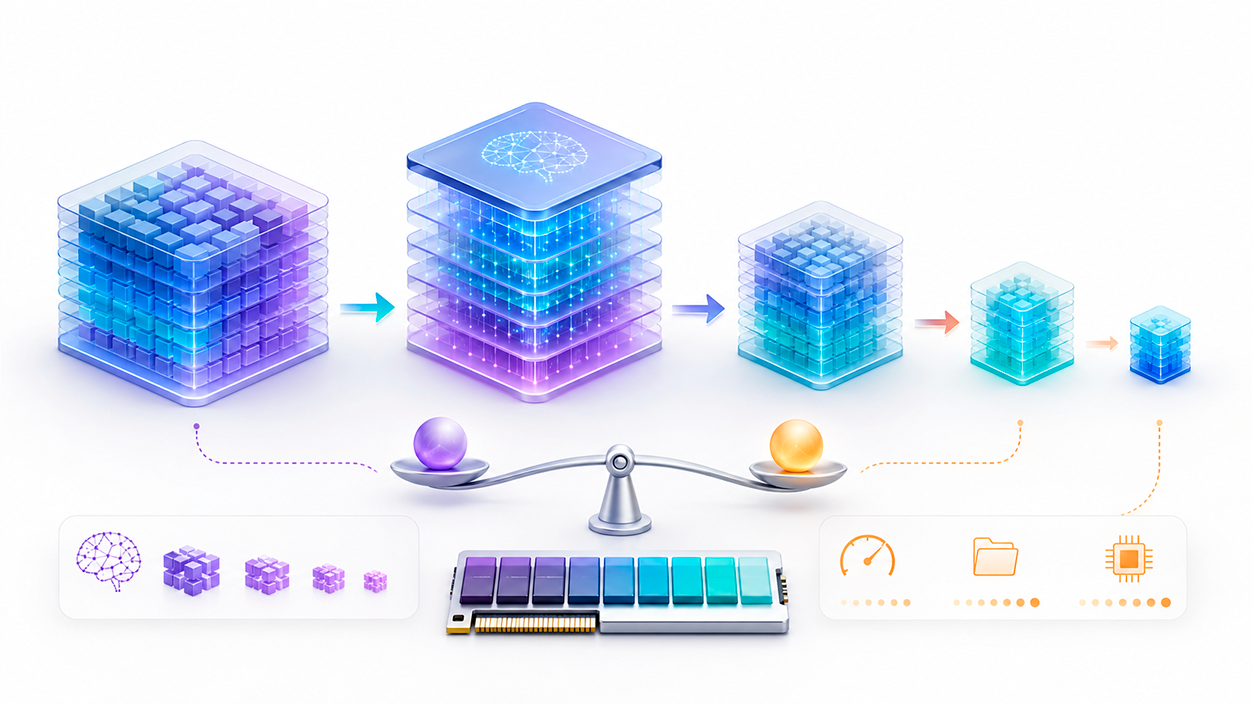
Nie všetky modely sú si rovné. Kvantizácia je proces znižovania presnosti váh modelov, aby zaberali menej miesta. Používanie modelu FP16 (plná presnosť) je luxus, ktorý vyžaduje obrovské množstvo VRAM, a ak nie je dostatok miesta, systém sa uchýli k RAM, ktorá je... extrémne pomalšíV ideálnom prípade by sa mala rovnováha hľadať kvantizáciou Q4_K_M alebo Q6_K.
Zlaté pravidlo znie: použite najvyššiu kvantizáciu, ktorá sa pohodlne zmestí do vašej VRAM bez nutnosti výmeny. Pre karty s kapacitou 8 – 12 GB je potrebný model s kapacitou 8 MB. kvantizácia Q6 alebo Q8 Toto je zvyčajne ideálna zóna. Ak klesneme na Q4, strata kvality je minimálna, ale výrazne získame rýchlosť. Vyhnite sa poklesu na Q2 alebo Q3, pokiaľ to nie je jediný spôsob, ako model spustiť, pretože konzistencia reakcií prudko klesá.

Rozšírené nastavenia pamäte a kontextu
Niekedy problém nie je v modeli, ale v tom, koľko informácií sa snažíme spracovať naraz. Parameter num_ctx Definujte kontextové okno. Častou chybou je ponechať astronomické hodnoty (ako 128k alebo 256k tokenov), keď potrebujeme len niekoľko tisíc. Zvyšovanie kontextu spotrebúva VRAM lineárne.A ak zájdete priďaleko, model pretečie do systémovej pamäte RAM, čím sa celý proces spomalí.
Pre optimalizáciu upravte kontext v Modelfile na hodnoty ako 4096 alebo 8192 tokenov, ktoré sú zvyčajne optimálny rovnovážny bod pre väčšinu chatovacích aplikácií. Ak máte model na mechanickom pevnom disku (HDD), okamžite ho presuňte na NVMe SSD. Rozdiel v rýchlosti načítavania je obrovský, čo môže vďaka použitiu skrátiť počiatočné čakacie doby o 50 % až 70 %. súbory mapované do pamäte (mmap).
Optimalizácia hardvéru a systému
Ak výkon zostáva aj po úprave všetkých premenných nízky, možno ste dosiahli fyzické limity počítača. V systéme Windows sa uistite, že máte aktuálne ovládače CUDA a že Ollama nekonkuruje procesom na pozadí, ako je antivírusový softvér alebo rozsiahle aktualizácie. V systéme Mac... zjednotená pamäť čipov M2 alebo M3 To je obrovská výhoda, pretože umožňuje GPU prístup k veľkej časti pamäte RAM systému.
Jeden faktor, na ktorý často zabúdame, je teplota. Keď grafická karta dosiahne 85 – 90 °C, tepelné škrtenieTým sa znižuje frekvencia hodín, aby sa zabránilo prehriatiu, čo spôsobuje, že AI sa síce rýchlo spustí, ale po niekoľkých minútach sa spomalí. Vyčistenie prachu z ventilátorov alebo úprava krivky rýchlosti ventilátorov môže obnoviť 20 – 50 % výkonu strateného v dôsledku tepla.
Ak hľadáte radikálny upgrade, najlepšou investíciou je zvýšenie kapacity VRAM. Upgrade z RTX 3060 na 24GB RTX 4090 vám umožňuje používať grafické karty s až 34 GB VRAM. úplne na GPUTým sa zabráni akémukoľvek poklesu výkonu. Pre tých, ktorí si nemôžu upgradovať hardvér, existujú alternatívy, ako napríklad prenájom grafických kariet na hodinu od špecializovaných cloudových služieb, ktoré ponúkajú surový výkon, aký je vo väčšine domácich notebookov nedosiahnuteľný.
Pre bezproblémový chod lokálnej umelej inteligencie je potrebné doladiť veľkosť modelu, zvolenú kvantizáciu a správu VRAM. Uprednostnením využitia GPU, obmedzením kontextu na to, čo je nevyhnutne potrebné, a udržiavaním modelu načítaného v pamäti je možné premeniť frustrujúco pomalý zážitok na mimoriadne agilný a súkromný nástroj na zvýšenie produktivity.


Som technologický nadšenec, ktorý zo svojich „geekovských“ záujmov urobil povolanie. Strávil som viac ako 10 rokov svojho života používaním špičkových technológií a hraním so všetkými druhmi programov z čistej zvedavosti. Teraz som sa špecializoval na počítačovú techniku a videohry. Je to preto, že už viac ako 5 rokov píšem pre rôzne webové stránky o technológiách a videohrách a vytváram články, ktoré sa snažia poskytnúť vám potrebné informácie v jazyku, ktorý je zrozumiteľný pre každého.
Ak máte nejaké otázky, moje znalosti siahajú od všetkého, čo súvisí s operačným systémom Windows, ako aj Androidom pre mobilné telefóny. A môj záväzok je voči vám, vždy som ochotný venovať pár minút a pomôcť vám vyriešiť akékoľvek otázky, ktoré môžete mať v tomto internetovom svete.