- gpt-oss-20b je na voljo kot model odprte teže z lokalnim izvajanjem in dolgim kontekstom (do 131.072 žetonov).
- Optimizirano za NVIDIA RTX: Poročane hitrosti do 256 t/s; VRAM prevzame nadzor nad vzdrževanjem zmogljivosti.
- Enostavna uporaba z Ollamo in alternativami, kot so llama.cpp, GGML in Microsoft AI Foundry Local.
- Na voljo tudi v Intel AI Playground 2.6.0, s posodobljenimi ogrodji in izboljšanim upravljanjem okolja.

Prihod gpt-oss-20b za lokalna uporaba prinaša zmogljiv model sklepanja, ki deluje neposredno na osebnem računalniku, več uporabnikom. Ta spodbuda, usklajena z Optimizacija za grafične procesorje NVIDIA RTX, odpira vrata zahtevnim delovnim procesom brez zanašanja na oblak.
Poudarek je jasen: ponuditi odprta teža z zelo dolgim kontekstom za kompleksne naloge, kot so napredno iskanje, raziskovanje, pomoč pri kodiranju ali dolgi klepeti, pri čemer se daje prednost zasebnost in nadzor stroškov pri delu lokalno.
Kaj omogoča gpt-oss-20b pri lokalnem zagonu?
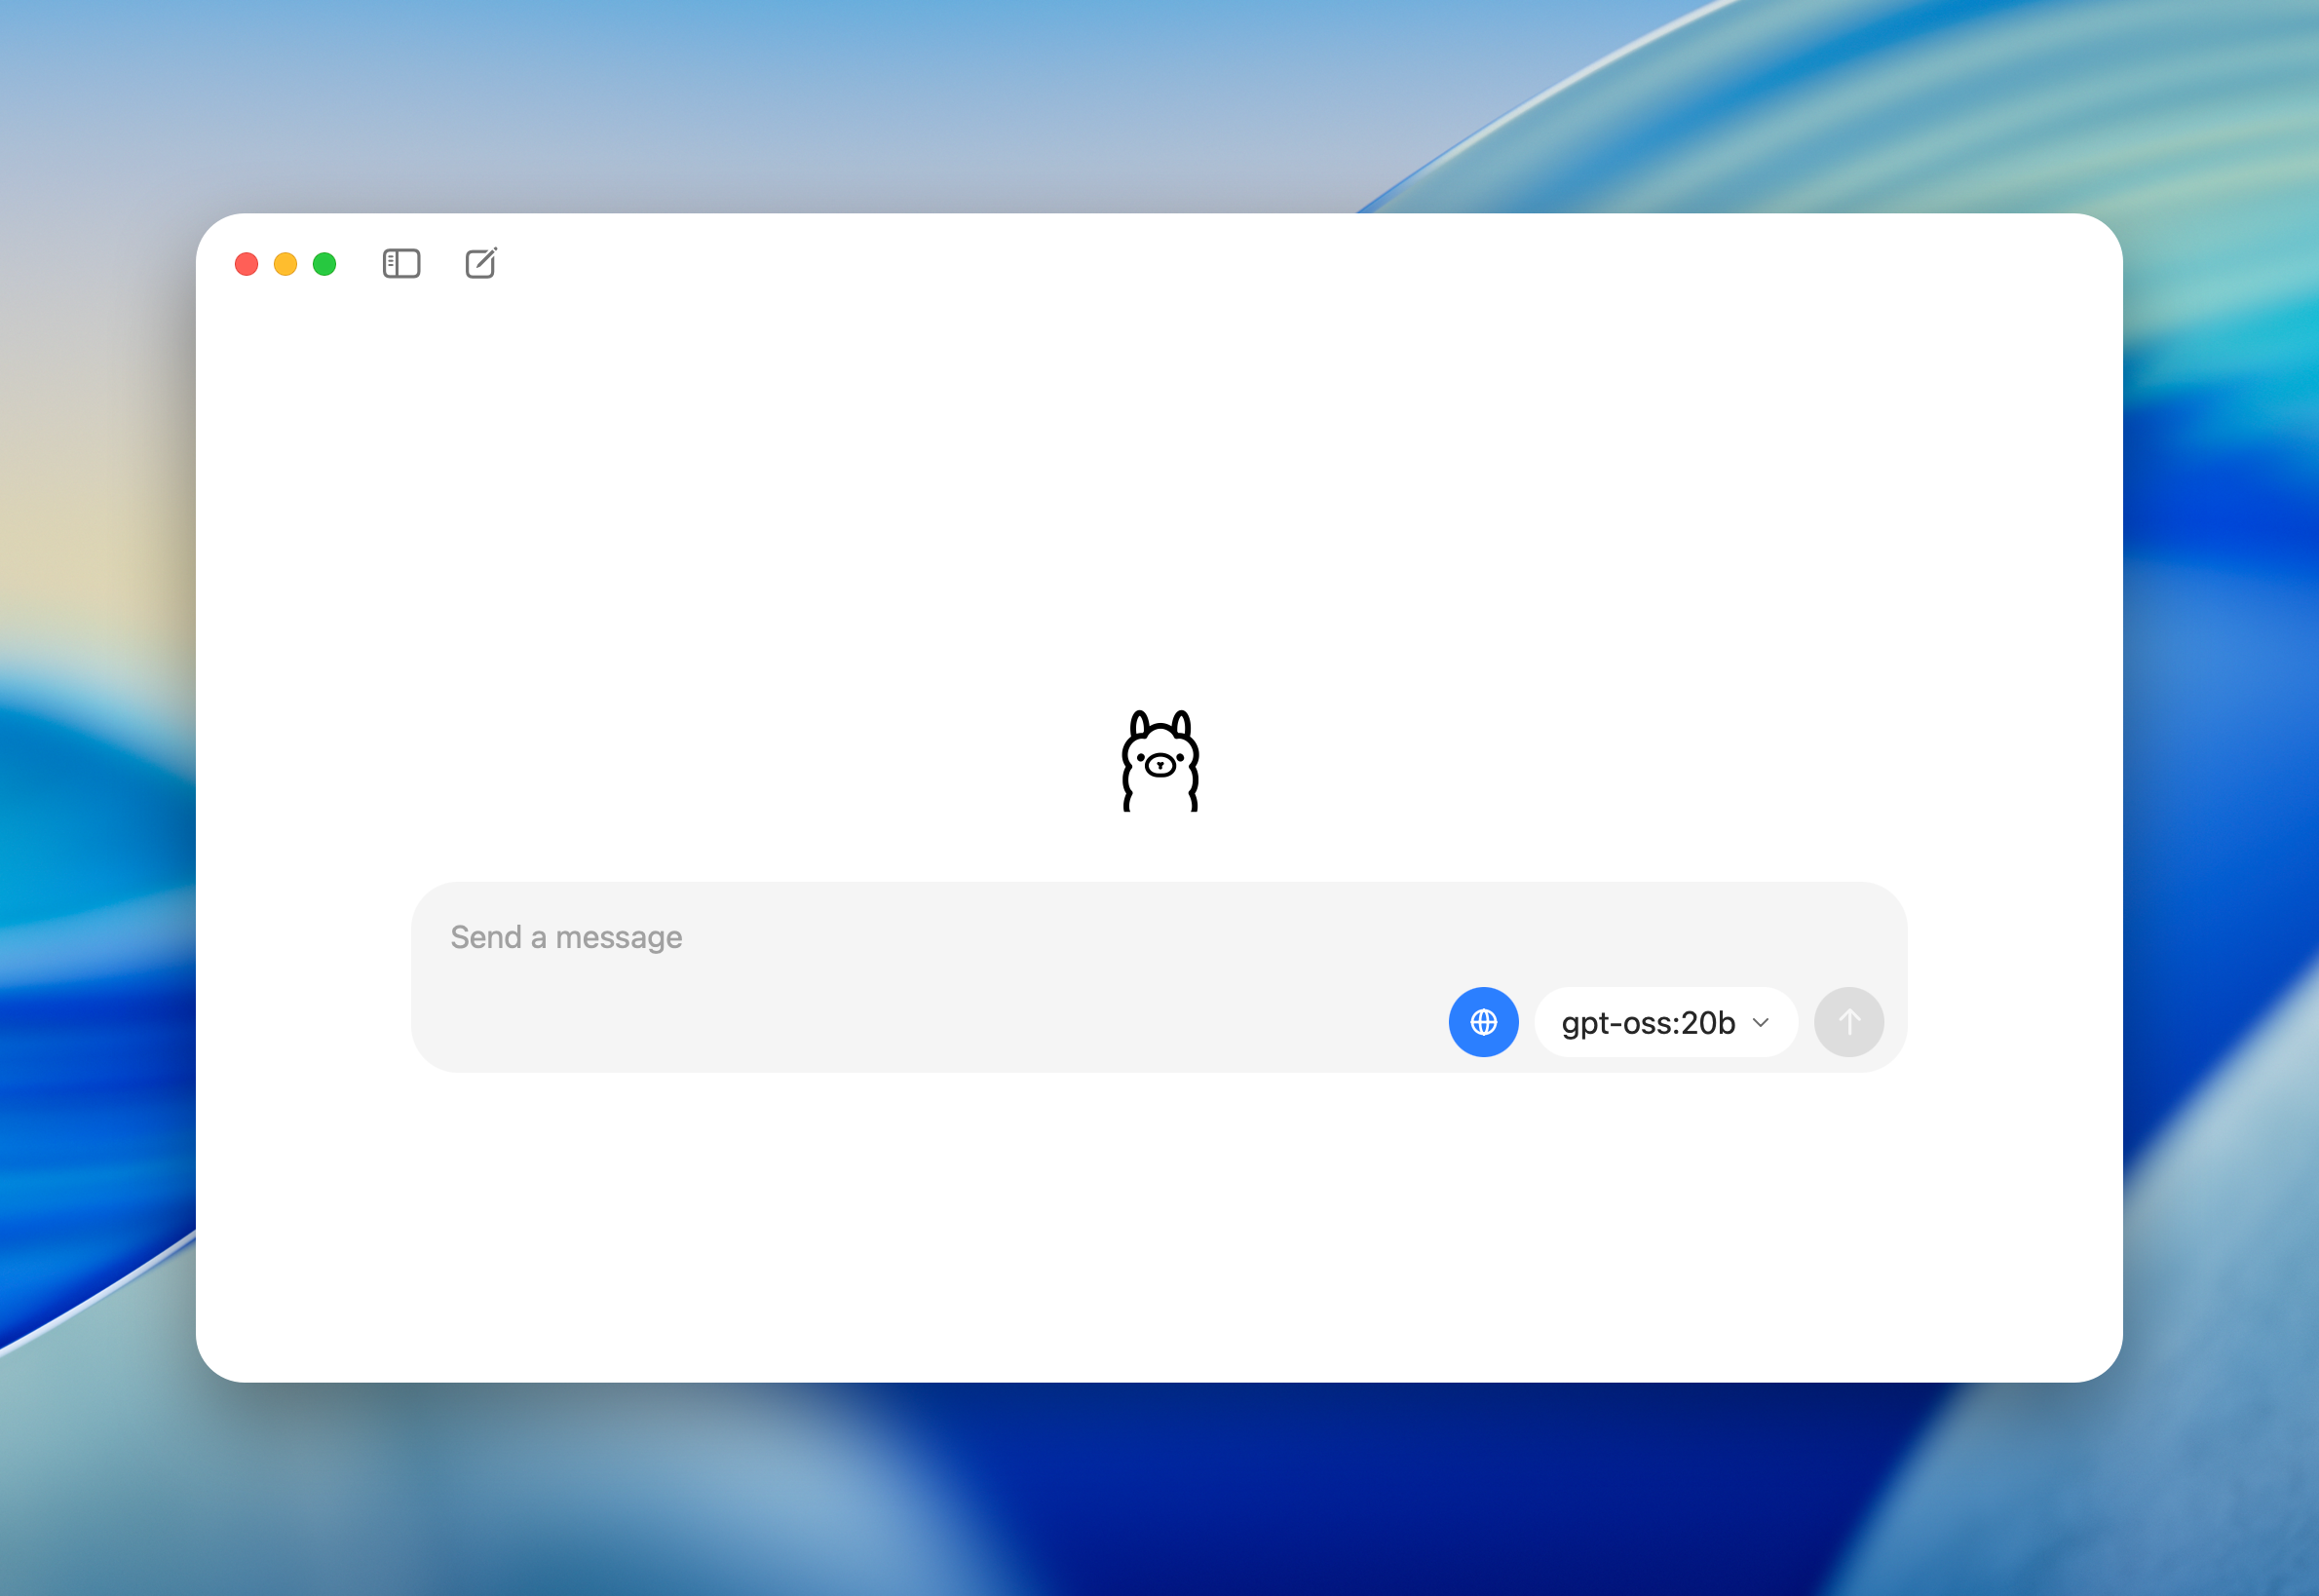
Družina gpt-oss se prvič predstavi z modeli odprte uteži zasnovano za enostavno integracijo v vaše lastne rešitve. Natančneje, gpt-oss-20b Izstopa po uravnoteženju zmogljivosti sklepanja in razumnih zahtev strojne opreme za namizni računalnik.
Razlikovalna značilnost je razširjeno kontekstno okno, s podporo za do 131.072 žetonov v območju gpt-oss. Ta dolžina olajša dolgi pogovori, analiza obsežnih dokumentov ali globljih miselnih tokov brez rezov ali fragmentacije.
V primerjavi z zaprtimi modeli daje predlog z odprto težo prednost fleksibilnost integracije v aplikacijah: od pomočniki z orodjem (agenti) celo vtičniki za raziskave, spletno iskanje in programiranje, pri čemer vsi izkoriščajo lokalno sklepanje.
V praksi paket gpt-oss:20b je približno 13 GB nameščen v priljubljenih izvajalnih okoljih. To določa ton za potrebne vire in pomaga pri skaliranju VRAM za ohranjanje delovanja brez ozkih grl.
Obstaja tudi večja različica (gpt-oss-120b), zasnovana za scenarije z več obsežnih grafičnih virovZa večino osebnih računalnikov pa 20B Zaradi razmerja med hitrostjo, pomnilnikom in kakovostjo je to najbolj realistično izhodišče.
Optimizacija za RTX: hitrost, kontekst in VRAM

Prilagajanje modelov GPT-OSS ekosistemu NVIDIA RTX omogoča visoke stopnje proizvodnje. Pri vrhunski opremi, vrhovi do 256 žetonov/sekundo z ustreznimi prilagoditvami, pri čemer se izkoristijo specifične optimizacije in natančnosti, kot so MXFP4.
Rezultati so odvisni od kartice, konteksta in konfiguracije. V testih z RTX 5080, gpt-oss 20b je dosegel približno 128 t/s z omejenimi konteksti (≈8k). Z zvišanjem 16k okno in s prisilnim prenosom dela obremenitve v sistemski RAM se je hitrost znižala na ~50,5 t/s, pri čemer večino dela opravi grafični procesor.
Lekcija je jasna: Pravila VRAM-aV lokalni umetni inteligenci, a RTX 3090 z več pomnilnika Lahko deluje bolje kot novejši grafični procesor, vendar z manj VRAM-a, ker preprečuje preobremenitev sistemski pomnilnik in dodatno posredovanje CPU-ja.
Za gpt-oss-20b je priročno vzeti velikost modela kot referenco: približno 13 GB več prostora za Predpomnilnik KV in intenzivne naloge. Kot hiter vodnik je priporočljivo imeti 16 GB video pomnilnika vsaj in si prizadevati za 24 GB če se pričakujejo dolgotrajni konteksti ali trajne obremenitve.
Tisti, ki želijo izkoristiti strojno opremo, lahko raziščejo učinkovite natančnosti (kot je MXFP4), prilagodite dolžino konteksta ali se po možnosti zatecite k konfiguracijam z več grafičnimi procesorji, pri čemer vedno ohranite cilj izogibajte se zamenjavam proti RAM-u.
Namestitev in uporaba: Ollama in druge poti

Za preprosto testiranje modela, Ollama ponuja neposredno izkušnjo na računalnikih z grafično kartico RTX: Omogoča vam prenos, zagon in klepet z GPT-OSS-20B brez zapletenih konfiguracij., poleg tega pa podpira PDF-je, besedilne datoteke, slikovne pozive in prilagajanje konteksta.
Obstajajo tudi alternativne poti za napredne uporabnike, na primer Namestitev LLM v sistem Windows 11Okviri, kot so lama.cpp in knjižnice tipov GGML so optimizirani za RTX, z nedavnimi prizadevanji v zmanjšajte obremenitev procesorja in izkoristite CUDA grafiVzporedno, Lokalno livarno za umetno inteligenco Microsofta (v predogledu) Integrirajte modele prek CLI, SDK ali API-jev s pospeševanjem CUDA in TensorRT.
V ekosistemu orodij, Intel AI Playground 2.6.0 je med svoje možnosti vključil gpt-oss-20bPosodobitev dodaja natančen nadzor različic za zaledne sisteme in revizije ogrodji, kot je OpenVINO, udoben uporabniški vmesnik y lama.cpp (s podporo Vulkan in prilagajanje kontekstu), olajšanje stabilna lokalna okolja.
Kot vodilo za začetek preverite Razpoložljivi VRAM, prenesite različico modela, ki ustreza vašemu grafičnemu procesorju, in preverite hitrost žetona z reprezentativnimi pozivi in prilagaja kontekstno okno da vsa obremenitev ostane na grafični kartici.
S temi kosi je mogoče sestaviti pomočnike za iskanje in analiza, orodja preiskava ali podpor programiranje ki se v celoti izvajajo na računalniku in ohranjajo suverenost podatkov.
Kombinacija gpt-oss-20b s pospeševanjem RTX, skrbnim upravljanjem VRAM-a in orodji, kot so Ollama, llama.cpp ali AI Playground, utrjuje zrelo možnost za lokalno izvajanje umetne inteligence z razmišljanjem; pot, ki uravnoteži zmogljivost, stroške in zasebnost brez zanašanja na zunanje storitve.


Sem tehnološki navdušenec, ki je svoja "geek" zanimanja spremenil v poklic. Več kot 10 let svojega življenja sem porabil za uporabo vrhunske tehnologije in premleval najrazličnejše programe iz čiste radovednosti. Zdaj sem se specializiral za računalniško tehnologijo in video igre. To je zato, ker že več kot 5 let pišem za različna spletna mesta o tehnologiji in video igrah ter ustvarjam članke, ki vam želijo dati informacije, ki jih potrebujete, v jeziku, ki je razumljiv vsem.
Če imate kakršna koli vprašanja, moje znanje sega od vsega v zvezi z operacijskim sistemom Windows kot tudi Androidom za mobilne telefone. In moja zaveza je vam, vedno sem pripravljen porabiti nekaj minut in vam pomagati razrešiti kakršna koli vprašanja, ki jih morda imate v tem internetnem svetu.