- llama.cpp deluje kot osnovni mehanizem za sklepanje, ki ponuja maksimalno optimizacijo strojne opreme in natančen nadzor nad modelom.
- Ollama je abstrakcijska plast, ki poenostavlja upravljanje modelov in implementacijo strežnika API z uporabo sistema, podobnega Dockerju.
- Izbira je odvisna od tega, ali dajete prednost hitrosti uvajanja in preprostosti (Ollama) ali surovi zmogljivosti in tehnični prilagoditvi (llama.cpp).

Če ste se kdaj spraševali, kako bi bilo imeti zmogljivo umetno inteligenco, ki deluje na vašem računalniku, ne da bi se nenehno zanašali na naročnine ali pošiljali pogovore na zunanje strežnike, ste verjetno že naleteli na dve imeni: Ollama in llama.cpp.
Čeprav obe orodji omogočata zagon jezikovnih modelov na domači strojni opremiNe ponujata popolnoma enake izkušnje. llama.cpp je izjemno prilagodljiv mehanizem za sklepanje, medtem ko Ollama dodaja upravljalno plast, ki poenostavlja prenos, konfiguriranje in zagon modelov.
Izbira je odvisna od tega, kaj iščete. Uporabnik, ki želi le hitro zagnati lokalnega pomočnika, nima enakih potreb kot razvijalec, ki je odločen stisnite vsak žeton na sekundo vaše grafične kartice. Razumevanje njihovih razlik pomaga preprečiti nepotrebno zapletene namestitve, modele, ki se ne prilegajo pomnilniku, in konfiguracije, ki premalo izkoriščajo strojno opremo.
Kaj je llama.cpp in za kaj se uporablja?
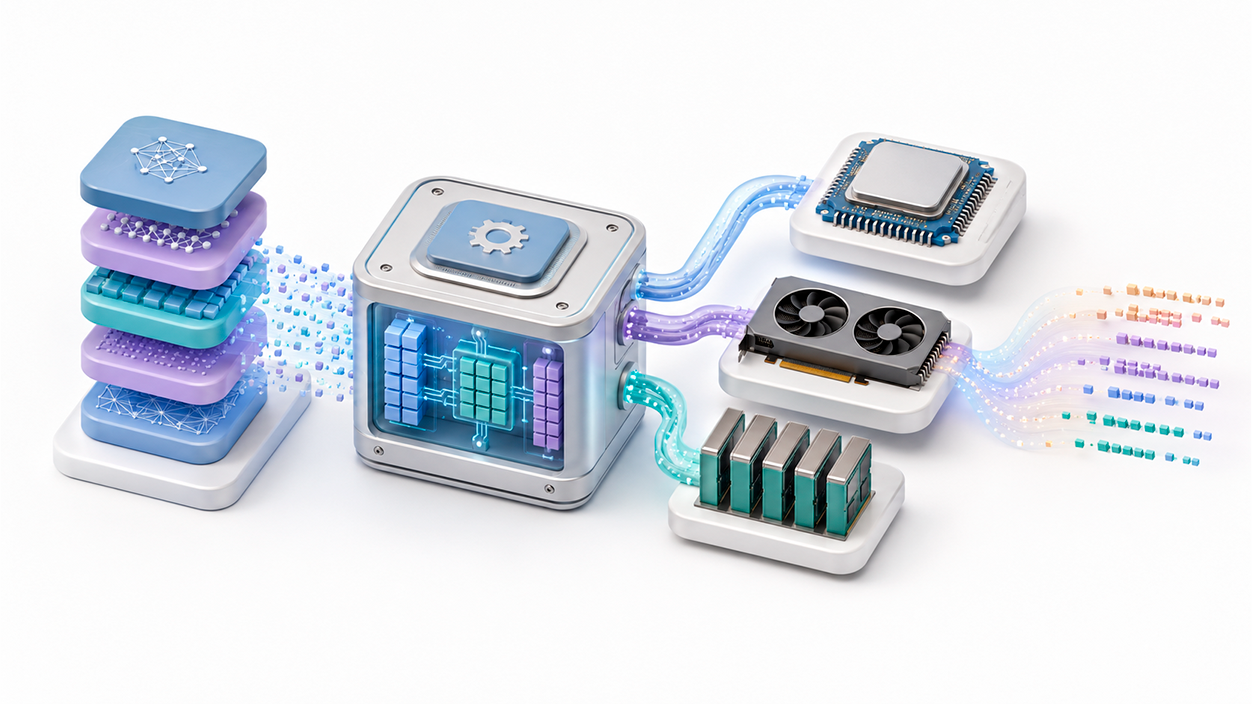
llama.cpp je odprtokodni projekt, napisan predvsem v programskih jezikih C in C++, za izvajanje jezikovnih in vizualnih modelov z zmanjšana poraba virov in visoka stopnja nadzoraČeprav izvira iz družine Llama, trenutno podpira številne druge združljive arhitekture.
Njegov cilj je olajšati sklepanje v najrazličnejših napravah. Izkorišča lahko ukaze AVX, AVX2 in AVX-512 procesorjev x86, razširitve NEON strojne opreme ARM in različne sisteme za pospeševanje grafičnih procesorjev.
Je tudi ena glavnih komponent ekosistema GGUF. Ta format združuje kvantizirane uteži in različne metapodatke, potrebne za nalaganje modela v eno samo datoteko. Če želite bolje razumeti, kako deluje, si lahko ogledate naš Vodnik po formatu GGUF in njegovih kvantizacijah.
Ena od velikih prednosti datoteke llama.cpp je njena prilagodljivost. Med drugimi parametri omogoča prilagajanje:
- Število plasti, ki so naložene na grafični procesor.
- Število niti, ki jih uporablja procesor.
- Velikost serije in mikroserije.
- Največja dolžina konteksta.
- Vrsta in velikost predpomnilnika KV.
- Naprave, ki se uporabljajo, ko je več grafičnih procesorjev.
- Paralelizacija in število sočasnih zaporedij.
Zahvaljujoč tem kontrolam vam llama.cpp omogoča ustvarjanje hibridne konfiguracije CPU in GPU in se prilagoditi sistemom, kjer se model ne prilega popolnoma v VRAM.
Ali je treba datoteko llama.cpp prevesti ročno?
Krivulja učenja za llama.cpp je strmejša kot za Ollamo, vendar ni več natančno reči, da morate vedno klonirati repozitorij in prevesti kodo. Projekt ponuja vnaprej prevedene binarne datoteke, slike Dockerja in različne metode namestitve, poleg tega pa obstaja možnost prevajanja za aktiviranje določenih optimizacij.
Prevajanje je še vedno uporabno, ko morate izbrati določeno ozadje, uporabiti napredne možnosti ali izkoristiti najnovejše funkcije. Vendar pa ga lahko za preprost preizkus namestite in zaženete datoteko GGUF neposredno z orodji, kot je llama-cli.
Datoteka llama.cpp lahko s svojim identifikatorjem prenese in zažene tudi modele, ki gostujejo na Hugging Face. Zato Upravljanje ni nujno popolnoma ročno, čeprav je še vedno manj vodena kot Ollamina integrirana knjižnica.
Poleg terminalskega orodja projekt vključuje tudi llama-serverllama.cpp je strežnik HTTP z osnovnim spletnim vmesnikom in končnimi točkami, združljivimi z OpenAI API. To omogoča uporabo llama.cpp kot zalednega sistema za druge aplikacije, ne da bi bilo treba programirati neposredno z uporabo njegovih knjižnic.

Kaj je Ollama in kako poenostavlja lokalno umetno inteligenco?
Če llama.cpp predstavlja motor, je Ollama bolj podobna dokončanemu vozilu. Ponuja aplikacijo, terminalsko orodje, knjižnico modelov in storitev v ozadju, ki avtomatizira velik del konfiguracije.
Na primer, če želite prenesti in zagnati model, ki je na voljo v vaši knjižnici, lahko običajno preprosto vnesete ukaz, kot je ta:
ollama run nombre-del-modeloOllama poskrbi za iskanje ustrezne različice, prenos njenih komponent in nalaganje prek združljivega zalednega sistema. Zato je običajno najbolj dostopna alternativa za tiste, ki želijo Namestite Ollamo v sistem Windows in začnite uporabljati lokalne modele brez predhodnega učenja vseh parametrov llama.cpp.
Njegovo delovanje je odvisno od tako imenovanih ModelfilesTe datoteke vam omogočajo, da definirate osnovni model, predlogo pogovora, sistemsko sporočilo in parametre, kot sta temperatura ali dolžina konteksta. Ideja nekoliko spominja na Dockerfiles, čeprav Ollama ne potrebuje zagona vsakega modela znotraj Dockerjevega vsebnika.
Ollama uporablja llama.cpp kot enega od svojih mehanizmov za sklepanje in dodaja lastne komponente za upravljanje modelov, pomnilnika, zahtev in združljivosti strojne opreme. Zato, To ni zgolj grafični vmesnik za llama.cppampak storitvena plast, zgrajena okoli različnih komponent.
Ollama API proti strežniku llama.cpp
Ena največjih prednosti Ollame je, da zažene lokalno storitev, ki je privzeto na voljo v http://localhost:11434Njegov API vam omogoča ustvarjanje besedila, pogovore, ustvarjanje vdelanih elementov, uporabo orodij in upravljanje nameščenih modelov.
Ollama vključuje tudi končne točke, ki so združljive z delom OpenAI API-ja. To olajša povezovanje aplikacij, ki že pričakujejo naslov v tej obliki. /v1Vendar, Ollamin izvorni API in OpenAI-jev API nista identična.Zato je priporočljivo pregledati, katere funkcije podpira posamezna integracija.
llama.cpp ponuja podobno rešitev prek llama-serverRazlika je v tem, da uporabnika sili, da bolj eksplicitno izbere in konfigurira model, naprave, kontekst, paralelizacijo in druge parametre strežnika.
V praksi je Ollama bolj priročna za hitro povezavo klepetalnega robota ali vizualne aplikacije. Uporabite jo lahko na primer kot zaledno okolje po ... Namestitev Open WebUI v sistem Windows in imajo vmesnik, podoben vmesniku prodajnih asistentov.

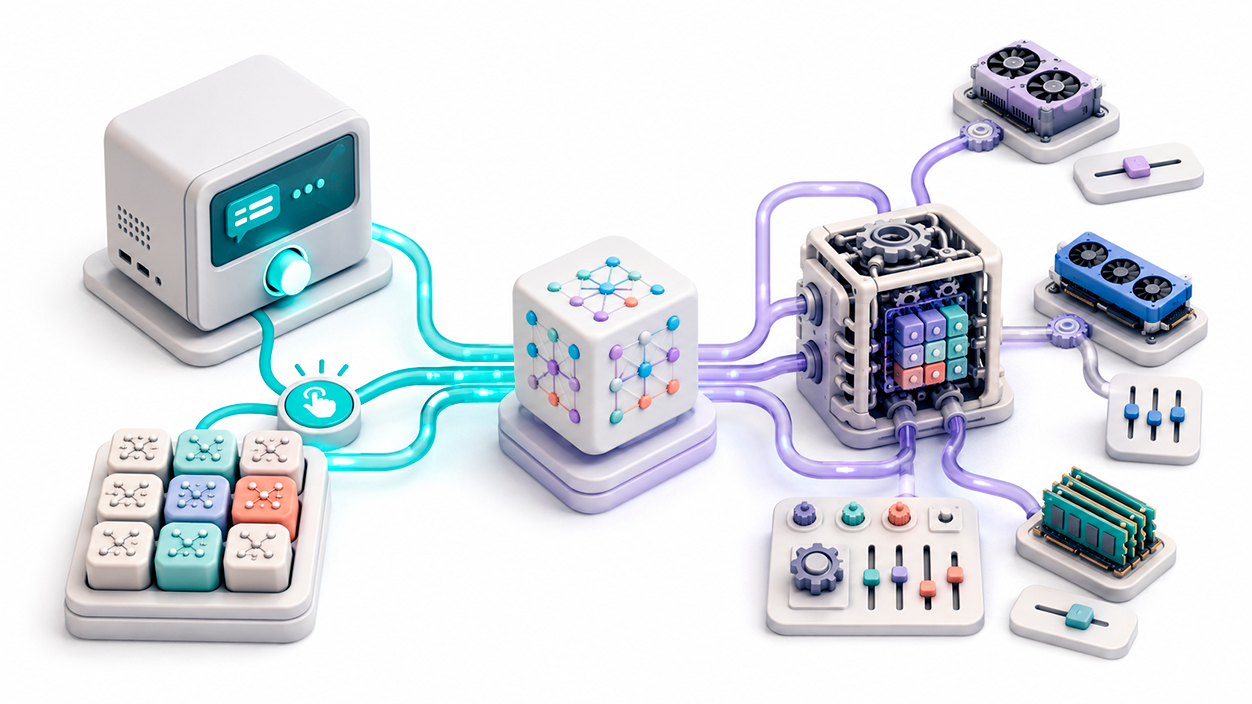
Primerjava med Ollamo in llama.cpp
| Funkcija | Ollama | lama.cpp |
|---|---|---|
| Enostavnost uporabe | Zelo visoko | Srednje ali napredno |
| Prenesi modele | Integrirana knjižnica in uvoz | Lokalne datoteke ali prenos iz Hugging Face |
| Nadzor strojne opreme | Samodejno, z nekaj nastavitvami | Zelo podrobno |
| Konfiguracija CPU/GPU | Na splošno samodejno | Ročno in zelo prilagodljivo |
| Lokalni API | Združljivost z lastniškim API-jem in OpenAI | Strežnik, združljiv z OpenAI |
| Upravljanje modelov | Integrirano prek ukazov | Predvsem na podlagi datotek |
| Posodobitev motorja | Vključeno z Ollamo | Neodvisno in običajno bolj neposredno |
| Uglaševanje zmogljivosti | Preprosto, a bolj omejeno | Zelo prostoren |
| Priporočena uporaba | Uporabniki, prototipi in hitre integracije | Testiranje, optimizacija in uvajanje po meri |
Kateri ponuja boljšo zmogljivost
Ni univerzalnega odgovora. Če Ollama in llama.cpp uporabljata isti model, isto kvantizacijo, enakovreden zaledni program in podobne parametre, njegova zmogljivost je lahko relativno blizuNavsezadnje Ollama uporablja tehnologijo llama.cpp za številne modele.
Vendar pa llama.cpp omogoča večji nadzor nad spremenljivkami in običajno vključuje nekatere optimizacije projekta že prej. Napredni uporabnik lahko prilagodi število slojev, poslanih grafičnemu procesorju, velikosti paketov, predpomnilnik KV, dodelitev naprav in druge parametre, da doseže vrhunsko zmogljivost na svojem računalniku.
Pri določenih modelih ali različicah se lahko pojavijo tudi znatne razlike. To ne pomeni, da je Ollama vedno počasnejša. Rezultat je odvisen od dejavnikov, kot so:
- Uporabljena različica Ollame in llama.cpp.
- Natančna oblika in kvantifikacija modela.
- Izbrani pospeševalni zaledni sistem.
- Dolžina konteksta in velikost predpomnilnika KV.
- Število plasti, ki jih obdela grafični procesor.
- Paralelizacija in število hkratnih zahtev.
- Združljivost modela z vsako implementacijo.
Za pošteno primerjavo je treba uporabiti ista datoteka GGUF in enakovredne parametreObdelavo pozivov in generiranje žetonov merite ločeno ter teste ponovite večkrat. Preprosta primerjava dveh ukazov z njunima privzetima vrednostma lahko da zavajajoče rezultate.
Upravljanje in uvoz modelov
Ollama ponuja bolj organizirano izkušnjo upravljanja modelov. Ukazi, kot so ollama list, ollama pull, ollama show y ollama rm Omogočajo vam ogled, prenos, pregled in brisanje modelov brez ročnega iskanja njihovih datotek.
Poleg uradne knjižnice Ollama omogoča ustvarjanje modelov iz lokalnih datotek GGUFDa bi to naredili, je pot do datoteke določena znotraj datoteke Modelfile in nato uporabljena ollama createZato niste omejeni izključno na modele, objavljene v njihovem katalogu.
Datoteka llama.cpp ponuja bolj neposreden nadzor nad datotekami. Prenesete lahko kateri koli združljiv GGUF, ga shranite v želeno mapo in ga zaženete z različnimi konfiguracijami, ne da bi ga morali predhodno registrirati v knjižnici.
Ta razlika vpliva predvsem na organizacijo. Ollama model in njegovo konfiguracijo spremeni v enoto, ki jo upravlja aplikacija, medtem ko llama.cpp omogoča delo neposredno z datoteko GGUF in njenimi parametri izvajanja.
Združljivost s CPU, GPU in različnimi sistemi
Datoteka llama.cpp izstopa po široki združljivosti s strojno opremo in sistemi za pospeševanje. Glede na platformo in način namestitve ali prevajanja lahko uporablja tehnologije, kot so CUDA, HIP, Metal, Vulkan, SYCL in različne sisteme za izračun procesorjev.
Ta prilagodljivost vam omogoča, da izberete določene naprave, porazdelite model med več grafičnih procesorjev in natančno prilagodite, kateri del bo obdelala posamezna komponenta. To je še posebej uporabno v Strežniki po meri, sistemi z več grafičnimi karticami in nenavadna oprema.
Ollama deluje tudi v sistemih Windows, macOS in Linux ter samodejno zazna združljive grafične procesorje in razpoložljiv pomnilnik. Ta avtomatizacija odpravlja potrebo po ročni konfiguraciji številnih parametrov, čeprav lahko v kompleksnih sistemih ponuja manj nadzora kot neposreden zagon datoteke llama.cpp.
Če Ollama ne prepozna pravilno grafične kartice, lahko večji del modela obdela z uporabo procesorja. V tem primeru je priporočljivo preveriti gonilnike, dnevnike aplikacij, združljivost grafičnih procesorjev in količino pomnilnika, ki ga dejansko uporablja.
Zasebnost in funkcionalnost brez povezave
Obe orodji lahko v celoti izvajata modele na napravi. Ko uporabljate lokalni model GGUF in aplikacija, ki se z njim povezuje, ne pošilja podatkov drugim storitvam, Vsebina lahko ostane v vašem računalniku ali lokalnem omrežju..
Vendar pa sama namestitev Ollame ne zagotavlja, da bodo vse zahteve lokalne. Platforma ima tudi modele v oblaku in zunanje funkcije, ki zahtevajo povezavo in lahko obdelujejo informacije zunaj računalnika. Zato morate preveriti, ali se izbrani model prikaže kot lokalni ali oblačni model.
Datoteka llama.cpp je namenjena predvsem lokalnemu izvajanju ali izvajanju na infrastrukturi, ki jo upravlja uporabnik. Vendar pa je popolna zasebnost odvisna tudi od vmesnika, razširitev, orodij in API-jev, ki se povezujejo s strežnikom.
V obeh primerih lahko izpostavljanje API-ja v omrežju brez preverjanja pristnosti ali ustrezne konfiguracije omogoči drugim napravam dostop do modela. Lokalno izvajanje umetne inteligence ne odpravlja potrebe po zavarovanju strežnika.
Katero izbrati glede na vrsto uporabnika
Ollama je najbolj priporočljiva možnost za začetek. Če želite prenesti modele z uporabo preprostih ukazov, hitro preklapljati med njimi, jih povezati z zunanjimi vmesniki ali razviti prototip, ne da bi porabili preveč časa za konfiguriranje motorja.
Primeren je tudi za razvijalce, ki potrebujejo stabilen in preprost API, uradne knjižnice za Python in JavaScript ter priročen način za skupno rabo iste konfiguracije med več ekipami.
llama.cpp je boljša izbira, če želite:
- Natančno nadzorujte, kako se model porazdeli med CPU in GPU.
- Takoj preizkusite najnovejše funkcije projekta.
- Prilagodite velikost paketa, predpomnilnik KV in paralelizacijo.
- Neposredno delo z različnimi datotekami GGUF.
- Prevedite motor za določeno platformo ali plin.
- Merjenje in optimizacija delovanja strežnika za sklepanje.
Samo število hkratnih uporabnikov ne določa, katerega izbrati. Tako Ollama kot llama-server Lahko obdelajo več zahtev, vendar bo dejanska zmogljivost odvisna od modela, konteksta, razpoložljivega pomnilnika, konfigurirane vzporednosti in sprejemljive zakasnitve.
Ali se lahko Ollama in llama.cpp uporabljata skupaj?
Ni vam treba za vedno izbrati samo enega orodja. Razumen pristop je, da začnete z Ollamo. preizkusite modele in hitro razvijete integracijoČe kasneje potrebujete večji nadzor ali odkrijete ozko grlo, lahko isti model GGUF zaženete neposredno z datoteko llama.cpp in prilagodite njegovo konfiguracijo.
Ollamo lahko obdržite tudi za redne uporabnike ali aplikacije in uporabite llama.cpp kot testno okolje. Na ta način lahko primerjate različice, kvantizacije in parametre, ne da bi pri tem žrtvovali udobje knjižnice Ollama.
Skratka, Ollama daje prednost preprostosti in integriranemu upravljanju, medtem ko llama.cpp ponuja večji nadzor, prilagodljivost in možnosti optimizacijeZa večino novincev v lokalnem svetu umetne inteligence bo Ollama najbolj uporabniku prijazna vstopna točka. Za tiste, ki morajo razumeti in nadzorovati vsako podrobnost sklepanja, ostaja llama.cpp eno najmočnejših orodij v ekosistemu.


Sem tehnološki navdušenec, ki je svoja "geek" zanimanja spremenil v poklic. Več kot 10 let svojega življenja sem porabil za uporabo vrhunske tehnologije in premleval najrazličnejše programe iz čiste radovednosti. Zdaj sem se specializiral za računalniško tehnologijo in video igre. To je zato, ker že več kot 5 let pišem za različna spletna mesta o tehnologiji in video igrah ter ustvarjam članke, ki vam želijo dati informacije, ki jih potrebujete, v jeziku, ki je razumljiv vsem.
Če imate kakršna koli vprašanja, moje znanje sega od vsega v zvezi z operacijskim sistemom Windows kot tudi Androidom za mobilne telefone. In moja zaveza je vam, vedno sem pripravljen porabiti nekaj minut in vam pomagati razrešiti kakršna koli vprašanja, ki jih morda imate v tem internetnem svetu.