- Analys av orsakerna till latens i Gemini, från bearbetning av täta filer till djupt resonemangsläge.
- Förklaring av den nya funktionen "Svara nu" för att snabbare få svar på mobila enheter.
- Guide för att lösa tekniska fel och HTTP-koder för Gemini API-användare.
- Prestandaskillnader mellan Flash- och Pro-modellerna och tokens inverkan på hastigheten.

Det har förmodligen hänt dig mer än en gång: Du ställer en fråga till Tvillingarna. och du bara stirrar på skärmen medan assistenten Det verkar ha blivit tomt eller bearbetas En evig idé. Den där känslan av att AI hon blir "fångad" Det är ett återkommande klagomål bland användare, oavsett om de använder webbversionen eller mobilappen, och det kan vara otroligt frustrerande när man bara behöver en specifik, snabb information.
Sanningen är att denna långsamhet inte alltid är ett systemfel, utan ofta har att göra med hur artificiell intelligens hanterar djup av deras resonemang. Beroende på vilken modell du använder och komplexiteten hos de filer du har tillhandahållit kan väntetiden variera drastiskt, ibland vara mycket längre än hos direkta konkurrenter.

Dokumentens vikt och tokenhantering
När man arbetar med mycket stora PDF-filer blir prestandaskillnaden tydlig. Till exempel när man matar AI:n med ett dokument av 150 000 tokensDet har observerats att Det kan ta flera minuter för Gemini att bearbeta särskilt långa dokumentmedan andra modeller som är mer optimerade för snabbt resonemang kan lösa samma fråga på några sekunder.
Detta fenomen uppstår eftersom Tvillingarna försöker analysera texten på djupet och med en extrem omsorgsfullhet, vilket ökar latensenOm dokumentet är rent textbaserat och väldigt kompakt blir processen att läsa och extrahera information mycket tyngre, vilket genererar den där långa laddningsanimationen som får oss att tro att appen har slutat fungera.

Googles lösning: Knappen "Svara nu"
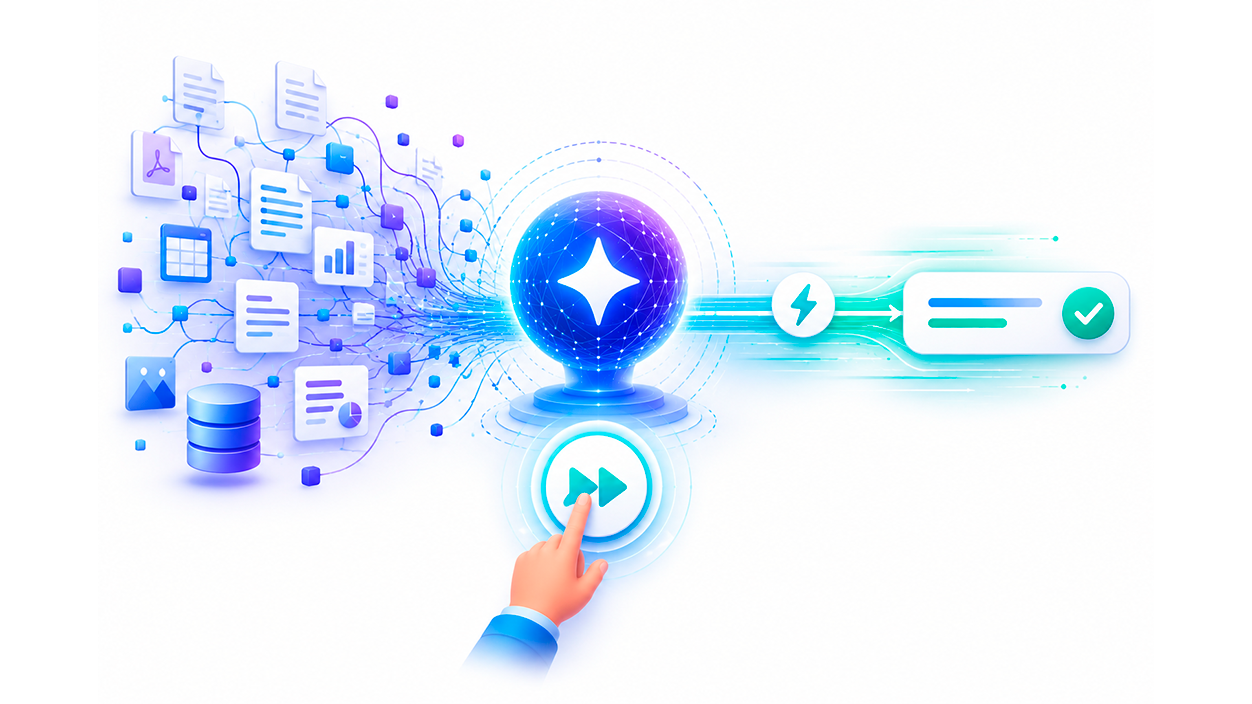
För att lindra denna frustration har Google implementerat en mycket praktisk funktion som heter "Svara nu" på Android och "Hoppa över" på iOS. I grund och botten är det en genväg för att säga åt AI:n att sluta övertänka och gå rakt på sak, och prioritera hastighet framför analysens djup.
Den här knappen visas specifikt när du använder avancerade lägen i GeminiOm du ser att AI:n tar för lång tid på sig att tänka kan du trycka på knappen för att hoppa över det komplexa resonemanget. Det är ett idealiskt verktyg för enkla frågor där vi inte behöver maskinen för att analysera varje nyans, utan snarare för att ge oss svaret. på några sekunder.
Förstå de olika reaktionssätten
För att dra full nytta av hastigheten är det viktigt att veta vilken modell vi kör från programmets nedre fält:
- Snabbläge: Den är som standard optimerad för omedelbarhet.
- Resonemangsläge (Tänkande): Perfekt för komplexa problem, även om det är där väntetiden är mest märkbar.
- Pro-läge: Utformad för krävande uppgifter som avancerad matematik eller programmering.
Fördelen med den här nya knappen är att du inte behöver byta modell manuellt; du kan vara i Pro-läge och, om svaret tar för lång tid, tvinga fram ett snabbt svar med ett enda tryck. Det är dock viktigt att komma ihåg att genom att hoppa över djupgående resonemang kan AI:n förenkla svaret eller att göra misstag i mycket tekniska uppgifter.
Teknisk diagnostik för API-användare
Om problemet inte uppstår i appen utan när man gör anrop via API:et är orsaken vanligtvis mer teknisk. Det finns specifika felkoder Dessa fel indikerar varför svaret inte tas emot eller tar för lång tid. Till exempel uppstår fel 504 (DEADLINE_EXCEEDED) när instruktionen eller kontexten är så stor att tjänsten inte kan bearbeta den inom den fastställda tidsgränsen.
En annan kritisk punkt är användning av tankefunktionen i 2.5 Flash- och Pro-modellerna. Den här funktionen är aktiverad som standard för att förbättra kvaliteten, men den ökar latensen. Om du vill minimera kostnader och tid är det bästa alternativet justera eller inaktivera resonemanget med hjälp av konfigurationskoden.
Tabell över vanliga fel och lösningar
I API-backend är det vanligt att stöta på situationer som Tjänstemättnad (fel 503) eller att inmatningskontexten är för lång (fel 500). I dessa fall innebär lösningen vanligtvis att minska mängden data som skickas eller tillfälligt byta modell, till exempel att byta från Pro till Flash för att se om hastigheten förbättras.
Det är också viktigt att övervaka modellens temperatur. Även om det rekommenderas att behålla standardvärdena kan det hjälpa att höja temperaturen till 0.8 eller högre. undvik loopar av repetitiv text eller problem med Markdown-tabeller, även om detta inte direkt påverkar den initiala svarshastigheten, förbättrar det flytet i slutresultatet.
Långsamheten i Gemini är oftast resultatet av en balans mellan noggrannhet och hastighet, där bearbetning av stora datamängder och djupreflektion är tidskrävande. Lyckligtvis, med introduktionen av verktyg som snabbsvarsknappen och Flash-modelloptimering, har användare nu... mer kontroll över upplevelsenDu kan välja mellan en grundlig analys eller ett omedelbart svar beroende på hur brådskande din fråga är.


Jag är en teknikentusiast som har gjort sina "nördar"-intressen till ett yrke. Jag har tillbringat mer än 10 år av mitt liv med att använda den senaste tekniken och mixtrat med alla typer av program av ren nyfikenhet. Nu har jag specialiserat mig på datateknik och tv-spel. Detta beror på att jag i mer än 5 år har arbetat med att skriva för olika webbplatser om teknik och videospel, skapa artiklar som försöker ge dig den information du behöver på ett språk som är begripligt för alla.
Om du har några frågor sträcker sig min kunskap från allt som rör operativsystemet Windows samt Android för mobiltelefoner. Och mitt engagemang är för dig, jag är alltid villig att spendera några minuter och hjälpa dig att lösa alla frågor du kan ha i den här internetvärlden.