
I det här inlägget berättar vi hur du installerar LiteLLM och konsoliderar flera AI-API:er till ett. Detta är särskilt användbart om du arbetar med flera språkmodeller (LLM) och behöver implementera ett mer centraliserat och organiserat ledningssystemLiteLLM är ett av de bästa alternativen för att använda ett enda OpenAI-kompatibelt API som ger åtkomst till flera leverantörer.
Installera LiteLLM: ett enda API för att få åtkomst till flera AI-leverantörer
Har du ett projekt som använder OpenAI, ett annat med Claude, ett till med Gemini och ett annat som körs lokalt med Ollama? Då vet du hur svårt det kan vara. hantera flera API:er, olika SDK:er och olika anslutningslägen mellan leverantörerLösningen? Att installera LiteLLM och kombinera flera AI-API:er till ett kan få slut på kaoset och ge dig tillbaka kontrollen.
Liksom OpenRouter syftar LiteLLM till att lösa samma grundläggande problem: erbjuda ett enda OpenAI-kompatibelt API för åtkomst till flera AI-modellleverantörerBåda uppvisar en slutpunkt De är kompatibla med OpenAI och ger tillgång till dussintals modeller och leverantörer samt underlättar kostnadskontroll, bland andra funktioner.
Och hur skiljer de sig åt? Främst, i distributionsmodellenMedan OpenRouter är en slutpunkt Till skillnad från en fjärrserver som du ansluter direkt till, körs LiteLLM på din egen maskin eller server (via Docker eller Python). Detta gör LiteLLM till det föredragna valet för de som behöver uppfylla strikta krav på datalagring eller integritet.
Det intressanta är att Många team kombinerar båda verktygenDe använder LiteLLM som inkörsport internt och konfigurera OpenRouter som bara en annan leverantör i bakgrunden. Detta ger dem total kontroll över sina slutpunkt samtidigt som man drar nytta av OpenRouter-katalogen från backend (Se inlägget) Hur man skapar och konfigurerar ett OpenRouter-kontoMed det sagt, låt oss nu prata om hur man installerar LiteLLM och sammanför flera AI-API:er till ett.
Hur man installerar LiteLLM och kombinerar flera AI-API:er till ett
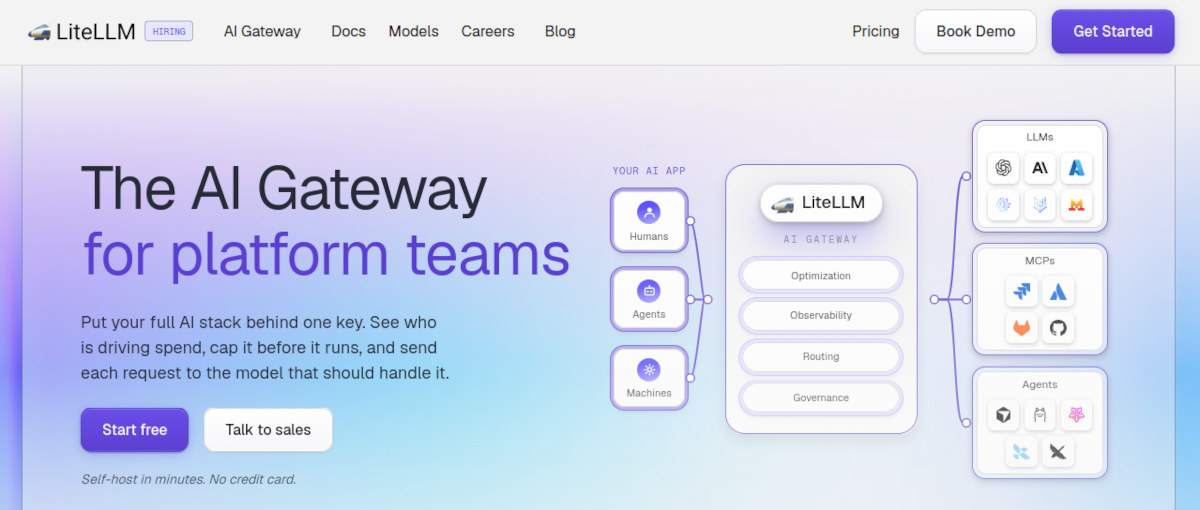
LiteLLM Den erbjuder två sätt att använda denDu kan installera det som ett grundläggande Python SDK med hjälp av pip install litellmeller driftsätta den som en proxyserver (för team och produktion). Om du vill installera LiteLLM och konsolidera flera AI-API:er till ett, behöver du proxyn, eftersom den exponerar en slutpunkt Centraliserad HTTP där du konfigurerar alla dina modeller. Så vi fokuserar på det senare.
La ett mer effektivt sätt För att köra LiteLLM som en proxyserver distribuerar du den i en Docker-container. Detta säkerställer att den körs som en fristående tjänst i bakgrunden på din dator eller server. Dessutom låter Docker dig orkestrera komplex routing, utgiftsgränser per enhet och nyckelrotation inom en enda YAML-fil.
Det första steget för att installera LiteLLM och kombinera flera AI-API:er till ett är skapa projektstrukturenFör att göra detta, öppna din terminal och skapa en dedikerad mapp för proxykonfiguration genom att köra följande kommando mkdir litellm-proxy && cd litellm-proxyNär detta är klart kan du gå vidare till att konfigurera YAML-modellfilen, som är den centrala punkten för unifiering.
Modell YAML-filkonfiguration
Nästa steg är att Konfigurera YAML-filen för att definiera vilka språkmodeller du vill exponera och hur du ansluter till dem.Naturligtvis behöver du API-nycklarna för var och en: det vi ska göra är att förena dem alla i en enda konfiguration. Du behöver också det exakta namnet på varje modell.
Förutom att lista modellerna bör YAML-filen också definiera vilka modeller som ska fungera som säkerhetskopior om den primära modellen misslyckas. Granska noggrant följande struktur för att se dessa detaljer. I följande fil kommer vi att förena Kommersiella leverantörer (OpenAI, Anthropic, Gemini), tjänster som OpenRouter och lokala modeller som körs på Ollama. YAML-filstrukturen skulle se ut så här:
modell_lista: # Affärsmodell 1: OpenAI - modell_namn: gpt-4o litellm_params: modell: gpt-4o api_key: os.environ/OPENAI_API_KEY # Affärsmodell 2: Anthropic Claude - modell_namn: claude-3-5-sonnet litellm_params: modell: claude-3-5-sonnet-20240620 api_key: os.environ/ANTHROPIC_API_KEY # Extern aggregator: OpenRouter - modell_namn: openrouter-llama litellm_params: modell: openrouter/meta-llama/llama-3.1-70b-instruct api_key: os.environ/OPENROUTER_API_KEY # Lokal modell: Ollama - modell_namn: llama3-local litellm_params: modell: llama/llama3 api_base: http://host.docker.internal:11434 router_settings: num_retries: 3 timeout: 15 fallbacks: - gpt-4o: ["claude-3-5-sonnet", "openrouter-llama"]
Definiera miljövariablerna och distribuera LiteLLM-behållaren
Nästa steg är att skapa en .env-fil i samma katalog för att lagra dina privata API-nycklar utan att exponera dem i koden. Du kommer att märka att nycklarna inte är annoterade i den föregående confi.yaml-filen för att undvika att exponera dem. Därför är det nödvändigt att samla dem alla i en enda fil. .env-fil som följande:
OPENAI_API_KEY=sk-proj-din-nyckel-här ANTHROPIC_API_KEY=sk-ant-din-nyckel-här OPENROUTER_API_KEY=sk-eller-din-nyckel-här LITELLM_MASTER_KEY=sk-min-master-proxynyckel
Och det är allt! Så här installerar du LiteLLM och kombinerar flera AI-API:er till ett. Det som återstår att göra är Starta den officiella LiteLLM-containern och se till att länka den till ovanstående konfigurations- och miljövariabler.Du kan göra detta genom att köra följande kommando:
docker run -d \ --name litellm-proxy \ -p 4000:4000 \ --env-file .env \ -v $(pwd)/config.yaml:/app/config.yaml \ ghcr.io/berriai/litellm:main-latest \ --config /app/config.yaml --port 4000
Verifiering och testning av inkörsport enad
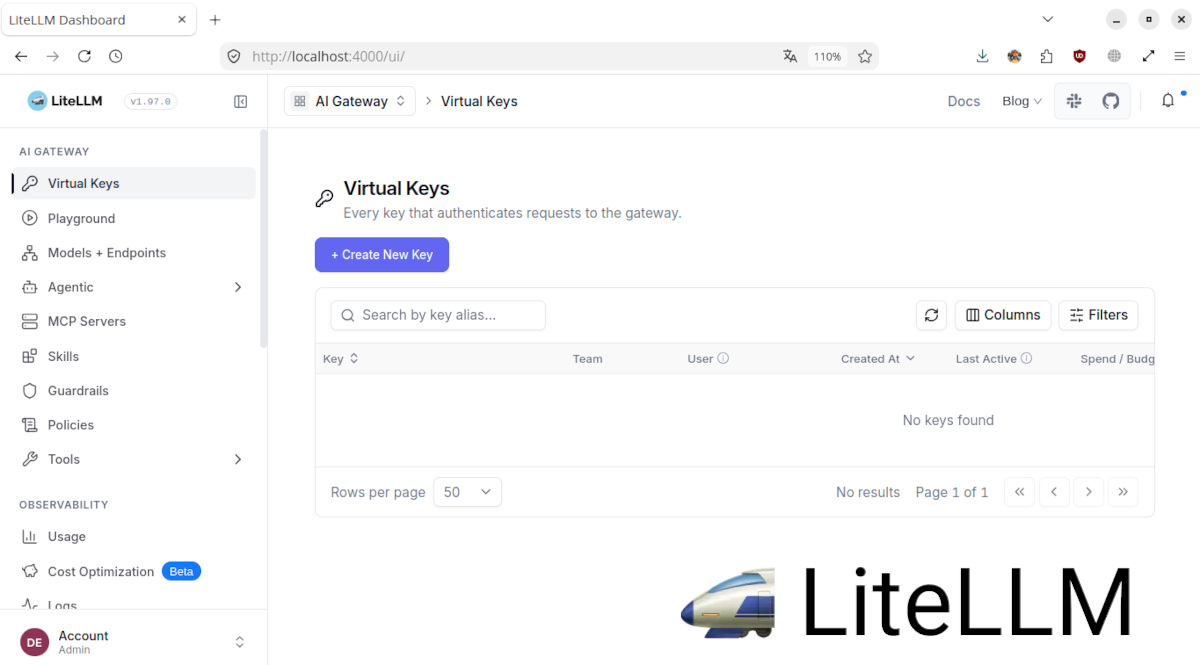
Slutligen verifierar vi att processen att installera LiteLLM och slå samman flera AI-API:er till ett lyckades. Om allt gick bra och containern redan körs, LiteLLM kommer att lyssna på http://localhost:4000Från och med nu kommer alla kommersiella applikationer eller skript som är kompatibla med OpenAI API att kunna använda din ombud från LiteLLM.
Vill du prova det? Försök att skicka ett HTTP-begäran med hjälp av huvudnyckeln som definierats i din .env-fil. Det skulle se ut ungefär så här:
curl --location 'http://localhost:4000/v1/chat/completions' \ --header 'Auktorisering: Bärare sk-my-master-key-proxy' \ --header 'Innehållstyp: application/json' \ --data '{ "modell": "gpt-4o", "meddelanden": [ {"roll": "användare", "innehåll": "Genererar en lista med 3 bästa praxis för mikrotjänster."} ] }'
LiteLLM: ett enda API för att kontrollera dem alla
Som du kan se är det en enkel och verkligt användbar process att installera LiteLLM och kombinera flera AI-API:er till ett. LiteLLM, installerat som en proxy med Docker, erbjuder dig en enda, användarstyrd åtkomstpunkt för alla dina AI-API:erTill skillnad från OpenRouter (som är en hanterad SaaS-tjänst) ger LiteLLM dig fullständig kontroll över dina data och kostnader. I gengäld måste du dock underhålla din egen infrastruktur.
Installation med Docker är den rekommenderade vägen för team. Du kan ha en centraliserad gateway på några minuter Där OpenAI, Anthropic, Gemini, lokala modeller och till och med OpenRouter möts, allt exponerat under en enda OpenAI-kompatibel slutpunkt. Prova det: centralisera dina nycklar och modeller med LiteLLM. Din kod och ditt förnuft kommer att tacka dig.

Ända sedan jag var liten har jag varit fascinerad av allt som rör vetenskap och teknologi, särskilt de framsteg som gör våra liv enklare och roligare. Jag älskar att hålla mig uppdaterad om de senaste nyheterna och trenderna, och att dela med mig av mina erfarenheter, åsikter och tips om de enheter och prylar jag använder. Detta ledde mig till att bli webbskribent för drygt fem år sedan, med fokus främst på Android-enheter och Windows-operativsystem. Jag har lärt mig att förklara komplexa koncept på ett enkelt sätt så att mina läsare lätt kan förstå dem.