
本文将介绍如何安装 LiteLLM 并将多个 AI API 整合到一个 API 中。如果您使用多个语言模型 (LLM) 并且需要……,这将特别有用。 实施更加集中化和有组织的管理体系LiteLLM 是使用单个 OpenAI 兼容 API 访问多个提供商的最佳替代方案之一。
安装 LiteLLM:一个可访问多个 AI 提供商的单一 API
你是不是同时在做三个项目:一个用 OpenAI,一个用 Claude,一个用 Gemini,还有一个用 Ollama 在本地运行?如果是这样,那你肯定知道这有多难。 管理多个 API、不同的 SDK 以及提供商之间的不同连接模式解决方案是什么?安装 LiteLLM 并将多个 AI API 合并为一个,即可结束混乱局面,让您重新掌控一切。
与 OpenRouter 一样,LiteLLM 的目标也是解决同一个根本问题: 提供单一的 OpenAI 兼容 API,用于访问多个 AI 模型提供商两者都表现出 端点 它们与 OpenAI 兼容,提供对数十种模型和提供商的访问,并有助于控制费用,以及其他功能。
它们之间有何区别?主要区别在于: 在部署模型中虽然 OpenRouter 是一个 端点 与直接连接的远程服务器不同,LiteLLM 运行在您自己的机器或服务器上(通过 Docker 或 Python)。这使得 LiteLLM 成为那些需要满足严格数据驻留或隐私要求的用户的首选。
有趣的是 许多团队会同时使用这两种工具。他们使用 LiteLLM 作为 网关 在内部配置 OpenRouter,并将其作为后台的另一个提供商运行。这使他们拥有完全的控制权。 端点 同时利用 OpenRouter 目录 后端 (参见相关条目) 如何创建和配置 OpenRouter 帐户话虽如此,现在让我们来谈谈如何安装 LiteLLM 并将多个 AI API 整合到一个 API 中。
如何安装 LiteLLM 并将多个 AI API 合并到一个应用程序中
LiteLLM 它提供了两种使用方式你可以使用以下方式将其安装为基本的 Python SDK: pip install litellm或者将其部署为代理服务器(用于团队和生产环境)。如果您想安装 LiteLLM 并将多个 AI API 合并为一个,则需要代理,因为它公开了一个代理。 端点 集中式 HTTP,您可以在其中配置所有模型。因此,我们将重点关注后者。
La 更高效的方式 要将 LiteLLM 用作代理服务器,您需要将其部署在 Docker 容器中。这样可以确保它作为独立服务在您的计算机或服务器后台运行。此外,Docker 还允许您在单个 YAML 文件中协调复杂的路由、单设备消费限额和密钥轮换。
安装 LiteLLM 并将多个 AI API 合并为一个 API 的第一步是: 创建项目结构为此,请打开终端并运行以下命令创建一个专门用于代理配置的文件夹。 mkdir litellm-proxy && cd litellm-proxy完成此操作后,您可以继续配置 YAML 模型文件,它是统一的中心点。
模型 YAML 文件配置
接下来,我们需要 配置 YAML 文件,定义要公开哪些语言模型以及如何连接到它们。当然,您需要每个模型的 API 密钥:我们将把它们全部合并到一个配置中。您还需要每个模型的准确名称。
除了列出模型之外,YAML 文件还应定义哪些模型将作为备份模型,以防主模型发生故障。请仔细查看以下结构以了解这些详细信息。 在以下文件中,我们将统一 商业供应商(OpenAI、Anthropic、Gemini)、OpenRouter 等服务以及运行在 Ollama 上的本地模型。YAML 文件结构如下所示:
model_list: # 商业模型 1:OpenAI - model_name: gpt-4o litellm_params: model: gpt-4o api_key: os.environ/OPENAI_API_KEY # 商业模型 2:Anthropic Claude - model_name: claude-3-5-sonnet litellm_params: model: claude-3-5-sonnet-20240620 api_key: os.environ/ANTHROPIC_API_KEY # 外部聚合器:OpenRouter - model_name: openrouter-llama litellm_params: model: openrouter/meta-llama/llama-3.1-70b-instruct api_key: os.environ/OPENROUTER_API_KEY # 本地模型:Ollama - model_name: llama3-local litellm_params: model: llama/llama3 api_base: http://host.docker.internal:11434 router_settings: num_retries: 3 timeout: 15 fallbacks: - gpt-4o: ["claude-3-5-sonnet", "openrouter-llama"]
定义环境变量并部署 LiteLLM 容器
接下来,您需要在同一目录下创建一个 .env 文件,用于存储您的私有 API 密钥,而无需在代码中暴露它们。您会注意到,之前的 confi.yaml 文件中并没有对这些密钥进行注解,以避免泄露它们。因此,必须将它们全部集中到一个文件中。 .env 文件 例如:
OPENAI_API_KEY=sk-proj-你的密钥-这里填写 ANTHROPIC_API_KEY=sk-ant-你的密钥-这里填写 OPENROUTER_API_KEY=sk-or-你的密钥-这里填写 LITELLM_MASTER_KEY=sk-我的主代理密钥
就这样!这就是安装 LiteLLM 并将多个 AI API 合并为一个的方法。接下来要做的是…… 启动官方 LiteLLM 容器,确保将其与上述配置和环境变量关联。您可以通过运行以下命令来完成此操作:
docker run -d \ --name litellm-proxy \ -p 4000:4000 \ --env-file .env \ -v $(pwd)/config.yaml:/app/config.yaml \ ghcr.io/berriai/litellm:main-latest \ --config /app/config.yaml --port 4000
验证和测试 网关 统一
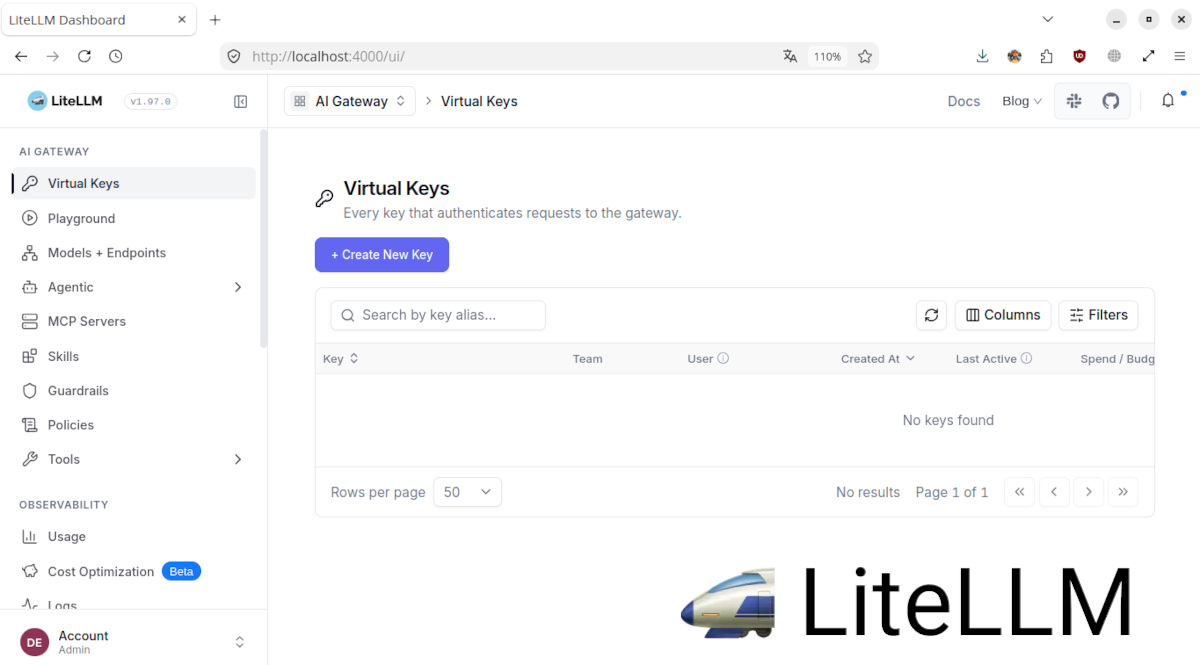
最后,我们将验证 LiteLLM 的安装以及将多个 AI API 合并为一个的过程是否成功。如果一切顺利,容器已在运行, LiteLLM 将会监听 http://localhost:4000从现在开始,任何与 OpenAI API 兼容的商业应用程序或脚本都将能够使用您的数据。 代理人 来自 LiteLLM。
你想试试吗?试试发送一封邮件 HTTP 请求 使用在 .env 文件中定义的主密钥。它看起来会像这样:
curl --location 'http://localhost:4000/v1/chat/completions' \ --header 'Authorization: Bearer sk-my-master-key-proxy' \ --header 'Content-Type: application/json' \ --data '{ "model": "gpt-4o", "messages": [ {"role": "user", "content": "生成微服务的 3 个最佳实践列表。"} ] }'
LiteLLM:一个用于控制所有设备的统一 API
如您所见,安装 LiteLLM 并将多个 AI API 集成到一个系统中是一个简单且非常实用的过程。LiteLLM 作为 Docker 代理安装,为您提供以下功能: 一个用户可控的单一入口,用于访问您的所有 AI API与 OpenRouter(一种托管式 SaaS 服务)不同,LiteLLM 让您可以完全掌控自己的数据和成本。但作为交换,您需要维护自己的基础设施。
对于团队而言,推荐使用 Docker 进行安装。 几分钟内即可拥有集中式网关 LiteLLM 将 OpenAI、Anthropic、Gemini、本地模型,甚至 OpenRouter 等工具整合在一起,并通过一个兼容 OpenAI 的统一接口进行管理。不妨一试:使用 LiteLLM 集中管理您的密钥和模型。您的代码和工作效率都会因此受益。

从小我就对科学技术着迷,尤其对那些让我们的生活更轻松、更美好的进步更感兴趣。我喜欢关注最新的新闻和趋势,并乐于分享我使用各种设备和小工具的经验、观点和技巧。五年前,我开始从事网络写作,主要关注安卓设备和Windows操作系统。我学会了用浅显易懂的语言解释复杂的概念,让读者能够轻松理解。