- 使用 Ollama 作为推理引擎和嵌入技术,搭建持久内存生态系统。
- 使用 Qdrant 或 ChromaDB 实现本地向量数据库,以避免对云的依赖。
- 通过同步特定向量维度来优化事实提取。

语言模型不会自动记住之前对话的内容。当您关闭应用程序、切换会话或从上下文窗口删除旧消息时,模型会丢失这些信息。
克服这一限制的一种方法是 与 Ollama 连接备忘录Ollama 在本地运行生成模型和嵌入模型,而 Mem0 从对话中提取有用信息,对其进行组织,并允许在再次相关时检索它。
应用程序无需每次都向模型发送完整的历史记录,而是可以检索与当前查询相关的部分记忆并将其插入到提示信息中。这样可以减少上下文信息量,并允许在不同会话之间保留偏好设置、目标或重要信息。
如果您使用 Ollama、Mem0 OSS 和本地数据库,则该安装可以完全在您的基础架构内运行。但是,最终的隐私保护取决于所有连接的组件。如果您添加外部模型、重排序器、数据库或托管服务,则部分数据可能会离开您的系统。
Mem0 的作用是什么?Ollama 的功能又是什么?
Mem0 和 Ollama 解决的是不同的问题。 Ollama负责运行这些模型。而 Mem0 则提供了添加、搜索、查询、更新和删除内存所需的操作。
在保存过程中,Mem0 可以分析对话并提取出以后可能用到的信息。例如:
- 用户更喜欢简短的答案。
- 他正在用 Rust 开发一个应用程序。
- 他不需要恐怖电影推荐。
- 他们的目标是在四小时内完成比赛。
Mem0 使用嵌入模型将每个记忆转换为数值表示,并将其与内容和元数据一起存储。执行搜索时,它会将查询与用户标识符等过滤器相结合,并返回最相关的记忆。
当前版本的 Mem0 主要采用增量式数据提取。这意味着新信息可以存储而不会自动删除先前的数据。如果数据已过时需要更正,应用程序可以显式地使用相应的操作。 update() o delete().
Mem0 并不能取代对话模型。应用程序必须检索记忆,将其整合到系统消息或上下文中,然后请求 Ollama 生成响应。
将 Mem0 与 Ollama 连接所需的组件
要构建本地系统,您需要以下组件:
- OSS备忘录: 管理记忆的提取、存储和检索。
- 奥拉玛: 它执行生成模型和嵌入模型。
- 语言模型: 它解读对话并生成回复。
- 嵌入模型: 将内存和查询转换为向量。
- 矢量图库: 它保留了向量,并允许您搜索相关内存。
- 一个应用程序: 它将对话、检索和记忆保存联系起来。
Qdrant 和 Chroma 是两种常见的存储选项:
| 店铺 | 推荐用途 |
|---|---|
| Qdrant | 使用 Docker 实现持久服务、多应用程序和部署 |
| 色度 | 本地测试和带有文件夹存储的小应用程序 |
Qdrant 提供独立的 API,方便将矢量数据库与应用程序分离。Chroma 可以使用本地路由,从而简化初始测试。
如何安装 Mem0、Ollama 和 Qdrant
首先,安装 Ollama 并验证服务是否正在运行。然后,下载语言模型和嵌入模型:
ollama pull llama3.1:latest
ollama pull nomic-embed-text:latest
llama3.1:latest 这是官方 Mem0 示例中使用的模型,但您可以将其替换为其他与 Ollama 兼容的指令模型。较小的模型占用内存更少,但提取数据的准确性可能较低,或者与预期格式的契合度较差。
安装 Python 依赖项:
pip install mem0ai qdrant-client openai ollama要在 Docker 中运行 Qdrant 并使用卷保存数据,请使用:
docker volume create qdrant_storage

docker run -d \
  --name qdrant \
  -p 6333:6333 \
  -p 6334:6334 \
  -v qdrant_storage:/qdrant/storage \
  qdrant/qdrant
港口 6333 提供 HTTP API 和 6334 它用于 gRPC。在本例中,Mem0 使用 HTTP API 进行连接。
检查 Ollama 是否有响应:
curl http://localhost:11434/api/tags您可以通过打开以下链接来查看 Qdrant:
http://localhost:6333/dashboard请勿将这些端口直接暴露在互联网上。如果这些服务运行在不同的计算机上,请使用专用网络、VPN 或防火墙规则,仅允许必要的连接。
使用 Ollama 和 Qdrant 对 Mem0 进行本地配置
配置必须明确声明 Ollama 将用作 LLM 和嵌入提供程序。它还必须定义 Qdrant 的位置以及生成嵌入的维度。
from mem0 import Memory

OLLAMA_URL = "http://localhost:11434"
CHAT_MODEL = "llama3.1:latest"
EMBEDDING_MODEL = "nomic-embed-text:latest"

config = {
    "vector_store": {
        "provider": "qdrant",
        "config": {
            "collection_name": "memoria_agente",
            "host": "localhost",
            "port": 6333,
            "embedding_model_dims": 768,
        },
    },
    "llm": {
        "provider": "ollama",
        "config": {
            "model": CHAT_MODEL,
            "temperature": 0,
            "max_tokens": 2000,
            "ollama_base_url": OLLAMA_URL,
        },
    },
    "embedder": {
        "provider": "ollama",
        "config": {
            "model": EMBEDDING_MODEL,
            "ollama_base_url": OLLAMA_URL,
        },
    },
    "history_db_path": "./mem0_history.db",
    "custom_instructions": """
    Extrae únicamente información que pueda ser útil en conversaciones futuras:
    - Preferencias estables
    - Objetivos y proyectos
    - Restricciones importantes
    - Decisiones confirmadas

    Ignora saludos, conversación casual y hechos temporales sin importancia.
    Devuelve un objeto JSON con la clave facts y una lista de recuerdos.
    """,
}

memory = Memory.from_config(config)
Memory.from_config() 它强制 Mem0 使用指定的提供程序。构造函数 Memory() 它不会自动连接到 Mem0 云,但如果您不替换默认的 OpenAI 组件,它可以应用默认的 OpenAI 组件并请求密钥。
custom_instructions 它允许您确定哪些信息需要存储。在创建实例之前,必须将其作为顶级属性包含在内。 Memory.
为什么嵌入维度必须匹配
该模型 nomic-embed-text 生成向量 768 尺寸因此,Qdrant 集合的配置方式如下:
embedding_model_dims=768如果存储需要不同大小的向量,Qdrant 将拒绝数据,Mem0 将无法正确保存或查询内存。
更改嵌入模型时,请先检查其尺寸,然后再修改设置。您可能还需要创建一个新的集合并重新生成所有现有向量。
不要将不同模型生成的嵌入向量混放在同一个集合中。即使两个模型生成的向量维度相同,它们的语义空间也可能不兼容。
如何保存和检索记忆
要保存对话,请将消息列表传递给 memory.add() 并指示用户的稳定标识符:
mensajes = [
    {
        "role": "user",
        "content": "Estoy desarrollando una aplicación en Rust"
    },
    {
        "role": "assistant",
        "content": "Lo recordaré para adaptar los próximos ejemplos"
    }
]

resultado = memory.add(
    mensajes,
    user_id="usuario_001"
)

print(resultado)
和 infer=True默认情况下,Mem0 使用该模型提取结构化内存。如果您想在不进行此提取的情况下保留内容,可以使用以下方法。 infer=False.
查找相关信息:
recuerdos = memory.search(
    "¿Qué lenguaje utiliza en su proyecto?",
    filters={"user_id": "usuario_001"},
    top_k=5
)

for recuerdo in recuerdos["results"]:
    print(recuerdo["memory"])
筛选条件 user_id 这一点至关重要。如果多人使用的应用程序在搜索时没有正确应用标识符,则可能会检索到属于其他用户的记忆。
你也可以使用 agent_id 区分不同代理的记忆和 run_id 用于划分对话、项目或特定流程。
如何使用 Ollama 和 Mem0 创建完整的聊天记录
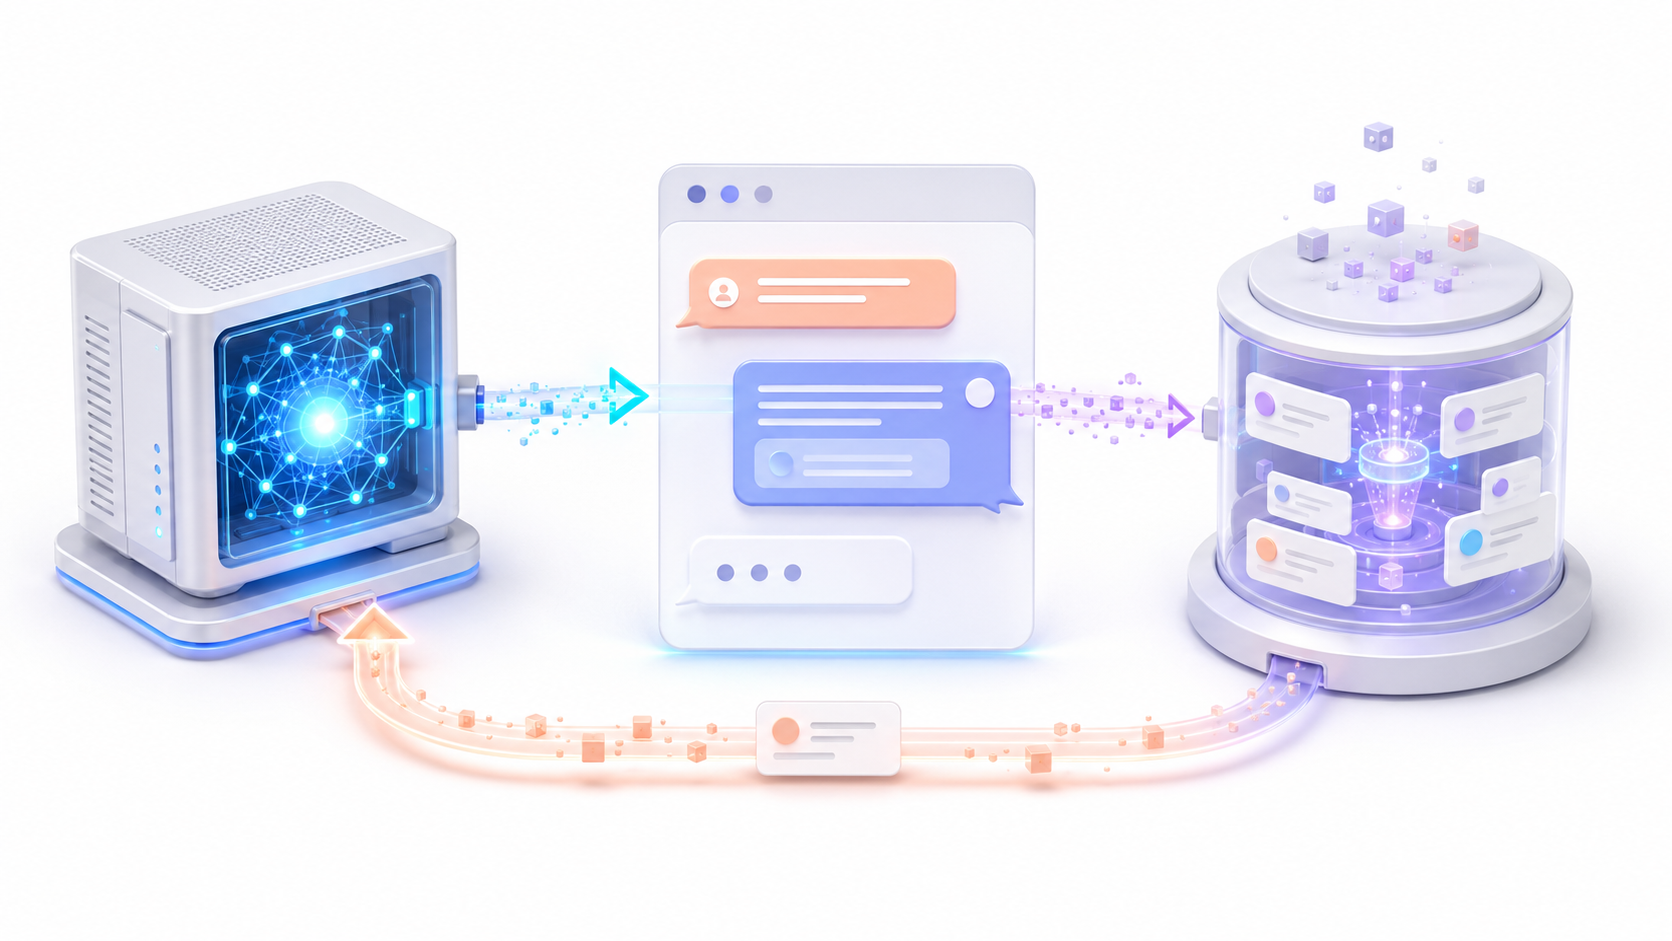
要让 Ollama 使用内存,该应用程序必须执行以下四个步骤:
- 接收用户的问题。
- 使用 Mem0 搜索相关记忆。
- 将它们添加到发送给 Ollama 的上下文中。
- 将问题和答案保存为新的互动。
Ollama 提供了一个与 OpenAI 格式兼容的 API。我们可以用它来创建完整的循环:
from openai import OpenAI

ollama_chat = OpenAI(
    base_url=f"{OLLAMA_URL}/v1",
    api_key="ollama"
)

def chat(mensaje_usuario, user_id):
    resultado = memory.search(
        mensaje_usuario,
        filters={"user_id": user_id},
        top_k=5
    )

    recuerdos = [
        item["memory"]
        for item in resultado["results"]
    ]

    contexto = "\n".join(
        f"- {recuerdo}" for recuerdo in recuerdos
    )

    respuesta = ollama_chat.chat.completions.create(
        model=CHAT_MODEL,
        messages=[
            {
                "role": "system",
                "content": (
                    "Eres un asistente útil. Utiliza los recuerdos "
                    "solo cuando sean relevantes.\n\n"
                    f"Recuerdos del usuario:\n{contexto}"
                ),
            },
            {
                "role": "user",
                "content": mensaje_usuario,
            },
        ],
    ).choices[0].message.content

    memory.add(
        [
            {
                "role": "user",
                "content": mensaje_usuario,
            },
            {
                "role": "assistant",
                "content": respuesta,
            },
        ],
        user_id=user_id,
    )

    return respuesta
现在你可以开始对话了:
print(
    chat(
        "Estoy creando un programa de escritorio en Rust",
        user_id="usuario_001"
    )
)
重启应用程序后,同一用户可能会提出以下问题:
print(
    chat(
        "¿Qué lenguaje estoy utilizando en mi proyecto?",
        user_id="usuario_001"
    )
)
如果内存存储正确,Mem0 将检索信息,Ollama 将能够使用它来做出响应。
如何使用 Chroma 代替 Qdrant
对于小型本地测试,您可以将 Qdrant 替换为 Chroma。Mem0 上的正确提供程序名称是 chroma:
"vector_store": {
    "provider": "chroma",
    "config": {
        "collection_name": "memoria_agente",
        "path": "./chroma_db",
    },
}
文件夹中指示的内容 path 它将包含 Chroma 的持久数据。您必须将其包含在备份中,并且在更新应用程序时避免将其删除。
该项目使用的 Python 包仍然叫做 chromadb但是,您需要在 Mem0 配置中写入的标识符是 chroma.
如何更正或删除过时的记忆
不应将助手的记忆视为绝对可靠的信息来源。该模型可能存储被误解的事实,保留已失效的信息,或者生成多个相似的记忆。
您可以查看与用户关联的所有回忆:
resultado = memory.get_all(
    filters={"user_id": "usuario_001"}
)

for recuerdo in resultado["results"]:
    print(recuerdo["id"], recuerdo["memory"])
纠正特定记忆:
memory.update(
    memory_id="ID_DEL_RECUERDO",
    data="El usuario está desarrollando una aplicación en Python"
)
要将其移除:
memory.delete(
    memory_id="ID_DEL_RECUERDO"
)
面向最终用户的应用程序应提供查看、更正和删除已存储记忆的控制功能。此外,建议为临时信息制定过期策略。
如何提高记忆质量
质量取决于模型、说明、对话以及发送的信息量。使用较大的模型并不能保证获得更好的结果,尽管非常小的模型可能会遗漏细微差别或返回错误的格式。
这些方法有助于提高记忆力:
- 使用低温可以使萃取更加稳定。
- 明确定义哪些类别值得记住。
- 排除问候语、重复内容和无关对话。
- 保存用户消息和客服回复。
- 对用户、代理和项目使用不同的标识符。
- 限制检索的记忆数量,以免干扰上下文。
- 定期审查不正确、重复或过时的记忆。
- 在投入生产环境之前,请使用真实查询测试搜索功能。
不要将记忆作为首要指令引入。应将其视为可能不完整或过时的背景信息。这样可以降低被操纵的记忆改变智能体整体行为的风险。
性能优化
每次调用 memory.add() 您可以运行模型来提取需要存储的事实。因此,节省内存会增加延迟和资源消耗。
在小型应用程序中,您可以在生成回复后保存对话。在处理多个并发请求的服务中,最好使用 异步内存后台工作进程或任务队列。
Mem0 提供异步接口,以避免阻塞使用 Mem0 构建的应用程序。 asyncio 或 FastAPI:
from mem0 import AsyncMemory

memory = AsyncMemory.from_config(config)

resultado = await memory.search(
    "proyecto actual",
    filters={"user_id": "usuario_001"},
    top_k=5
)

await memory.add(
    mensajes,
    user_id="usuario_001"
)
不要在未处理异常的情况下将任务传递给辅助线程。如果程序在保存完成前关闭,对话可能无法记录。持久队列允许重试失败的操作。
您还可以使用不同的模型进行对话和提取。功能更强大的生成模型可以处理回复,而较小的模型则可以处理记忆。在此之前,请确保第二个模型正确遵循指令并符合所需的格式。
将 Mem0 与 Ollama 连接时常见的错误
Mem0 请求 OpenAI 密钥
配置不完整,部分组件仍在使用默认提供程序。请确认您已配置好所有组件。 llm 作为 embedder 与供应商 ollama.
无法连接到 Ollama
验证 API 是否响应:
curl http://localhost:11434/api/tags如果 Mem0 在 Docker 容器内运行, localhost 这里指的是容器,而不是主机。在 Docker Desktop 中,您可能需要使用:
http://host.docker.internal:11434Qdrant拒绝向量
集合和嵌入模型使用不同的维度。 nomic-embed-text配置 768 个维度,如果现有集合是用不同大小生成的,则创建一个新集合。
搜索结果不会返回记忆
请检查您是否使用了相同的 user_id 在保存和搜索过程中,还要检查嵌入模型名称、过滤器和内容。 resultado["results"].
Mem0 存储无关信息
鸭子 custom_instructions它可以降低温度,并定义要包含或排除的类别。此外,还要检查所选型号是否能够遵循结构化指令。
记忆与最近的信息相矛盾
当前版本可以保留先前的数据,而不是自动覆盖它。添加日期或元数据并使用 update() o delete() 当你需要更正信息时。
当 Qdrant 被替换时,内存会消失。
验证容器是否使用了已挂载的卷。 /qdrant/storage重启容器与删除容器不同,但如果没有持久存储就重新创建容器,可能会导致新部署中缺少数据。
隐私和备份
本地安装避免了强制依赖 Mem0、OpenAI 或其他提供商提供的托管 API。即便如此,您也应该像保护任何存储个人信息的应用程序一样保护基础设施。
- 请勿将 Ollama 或 Qdrant 直接暴露于互联网上。
- 当磁盘和备份包含私人数据时,请对其进行加密。
- 对应用程序应用身份验证和访问控制。
- 使用可靠的用户标识符分隔内存。
- 它允许您查看和删除已存储的信息。
- 不要将密码、API密钥或银行详细信息保存下来作为纪念品。
- 它记录错误,但不包含完整的对话或记忆。
- 检查数据处理是否必须符合GDPR规定。
使用 Qdrant 时,您必须备份卷 qdrant_storage 以及由……定义的文件 history_db_path使用 Chroma 时,您必须将配置的文件夹复制到 path 以及历史数据库。
将 Mem0 与 Ollama 连接,即可创建一个无需依赖外部服务即可在会话间保留信息的助手。Ollama 运行模型,Mem0 提取和检索内存,而 Qdrant 或 Chroma 则提供持久存储。
关键不在于仅仅保存对话。应用程序必须能够检索相关的记忆,提供上下文,使用标识符限制其范围,并提供更正或删除信息的机制。有了这些预防措施,你就可以构建一个有用、持久且可控的本地记忆系统。
指数
