- Mise en place d'un écosystème de mémoire persistante utilisant Ollama comme moteur de raisonnement et embeddings.
- Mise en œuvre de bases de données vectorielles locales utilisant Qdrant ou ChromaDB pour éviter la dépendance au cloud.
- Optimisation de l'extraction de faits par la synchronisation de dimensions vectorielles spécifiques.

Les modèles de langage ne conservent pas automatiquement en mémoire le contenu des conversations précédentes. Lorsque vous fermez une application, changez de session ou supprimez d'anciens messages de la fenêtre de contexte, le modèle perd ces informations.
Une façon de surmonter cette limitation consiste à Connectez Memo avec OllamaOllama exécute localement le modèle génératif et le modèle d'embeddings, tandis que Mem0 extrait les informations utiles des conversations, les organise et permet de les récupérer lorsqu'elles redeviennent pertinentes.
Au lieu d'envoyer systématiquement l'historique complet au modèle, l'application peut récupérer quelques données relatives à la requête en cours et les insérer dans l'invite de commande. Cela réduit la quantité de contexte et permet de conserver les préférences, les objectifs ou les informations importantes d'une session à l'autre.
L'installation peut fonctionner entièrement au sein de votre infrastructure si vous utilisez Ollama, Mem0 OSS et une base de données locale. Cependant, le niveau de confidentialité maximal dépendra de tous les composants connectés. Si vous ajoutez un modèle externe, un système de réévaluation des performances, une base de données ou un service géré, certaines données peuvent quitter votre système.
Que fait Mem0 et quelle est la fonction d'Ollama ?
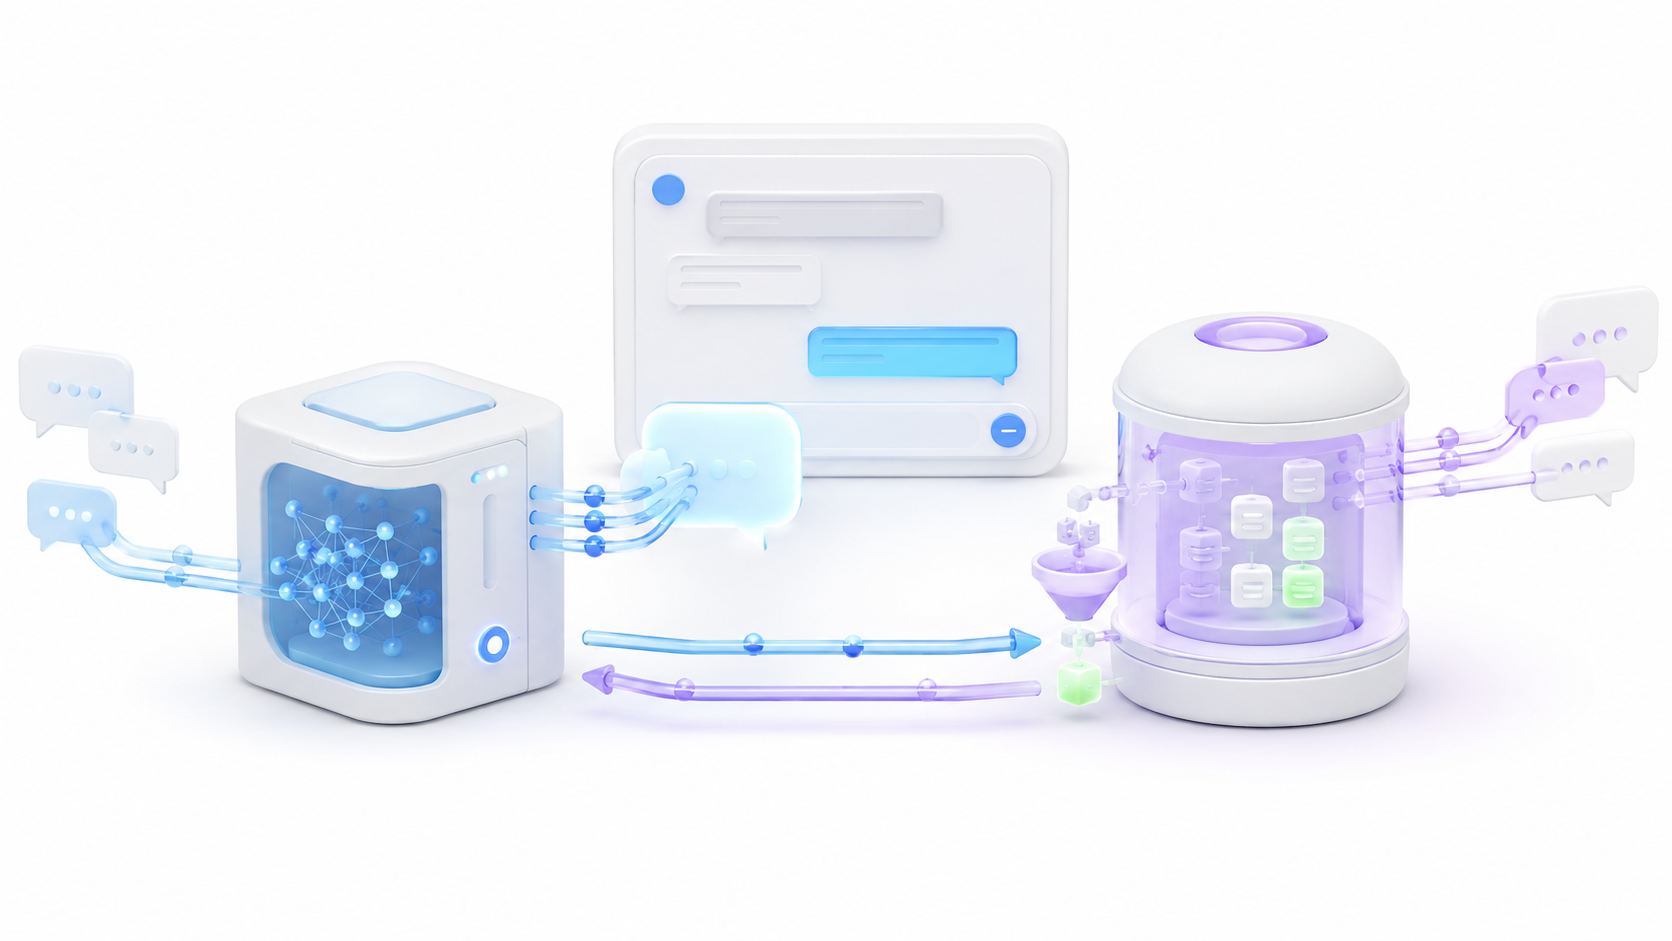
Mem0 et Ollama résolvent des problèmes différents. Ollama est responsable de l'exécution des modèlestandis que Mem0 fournit les opérations nécessaires pour ajouter, rechercher, interroger, mettre à jour et supprimer des mémoires.
Lors de l'enregistrement, Mem0 peut analyser une conversation et en extraire des informations qui pourraient s'avérer utiles ultérieurement. Par exemple :
- L'utilisateur préfère les réponses courtes.
- Il développe une application en Rust.
- Il ne veut pas de recommandations de films d'horreur.
- Leur objectif est de terminer la course en moins de quatre heures.
Mem0 convertit chaque souvenir en une représentation numérique à l'aide du modèle d'embeddings et la stocke avec son contenu et ses métadonnées. Lors d'une recherche, il combine la requête avec des filtres tels que l'identifiant de l'utilisateur et renvoie les souvenirs les plus pertinents.
Les versions actuelles de Mem0 utilisent principalement l'extraction additive. Cela signifie que de nouvelles informations peuvent être stockées sans supprimer automatiquement les données précédentes. Si des données sont devenues obsolètes et doivent être corrigées, l'application peut utiliser explicitement les opérations appropriées. update() o delete().
Mem0 ne remplace pas le modèle conversationnel. L'application doit récupérer les souvenirs, les intégrer au message ou au contexte système, puis demander à Ollama de générer la réponse.
Composants nécessaires pour connecter Mem0 à Ollama
Pour construire un système local, vous avez besoin des composants suivants :
- Note de service OSS : Gère l'extraction, le stockage et la récupération des souvenirs.
- Ollama : Il exécute le modèle génératif et le modèle d'intégration.
- Un modèle de langage : Il interprète les conversations et génère les réponses.
- Un modèle d'intégration : transforme les souvenirs et les requêtes en vecteurs.
- Un entrepôt vectoriel : Il préserve les vecteurs et permet de rechercher des souvenirs associés.
- Une application : Il permet de relier la conversation, la récupération et la sauvegarde de la mémoire.
Qdrant et Chroma sont deux options de stockage courantes :
| Magasin | Utilisation recommandée |
|---|---|
| Qdrant | Services persistants, applications multiples et déploiements utilisant Docker |
| Chroma | Tests locaux et petites applications avec stockage de dossiers |
Qdrant propose une API distincte et facilite la séparation de la base de données vectorielles et de l'application. Chroma peut utiliser une route locale, ce qui simplifie les tests initiaux.
Comment installer Mem0, Ollama et Qdrant
Commencez par installer Ollama et vérifiez que le service est en cours d'exécution. Ensuite, téléchargez un modèle de langage et un modèle d'embeddings :
ollama pull llama3.1:latest
ollama pull nomic-embed-text:latest
llama3.1:latest Il s'agit du modèle utilisé dans l'exemple officiel de Mem0, mais vous pouvez le remplacer par un autre modèle pédagogique compatible avec Ollama. Les modèles plus petits consomment moins de mémoire, mais peuvent extraire les données avec moins de précision ou moins bien respecter le format attendu.
Installez les dépendances Python :
pip install mem0ai qdrant-client openai ollamaPour exécuter Qdrant dans Docker et préserver les données à l'aide d'un volume, utilisez :
docker volume create qdrant_storage

docker run -d \
  --name qdrant \
  -p 6333:6333 \
  -p 6334:6334 \
  -v qdrant_storage:/qdrant/storage \
  qdrant/qdrant
Le port 6333 fournit l'API HTTP et le 6334 Il est utilisé pour gRPC. Dans cet exemple, Mem0 se connecte via l'API HTTP.
Vérifiez qu'Ollama réponde :
curl http://localhost:11434/api/tagsVous pouvez vérifier Qdrant en ouvrant :
http://localhost:6333/dashboardN’exposez pas ces ports directement sur Internet. Si les services sont exécutés sur des ordinateurs différents, utilisez un réseau privé, un VPN ou des règles de pare-feu n’autorisant que les connexions nécessaires.
Configuration locale de Mem0 avec Ollama et Qdrant
La configuration doit indiquer explicitement qu'Ollama sera utilisé comme LLM et comme fournisseur d'embeddings. Elle doit également préciser l'emplacement de Qdrant et les dimensions qui produisent les embeddings.
from mem0 import Memory

OLLAMA_URL = "http://localhost:11434"
CHAT_MODEL = "llama3.1:latest"
EMBEDDING_MODEL = "nomic-embed-text:latest"

config = {
    "vector_store": {
        "provider": "qdrant",
        "config": {
            "collection_name": "memoria_agente",
            "host": "localhost",
            "port": 6333,
            "embedding_model_dims": 768,
        },
    },
    "llm": {
        "provider": "ollama",
        "config": {
            "model": CHAT_MODEL,
            "temperature": 0,
            "max_tokens": 2000,
            "ollama_base_url": OLLAMA_URL,
        },
    },
    "embedder": {
        "provider": "ollama",
        "config": {
            "model": EMBEDDING_MODEL,
            "ollama_base_url": OLLAMA_URL,
        },
    },
    "history_db_path": "./mem0_history.db",
    "custom_instructions": """
    Extrae únicamente información que pueda ser útil en conversaciones futuras:
    - Preferencias estables
    - Objetivos y proyectos
    - Restricciones importantes
    - Decisiones confirmadas

    Ignora saludos, conversación casual y hechos temporales sin importancia.
    Devuelve un objeto JSON con la clave facts y una lista de recuerdos.
    """,
}

memory = Memory.from_config(config)
Memory.from_config() Il force Mem0 à utiliser les fournisseurs spécifiés. Le constructeur Memory() Il ne se connecte pas automatiquement à Mem0 Cloud, mais il peut appliquer des composants par défaut basés sur OpenAI et demander une clé si vous ne les remplacez pas.
custom_instructions Cela vous permet de déterminer quelles informations doivent être stockées. Cette propriété doit être incluse comme propriété de premier niveau avant la création de l'instance. Memory.
Pourquoi les dimensions d'intégration doivent correspondre
Le modèle nomic-embed-text produit des vecteurs de 768 dimensionsPar conséquent, la collection Qdrant est configurée à l'aide de :
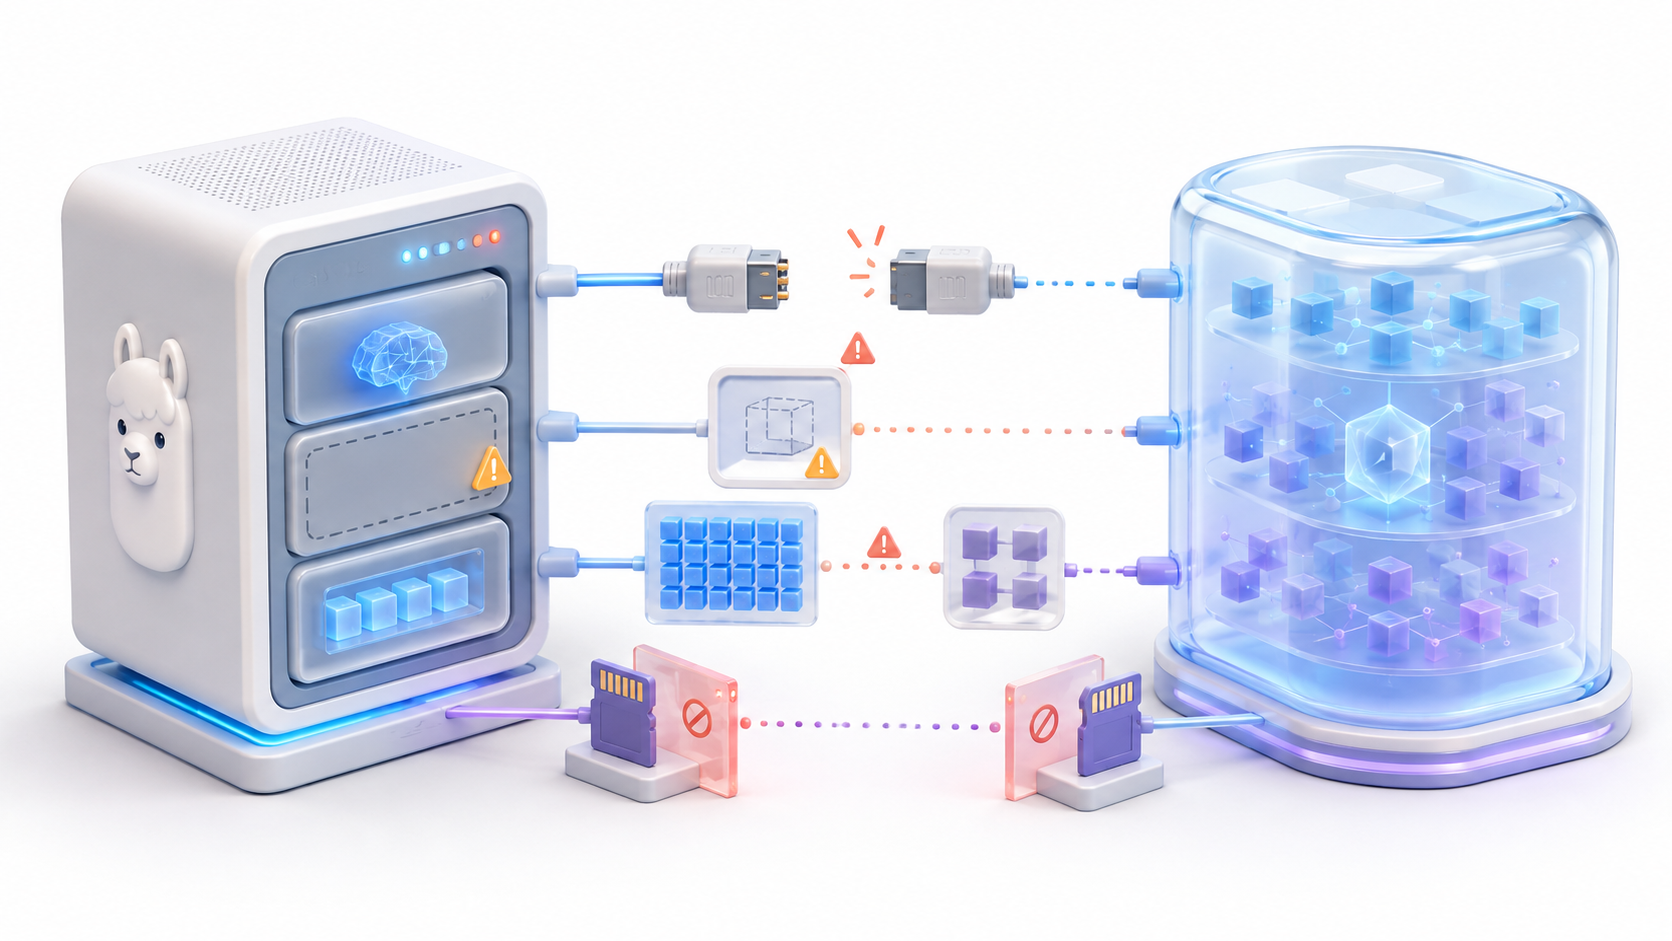
embedding_model_dims=768Si le système attend des vecteurs de taille différente, Qdrant rejettera les données et Mem0 ne pourra pas enregistrer ni interroger correctement les mémoires.
Avant de modifier les paramètres de votre modèle d'intégration, vérifiez ses dimensions. Il se peut également que vous deviez créer une nouvelle collection et régénérer tous les vecteurs existants.
Ne mélangez pas les plongements lexicaux produits par différents modèles au sein d'une même collection. Même si deux modèles génèrent des vecteurs de dimensions identiques, leurs espaces sémantiques peuvent ne pas être compatibles.
Comment sauvegarder et récupérer des souvenirs
Pour sauvegarder une conversation, transmettez une liste de messages à memory.add() et indique un identifiant stable pour l'utilisateur :
mensajes = [
    {
        "role": "user",
        "content": "Estoy desarrollando una aplicación en Rust"
    },
    {
        "role": "assistant",
        "content": "Lo recordaré para adaptar los próximos ejemplos"
    }
]

resultado = memory.add(
    mensajes,
    user_id="usuario_001"
)

print(resultado)
Avec infer=TruePar défaut, Mem0 utilise le modèle pour extraire les mémoires structurées. Si vous souhaitez conserver le contenu sans appliquer cette extraction, vous pouvez utiliser infer=False.
Pour trouver des informations connexes :
recuerdos = memory.search(
    "¿Qué lenguaje utiliza en su proyecto?",
    filters={"user_id": "usuario_001"},
    top_k=5
)

for recuerdo in recuerdos["results"]:
    print(recuerdo["memory"])
Le filtre par user_id C'est crucial. Si une application utilisée par plusieurs personnes effectue une recherche sans appliquer correctement l'identifiant, elle pourrait récupérer des souvenirs appartenant à un autre utilisateur.
Vous pouvez également utiliser agent_id séparer la mémoire des différents agents et run_id diviser les conversations, les projets ou les processus spécifiques.
Comment créer une conversation complète avec Ollama et Mem0
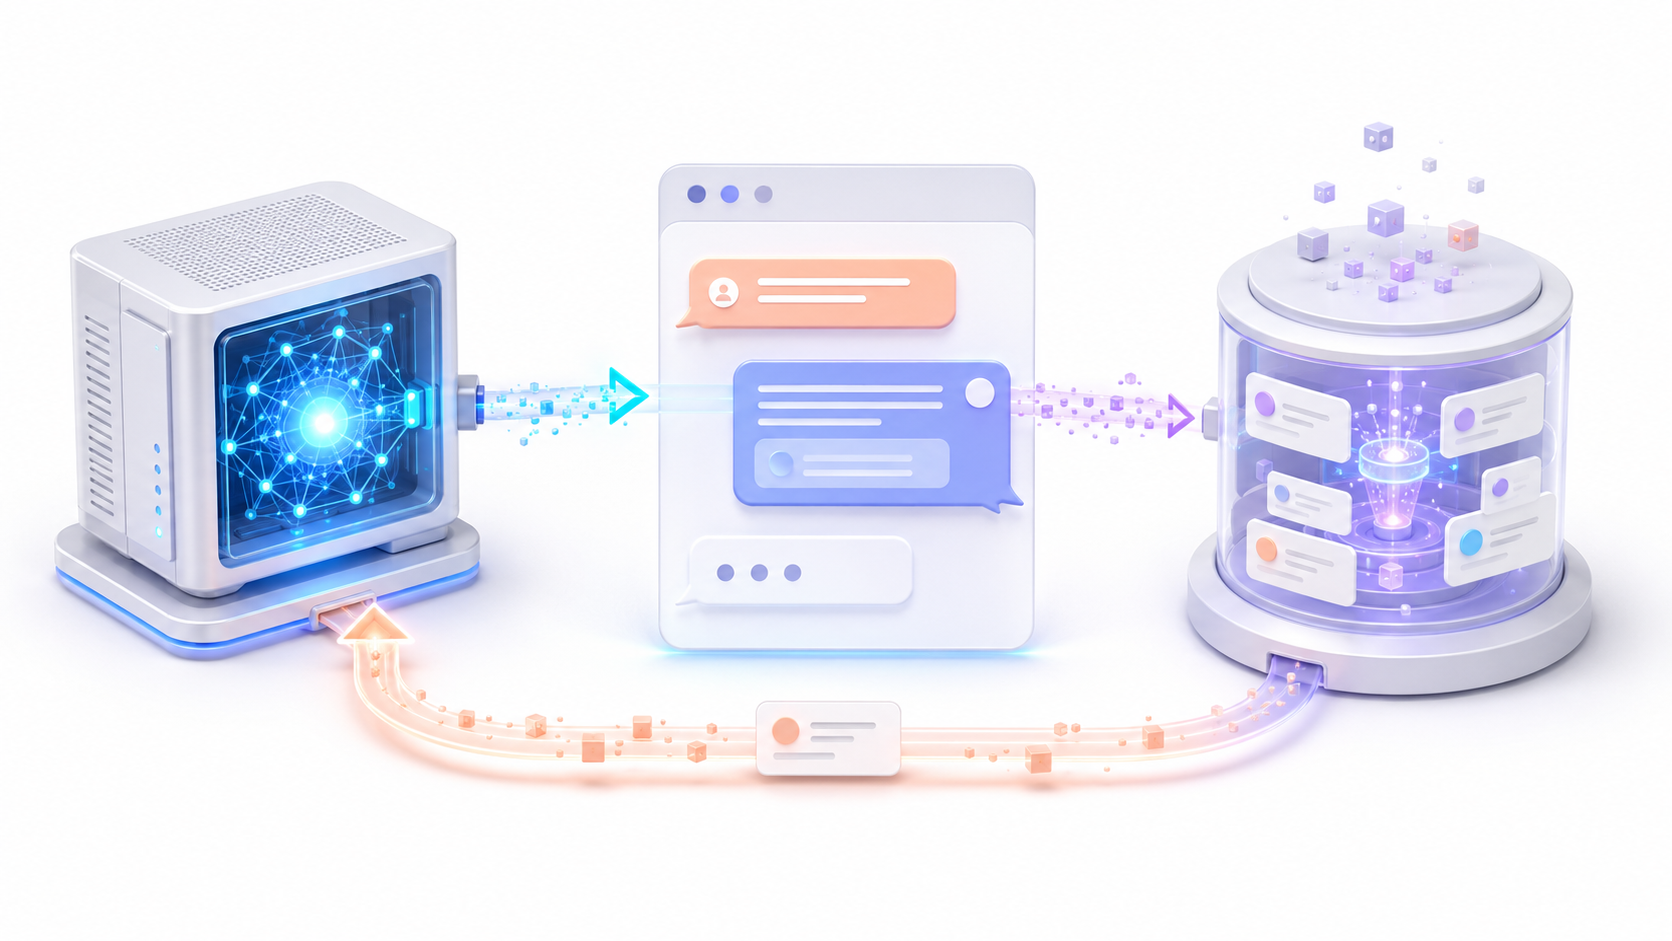
Pour qu'Ollama puisse utiliser les mémoires, l'application doit effectuer quatre étapes :
- Recevoir la question de l'utilisateur.
- Recherchez les souvenirs associés à l'aide de Mem0.
- Ajoutez-les au contexte envoyé à Ollama.
- Enregistrez la question et la réponse comme une nouvelle interaction.
Ollama propose une API compatible avec le format OpenAI. Nous pouvons l'utiliser pour créer la boucle complète :
from openai import OpenAI

ollama_chat = OpenAI(
    base_url=f"{OLLAMA_URL}/v1",
    api_key="ollama"
)

def chat(mensaje_usuario, user_id):
    resultado = memory.search(
        mensaje_usuario,
        filters={"user_id": user_id},
        top_k=5
    )

    recuerdos = [
        item["memory"]
        for item in resultado["results"]
    ]

    contexto = "\n".join(
        f"- {recuerdo}" for recuerdo in recuerdos
    )

    respuesta = ollama_chat.chat.completions.create(
        model=CHAT_MODEL,
        messages=[
            {
                "role": "system",
                "content": (
                    "Eres un asistente útil. Utiliza los recuerdos "
                    "solo cuando sean relevantes.\n\n"
                    f"Recuerdos del usuario:\n{contexto}"
                ),
            },
            {
                "role": "user",
                "content": mensaje_usuario,
            },
        ],
    ).choices[0].message.content

    memory.add(
        [
            {
                "role": "user",
                "content": mensaje_usuario,
            },
            {
                "role": "assistant",
                "content": respuesta,
            },
        ],
        user_id=user_id,
    )

    return respuesta
Vous pouvez maintenant entamer une conversation :
print(
    chat(
        "Estoy creando un programa de escritorio en Rust",
        user_id="usuario_001"
    )
)
Après le redémarrage de l'application, le même utilisateur peut demander :
print(
    chat(
        "¿Qué lenguaje estoy utilizando en mi proyecto?",
        user_id="usuario_001"
    )
)
Si les données ont été correctement stockées, Mem0 récupérera les informations et Ollama pourra les utiliser pour répondre.
Comment utiliser Chroma à la place de Qdrant
Pour un test local à petite échelle, vous pouvez remplacer Qdrant par Chroma. Le nom correct du fournisseur sur Mem0 est chroma:
"vector_store": {
    "provider": "chroma",
    "config": {
        "collection_name": "memoria_agente",
        "path": "./chroma_db",
    },
}
Le dossier indiqué dans path Il contient les données persistantes de Chroma. Vous devez l'inclure dans vos sauvegardes et éviter de le supprimer lors des mises à jour de l'application.
Le package Python utilisé par le projet continue de s'appeler chromadbMais l'identifiant que vous devez écrire dans la configuration Mem0 est chroma.
Comment corriger ou supprimer des souvenirs obsolètes
La mémoire d'un assistant ne doit pas être considérée comme une source infaillible. Le modèle peut contenir des faits mal interprétés, conserver des informations obsolètes ou générer plusieurs souvenirs similaires.
Vous pouvez consulter tous les souvenirs associés à un utilisateur :
resultado = memory.get_all(
    filters={"user_id": "usuario_001"}
)

for recuerdo in resultado["results"]:
    print(recuerdo["id"], recuerdo["memory"])
Pour corriger un souvenir précis :
memory.update(
    memory_id="ID_DEL_RECUERDO",
    data="El usuario está desarrollando una aplicación en Python"
)
Pour le supprimer :
memory.delete(
    memory_id="ID_DEL_RECUERDO"
)
Une application destinée aux utilisateurs finaux doit offrir des commandes permettant de consulter, de corriger et de supprimer les données enregistrées. Il est également conseillé de définir une durée de conservation pour les informations temporaires.
Comment améliorer la qualité des souvenirs
La qualité dépend du modèle, des instructions, de la conversation et de la quantité d'informations transmises. Utiliser systématiquement un modèle plus grand ne garantit pas de meilleurs résultats, tandis que les modèles très petits peuvent manquer des nuances ou renvoyer des formats incorrects.
Ces pratiques contribuent à améliorer la mémoire :
- Utilisez une température basse pour rendre l'extraction plus stable.
- Définissez clairement les catégories qu'il convient de retenir.
- Exclure les salutations, les répétitions et les conversations hors sujet.
- Enregistrez à la fois le message de l'utilisateur et la réponse de l'agent.
- Utilisez des identifiants différents pour les utilisateurs, les agents et les projets.
- Limitez le nombre de souvenirs récupérés afin de ne pas surcharger le contexte.
- Revoyez périodiquement les souvenirs incorrects, en double ou obsolètes.
- Testez les recherches avec de vraies requêtes avant de les mettre en production.
N'utilisez pas les souvenirs comme commandes prioritaires. Considérez-les comme des informations contextuelles potentiellement incomplètes ou obsolètes. Cela réduit le risque qu'un souvenir manipulé altère le comportement global de l'agent.
Optimisation des performances
Chaque appel à memory.add() Vous pouvez exécuter le modèle pour extraire les données à stocker. Par conséquent, l'économie de mémoire augmente la latence et la consommation de ressources.
Dans une petite application, vous pouvez enregistrer la conversation après avoir généré la réponse. Dans les services avec plusieurs requêtes simultanées, il est préférable d'utiliser Mémoire asynchroneun processus en arrière-plan ou une file d'attente de tâches.
Mem0 fournit une interface asynchrone pour éviter de bloquer les applications construites avec asyncio ou FastAPI :
from mem0 import AsyncMemory

memory = AsyncMemory.from_config(config)

resultado = await memory.search(
    "proyecto actual",
    filters={"user_id": "usuario_001"},
    top_k=5
)

await memory.add(
    mensajes,
    user_id="usuario_001"
)
Ne transférez pas la tâche à un thread secondaire sans gérer ses exceptions. Si le programme se ferme avant la fin de l'enregistrement, la conversation risque de ne pas être enregistrée. Une file d'attente persistante permet de relancer les opérations ayant échoué.
Vous pouvez également utiliser différents modèles pour la conversation et l'extraction. Un modèle génératif plus puissant peut traiter les réponses, tandis qu'un modèle plus simple gère la mémoire. Avant cela, vérifiez que le second modèle respecte correctement les instructions et le format requis.
Erreurs courantes lors de la connexion de Mem0 à Ollama
Mem0 demande une clé OpenAI
La configuration est incomplète et certains composants utilisent encore leur fournisseur par défaut. Veuillez vérifier que vous avez bien configuré les deux llm comme embedder avec le fournisseur ollama.
Impossible de se connecter à Ollama
Vérifiez que l'API répond :
curl http://localhost:11434/api/tagsSi Mem0 s'exécute dans Docker, localhost Cela concerne le conteneur, et non l'ordinateur hôte. Dans Docker Desktop, vous devrez peut-être utiliser :
http://host.docker.internal:11434Qdrant rejette les vecteurs
La collection et le modèle d'intégration utilisent des dimensions différentes. nomic-embed-text, configure 768 dimensions et crée une nouvelle collection si celle existante a été générée avec une taille différente.
Les recherches ne permettent pas de retrouver les souvenirs
Vérifiez que vous utilisez le même user_id lors de l'enregistrement et de la recherche. Vérifiez également le nom du modèle d'intégration, les filtres et le contenu de resultado["results"].
Mem0 stocke des informations non pertinentes
Canard custom_instructionsIl permet de réduire la température et de définir les catégories à inclure ou à exclure. Vérifiez également si le modèle choisi est capable de suivre des instructions structurées.
Les souvenirs contredisent les informations plus récentes
Les versions actuelles peuvent conserver les données précédentes au lieu de les écraser automatiquement. Ajoutez des dates ou des métadonnées et utilisez-les. update() o delete() lorsque vous devez corriger des informations.
La mémoire disparaît lorsque Qdrant est remplacé.
Vérifiez que le conteneur utilise un volume monté dans /qdrant/storageRedémarrer un conteneur n'est pas la même chose que le supprimer, mais le recréer sans stockage persistant peut entraîner la perte de données lors du nouveau déploiement.
Confidentialité et sauvegardes
Une installation locale évite de dépendre des API gérées par Mem0, OpenAI ou d'autres fournisseurs. Toutefois, il est important de protéger l'infrastructure comme pour toute application stockant des données personnelles.
- Ne pas exposer Ollama ou Qdrant directement sur Internet.
- Chiffrez les disques et les sauvegardes lorsqu'ils contiennent des données privées.
- Appliquer des contrôles d'authentification et d'accès à l'application.
- Séparer les mémoires à l'aide d'identifiants utilisateur fiables.
- Il vous permet de consulter et de supprimer les informations enregistrées.
- Ne conservez pas vos mots de passe, clés API ou coordonnées bancaires comme souvenirs.
- Il enregistre les erreurs sans inclure les conversations complètes ni les souvenirs.
- Vérifiez si le traitement des données doit être conforme au RGPD.
Avec Qdrant, vous devez sauvegarder le volume. qdrant_storage et le fichier défini par history_db_pathAvec Chroma, vous devez copier le dossier configuré dans path et la base de données historiques.
L'association de Mem0 à Ollama permet de créer un assistant qui conserve les informations entre les sessions sans nécessairement dépendre de services externes. Ollama exécute les modèles, Mem0 extrait et récupère les données en mémoire, et Qdrant ou Chroma assure le stockage persistant.
L'essentiel ne réside pas simplement dans la sauvegarde des conversations. L'application doit récupérer les souvenirs pertinents, fournir un contexte, limiter leur portée à l'aide d'identifiants et proposer des mécanismes pour corriger ou supprimer les informations. Grâce à ces précautions, vous pouvez créer une mémoire locale utile, persistante et contrôlable.
Indice
- 1 Que fait Mem0 et quelle est la fonction d'Ollama ?
- 2 Composants nécessaires pour connecter Mem0 à Ollama
- 3 Comment installer Mem0, Ollama et Qdrant
- 4 Configuration locale de Mem0 avec Ollama et Qdrant
- 5 Pourquoi les dimensions d'intégration doivent correspondre
- 6 Comment sauvegarder et récupérer des souvenirs
- 7 Comment créer une conversation complète avec Ollama et Mem0
- 8 Comment utiliser Chroma à la place de Qdrant
- 9 Comment corriger ou supprimer des souvenirs obsolètes
- 10 Comment améliorer la qualité des souvenirs
- 11 Optimisation des performances
- 12 Erreurs courantes lors de la connexion de Mem0 à Ollama
- 12.1 Mem0 demande une clé OpenAI
- 12.2 Impossible de se connecter à Ollama
- 12.3 Qdrant rejette les vecteurs
- 12.4 Les recherches ne permettent pas de retrouver les souvenirs
- 12.5 Mem0 stocke des informations non pertinentes
- 12.6 Les souvenirs contredisent les informations plus récentes
- 12.7 La mémoire disparaît lorsque Qdrant est remplacé.
- 13 Confidentialité et sauvegardes
