- La memoria VRAM de la tarjeta gráfica es el factor determinante para la velocidad y la capacidad de ejecutar modelos grandes.
- La RAM del sistema actúa como respaldo crítico cuando el modelo excede la capacidad de la GPU, evitando el colapso del sistema.
- Existen tres niveles de hardware según el uso: desde equipos básicos para texto hasta estaciones de trabajo profesionales para modelos masivos y generación visual.
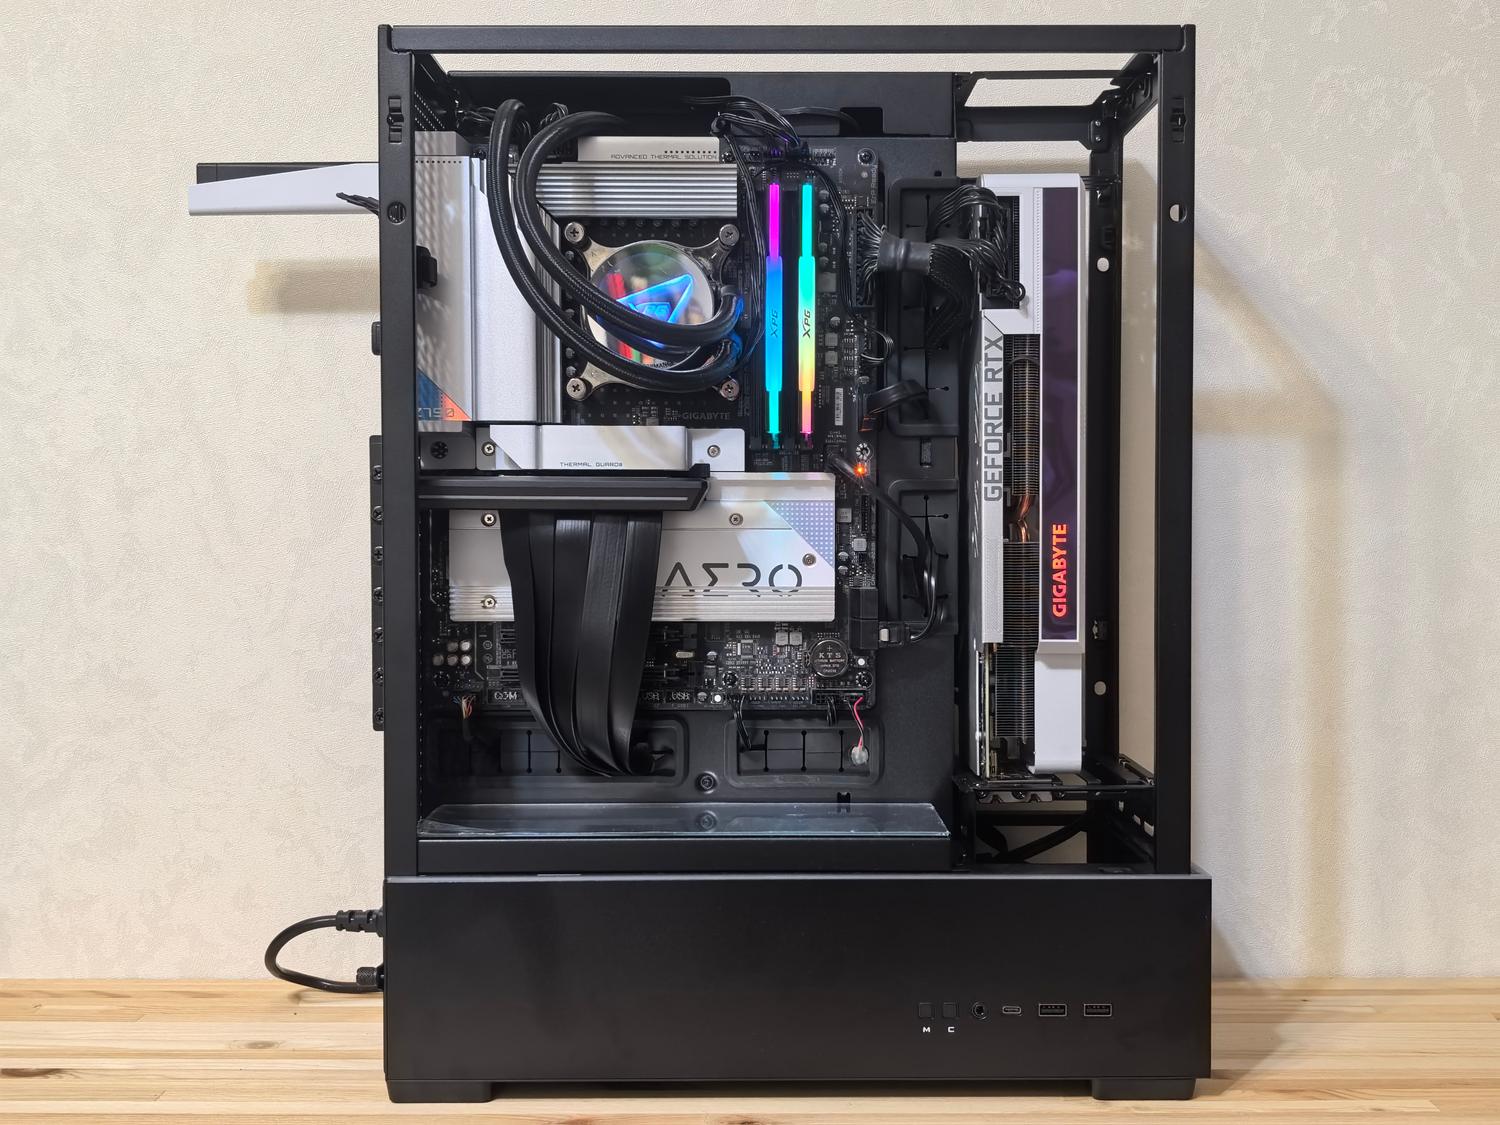
Seguramente te has dado cuenta de que la inteligencia artificial ya no es cosa solo de los servidores gigantes de OpenAI o Google. Ahora, gracias a los modelos abiertos, puedes montar tu propio cerebro digital en el salón de tu casa. Ejecutar un LLM en local significa que todo el procesamiento ocurre en tu hardware, sin que ni una sola palabra de tus prompts salga volando hacia un servidor externo. Esto no es solo un capricho de informáticos, sino una opción totalmente viable para quien busca privacidad absoluta, control total y olvidarse de las suscripciones mensuales.
Pero aquí es donde viene el dolor de cabeza: ¿qué demonios hay que comprar? No es como montar un PC para jugar al Fortnite. En la IA, las reglas cambian y la memoria manda por encima de todo. Si te equivocas al elegir los componentes, puedes acabar con una máquina que tarda un siglo en responder o que simplemente se cierra porque el modelo no cabe en la memoria. Para que no tires el dinero, vamos a desgranar qué piezas son realmente críticas y cómo configurar tu equipo según lo que quieras hacer.
¿Por qué molestarse en ejecutar IA en local?
La pregunta del millón es por qué hacer esto cuando tienes ChatGPT a un clic. La respuesta se resume en tres pilares: privacidad, coste y control. Para un abogado que maneja contratos confidenciales o un desarrollador con código propietario, mandar datos a una API externa es un riesgo legal inaceptable. Al correr la IA en local, el dato nunca sale del perímetro de tu ordenador, eliminando cualquier riesgo de filtraciones.
En cuanto al bolsillo, aunque la inversión inicial en hardware sea fuerte, el coste por token es cero. Te olvidas de las facturas crecientes por uso intensivo; solo pagas la luz que consuma tu equipo. Además, tienes la libertad de experimentar con modelos cuantizados y versiones modificadas que las empresas de la nube no te permiten tocar, funcionando incluso sin conexión a internet.
El hardware: donde se decide la batalla
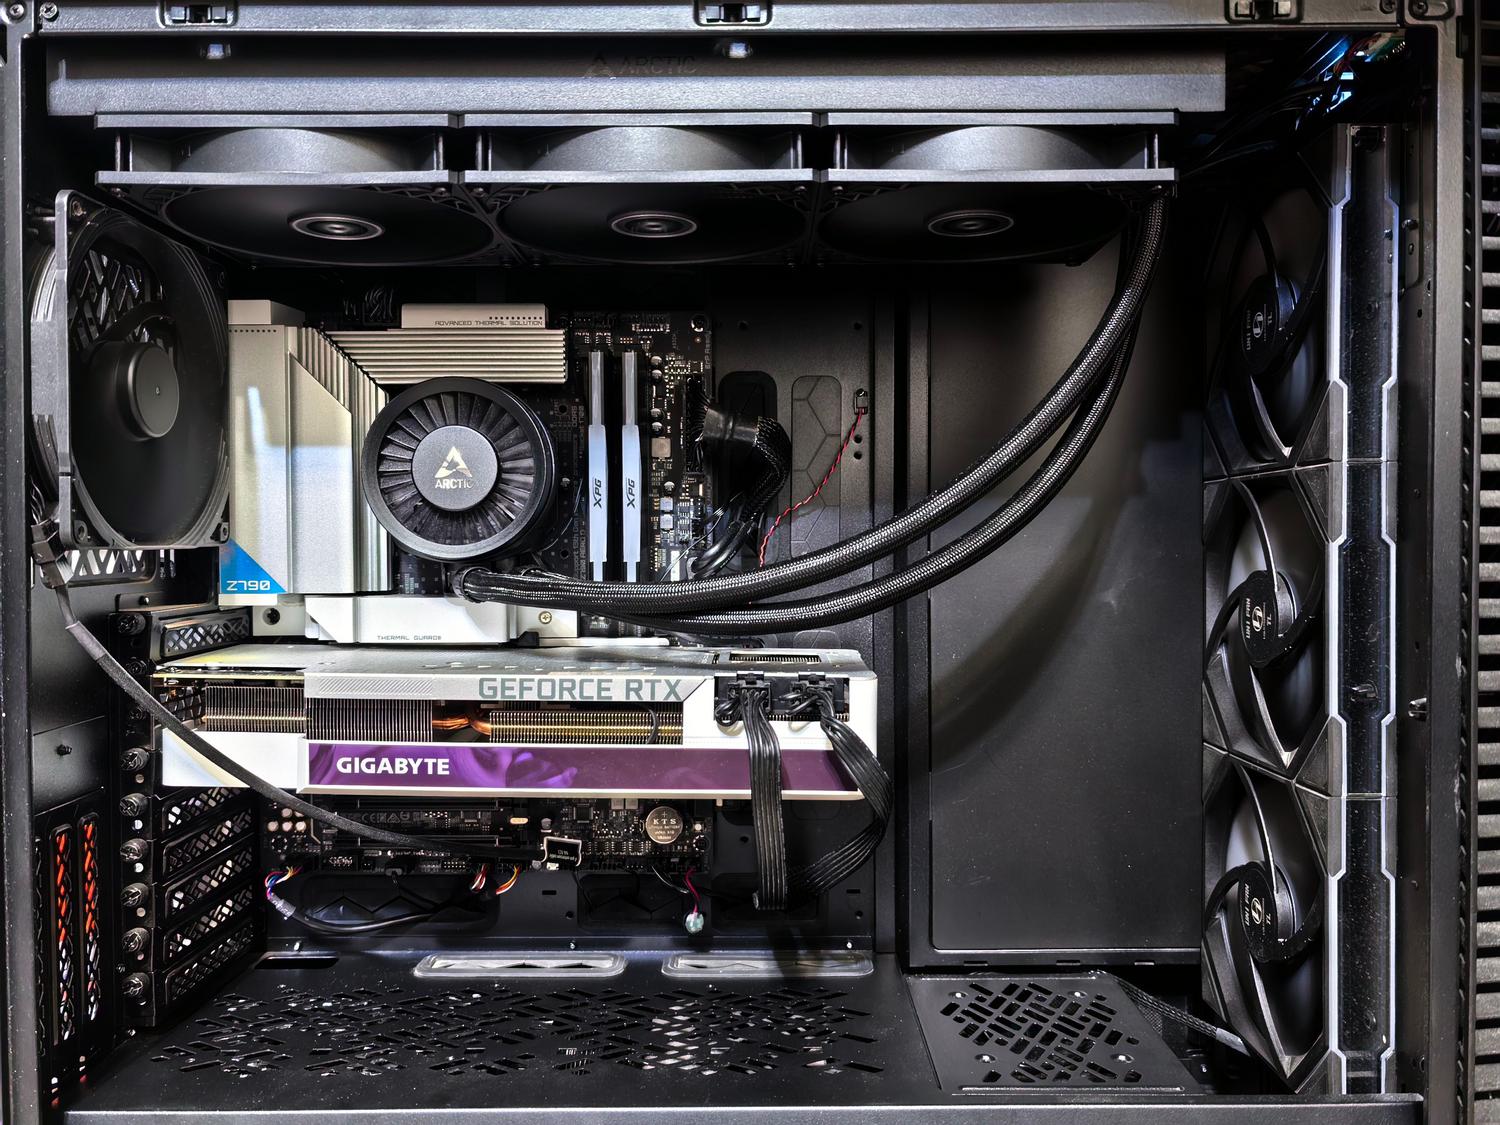
Si hay algo que tienes que grabar a fuego es que la VRAM de la GPU es el cuello de botella. La VRAM es la memoria ultrarrápida de la tarjeta gráfica donde se aloja el modelo. Si el modelo cabe entero ahí, la velocidad de generación será fluida (más de 50 tokens por segundo). Si no cabe, el sistema hace un offload parcial a la RAM del sistema, y ahí es donde el rendimiento cae en picado porque el bus PCIe es mucho más lento.
La importancia de la GPU y la VRAM
Para la mayoría de los usuarios, NVIDIA es la opción más segura debido al ecosistema CUDA, que es el estándar en casi todas las librerías de IA como PyTorch. Dependiendo del tamaño del modelo (medido en parámetros, como 7B o 70B), necesitarás distintas capacidades:
- Nivel Básico (Modelos 7B-8B): Necesitas al menos 8-12 GB de VRAM. Una RTX 3060 de 12GB o una RTX 5060 son puntos de entrada magníficos.
- Nivel Intermedio (Modelos 13B-34B): Aquí ya hablamos de 16-24 GB de VRAM. Una RTX 4090 o 5090 permite mover estos modelos con soltura y un razonamiento mucho más profundo.
- Nivel Profesional (Modelos 70B+): Entramos en terreno de 48 GB de VRAM o más. Esto requiere configuraciones multi-GPU (varias tarjetas sumando memoria) o tarjetas profesionales de la serie RTX PRO.
RAM, SSD y la nueva NPU
Aunque la GPU es la estrella, el resto no puede ser un lastre. 32 GB de RAM es el estándar mínimo para no sufrir. Si planeas usar modelos grandes que no caben en la gráfica, saltar a los 64 GB o 128 GB es lo más inteligente. En cuanto al almacenamiento, un SSD NVMe Gen 4 o 5 es obligatorio; cargar un modelo de 30 GB desde un disco mecánico es una tortura que puede tardar minutos en lugar de segundos.
También han aparecido los Copilot+ PC con NPU (Unidades de Procesamiento Neuronal). Estos chips son geniales para tareas ligeras en segundo plano, como desenfocar el fondo de una videollamada o usar asistentes básicos de Windows sin fundir la batería, pero no sustituyen a la GPU cuando quieres generar imágenes pesadas o correr un LLM complejo.
Configuraciones según el uso previsto
No todo el mundo necesita un superordenador. Dependiendo de si buscas solo texto, imágenes o un laboratorio completo, los requisitos varían:
1. Solo Texto (LLMs Locales)
Si tu objetivo es chatear, resumir textos o programar, puedes permitirte ser más flexible. Un Mac con Apple Silicon (M3/M4) es una opción brutal gracias a su memoria unificada, donde la GPU usa la RAM del sistema directamente. En Windows, con una RTX de 12 GB y 32 GB de RAM vas sobrado para modelos de 7B-8B. Si quieres algo más potente pero barato, los Mini PCs con Ryzen y RAM ampliable son una alternativa interesante para montar servidores domésticos.
2. Texto + Generación de Imágenes (Stable Diffusion, FLUX)
Aquí la cosa cambia. La generación visual es hambrienta de VRAM. Para no pelearte con los errores de «Out of Memory», no bajes de los 16 GB de VRAM. El flujo de trabajo con herramientas como ComfyUI requiere que los pesos del modelo y las imágenes se procesen rápido. Una RTX 4080 o 5080 es el punto dulce para quien quiere calidad profesional sin gastar lo que cuesta un coche.
3. Uso Profesional y Agentes de IA
Para quienes montan agentes que interactúan entre sí o hacen fine-tuning (ajuste fino) de modelos, la estabilidad es la clave. Necesitas estaciones de trabajo con refrigeración líquida y fuentes de alimentación de 1000W o más, ya que la GPU estará al 100% durante horas. En este nivel, se recomienda mirar superordenadores de escritorio con memoria unificada masiva (como los basados en chips GB10) que permiten mover modelos de hasta 200 mil millones de parámetros.
Herramientas esenciales para empezar
Tener el hardware es solo la mitad del camino. Para ponerlo a funcionar sin volverte loco con la terminal, existen aplicaciones muy pulidas. Ollama es el motor ideal; es ligero, rápido y crea un servidor local que otras apps pueden usar. Si prefieres algo visual, LM Studio es la joya de la corona, permitiéndote descargar modelos de HuggingFace y configurarlos con un par de clics.
Para integrar todo en tu flujo diario, existen clientes como Levante o Cherry Studio, que permiten alternar entre un modelo local (para datos privados) y uno en la nube (para razonamiento ultra complejo) en el mismo chat. Esto te da lo mejor de los dos mundos: la potencia de la nube y la seguridad del local.
Elegir el equipo adecuado depende totalmente de si priorizas la movilidad de un portátil con NPU, la versatilidad de una torre NVIDIA o la eficiencia de un Mac. Lo fundamental es no escatimar en la VRAM de la tarjeta gráfica y la capacidad de la RAM, ya que son los únicos componentes que determinarán si tu IA es un asistente fluido o un ancla que ralentiza todo tu sistema. Ahora ya sabes ¿qué PC necesito para ejecutar modelos de IA localmente en Windows? (Guía de Requisitos)

Apasionado de la tecnología desde pequeñito. Me encanta estar a la última en el sector y sobre todo, comunicarlo. Por eso me dedico a la comunicación en webs de tecnología y videojuegos desde hace ya muchos años. Podrás encontrarme escribiendo sobre Android, Windows, MacOS, iOS, Nintendo o cualquier otro tema relacionado que se te pase por la cabeza.